B站让百款大模型真刀真枪
B站上线“AI 无限竞技场”,以UP主设计的真实任务为百余款大模型动态排位。GPT-6 Astra暂居首位,但这份榜单的真正价值,不是选出唯一冠军,而是补上中文真实场景评测的缺口。
B站把大模型测评做成了一档长期擂台赛
B站于9月16日正式上线“AI 无限竞技场”,并在本周公布首轮大模型测评榜单。按照首期收录的10位UP主测评结果,GPT-6 Astra获得单项榜首的次数最多,暂时排在第一;GLM-5.3紧随其后,前五名中则有3款国产大模型。
**AI 无限竞技场是一个聚合B站UP主真实场景测试、并据此动态展示大模型表现的内容型评测平台。**它并不围绕一套固定题库给模型计算统一分数,而是让代码、知识、推理、创作及垂直行业UP主自行设计任务,再把不同模型放进同一场景中比较。
首期覆盖的产品和模型品牌包括DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、腾讯混元和MiniMax等。B站将其称为“全球百大模型同场竞技”,榜单后续会随着新测试加入实时更新,并持续面向全站UP主开放报名。
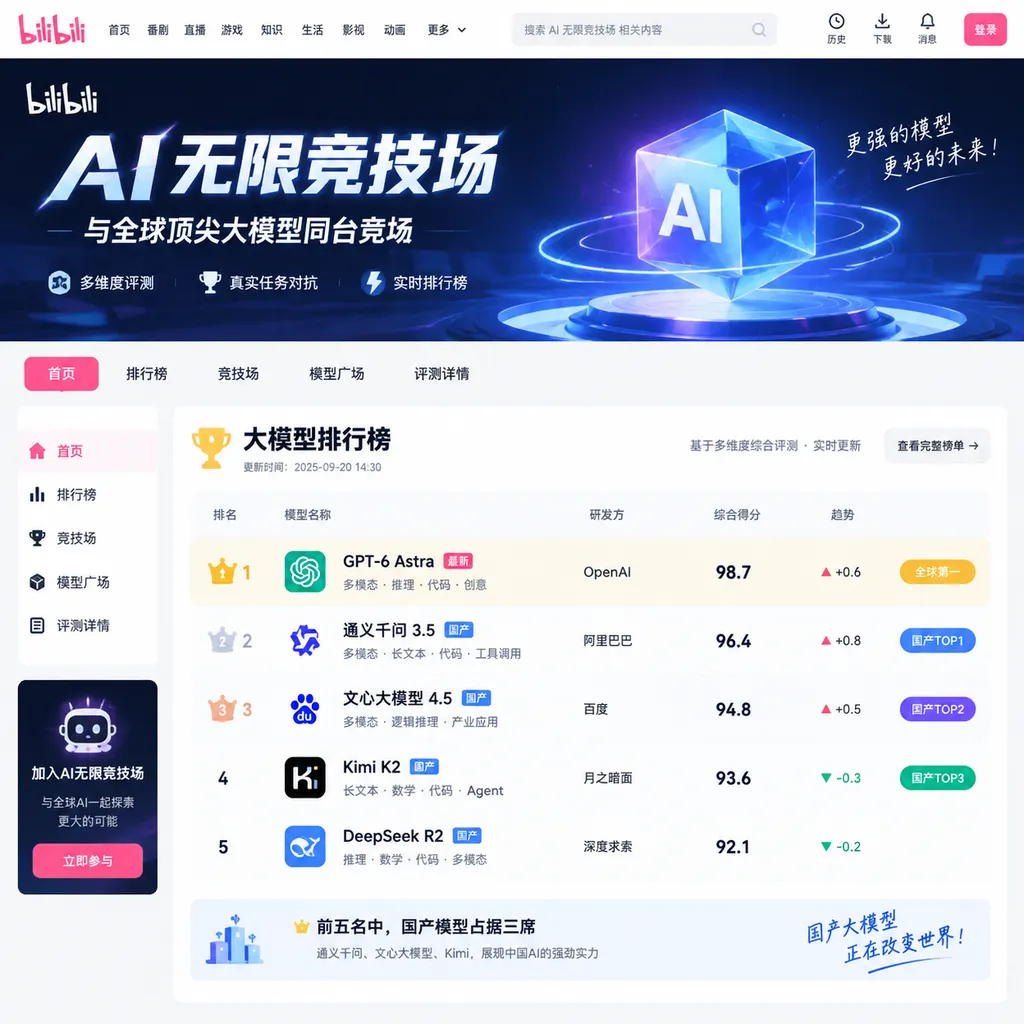
这件事表面上是B站把站内已经存在的大模型横评视频集中到一个页面,实际上是在尝试建立一套区别于传统Benchmark和用户盲投榜单的第三种评价体系:由专业创作者出题,以完整作品和真实工作流作为证据。
GPT-6 Astra第一,但不能简单理解成“综合能力全球第一”
GPT-6 Astra拿到首轮第一,只能说明它在目前收录的10位UP主测试中获得了最多的单项榜首,不能直接推导出它在所有任务上都是最强模型。B站目前公布的是一个由不同创作者、不同场景和不同评价方法共同组成的聚合榜单,而不是实验条件完全一致的标准化考试。
**“榜首次数”是统计模型在多个独立测评中获得第一名次数的指标。**这个指标足够直观,适合帮助用户快速识别经常胜出的模型,但它没有完整表达每次胜出的幅度、测试难度、任务权重以及失败项目的严重程度。
举例来说,一个模型如果在5个简单任务中获得第一,却在一个复杂的软件工程任务中完全失败,其榜首次数可能仍然很好看;另一个模型虽然没有多次拿第一,但在所有项目里都稳定排在第二,也可能更适合作为生产环境中的默认选择。
因此,B站榜单最合理的阅读方式不是只看总排名,而是继续点进UP主的完整测试内容,观察模型在哪些任务中领先、用了多长时间、是否需要人工纠错,以及最终结果能不能真正交付。
GPT-6 Astra这个名称目前也应严格放在B站榜单语境下理解。参考资料没有给出这款模型的官方技术报告、参数规模、上下文长度、推理成本和标准基准成绩,因此现阶段不宜仅凭首轮排名,对其底层能力作超出测试范围的判断。
这不是传统跑分,也不是简单的网友投票
传统大模型Benchmark是一组题目、评价规则和运行条件相对固定的标准化测试,优势是可重复、方便横向比较,缺点是容易被训练数据污染,也可能与用户每天真正处理的任务脱节。模型在数学选择题上多拿几分,并不意味着它一定能看懂公司的遗留代码、整理一份混乱会议纪要,或者完成包含多轮修改的设计需求。
用户偏好竞技场则是让使用者匿名比较两个模型的回答,再根据胜负关系计算排名。它更接近普通用户的主观体验,却可能受到回答长度、语气、排版和“讨喜程度”影响;参与者如果没有认真核验事实,也可能把表达更自信但内容错误的答案选为优胜者。
B站的方案处在两者之间:它保留了真实用户需求,又把测试门槛提高到“需要制作一份公开作品”。UP主不仅要给出结论,还要展示任务、过程和结果,观众则可以通过视频、评论与弹幕继续质疑测试方法。
| 评测方式 | 题目来源 | 主要评价者 | 优势 | 主要局限 | |---|---|---|---|---| | 传统Benchmark | 固定题库或专家题库 | 自动评分器、专家 | 条件统一,可重复验证,适合观察基础能力变化 | 可能出现数据污染,容易被定向优化,与真实工作流存在距离 | | 匿名偏好竞技场 | 用户即时输入 | 普通用户盲选 | 样本量可以迅速扩大,能够反映主观使用偏好 | 投票质量不稳定,容易偏爱更长、更顺滑或更讨喜的回答 | | B站AI无限竞技场 | UP主自主设计 | 垂直创作者及社区 | 场景具体,过程可观看,中文本地需求更丰富 | 题目和评分不统一,样本量较小,创作者影响力可能干扰传播 |
**B站AI无限竞技场的核心差异是把“模型回答得怎么样”扩展成“模型能不能完成一件事”。**这对已经进入智能体和复杂工作流阶段的大模型尤其重要,因为模型的实际体验不仅取决于一次回答是否正确,还取决于任务拆解、工具调用、长上下文保持、错误恢复以及多轮协作能力。
UP主自主命题,让中文互联网的“怪题”成为有效样本
UP主自主命题看似不够严谨,却可能是这套体系最有价值的部分。参考资料提到,站内测试不局限于网页开发、代码修复等常见场景,还出现了建模、麻将、婚恋匹配以及影视作品暗号识别等任务。
这些题目很难进入传统基准测试,却与中文用户的文化背景、表达习惯和实际需求密切相关。一个在英文知识问答中表现优秀的模型,未必能理解中文社区中的谐音、反讽、方言、网络梗和作品背景;一个代码基准分数很高的模型,也未必能顺利接手包含中文注释、历史依赖和模糊需求的真实项目。
**真实场景评测是把模型放进接近用户实际工作或生活的任务中,观察其端到端完成质量的测试方法。**它关心的不只是最终答案,还包括模型是否正确理解需求、是否会在信息不足时追问、能否持续遵守约束,以及出错后能否自行修正。
这也解释了为什么B站榜单与其他国际榜单可能出现明显差异。不同社区使用不同语言、软件生态和文化语境,用户对“好模型”的定义自然不会完全相同;对中文用户来说,能否读懂本地文档、处理中文表格、理解国内产品逻辑,往往比某项英文考试高出两分更重要。
前五名中国产模型占据3席,至少说明国产模型在这些中文真实任务中已经具备较强竞争力。不过,这个结果仍然受首期样本规模限制:目前公开信息只提到10位UP主,测试主题、模型版本和评价标准也没有完全统一,现阶段更适合作为能力线索,而不是最终结论。
B站的优势不是评测技术,而是内容生产与公开复核
B站做大模型榜单的最大筹码不是拥有一套更先进的评分算法,而是拥有数量庞大、专业背景各异的内容创作者。过去一年,B站AI知识内容消费时长同比增长72%,月均观看AI内容的用户超过1.9亿,这意味着平台已经积累了足够大的观看需求和潜在评测供给。
**内容型评测是以视频、直播或图文作品完整展示测试过程,而不是只公布最终分数的评测形式。**这种形式的好处是结果更容易被复核:观众可以查看提示词、输入材料、模型输出和UP主的操作过程,也可以在评论区指出遗漏条件、错误结论或不公平设置。
视频和直播还适合呈现传统表格难以表达的问题。模型卡顿了多久、是否反复修改同一个错误、生成界面能不能实际运行、语音交互是否自然,这些体验如果只压缩成一个分数,往往会损失大量信息。
B站也能从这项产品中获得直接收益。统一榜单为分散的大模型测评内容提供了长期入口,UP主得到新的选题、流量和品牌合作空间,用户则可以从排行榜继续进入具体视频。相比一次性的新品发布报道,这类页面有机会随着模型更新持续获得访问量。
更重要的是,动态榜单可以为快速迭代的模型市场建立一份社区档案。今天领先的模型可能在数周后被新版产品超过,旧模型也可能因为服务调整、上下文缩水或输出风格变化而掉队;如果测试记录、模型版本和发布日期保存完整,榜单就能呈现模型能力变化,而不只是展示一个瞬时名次。
真正的难题是如何避免榜单被流量和厂商影响
B站模式的第一项风险是测试条件不统一。不同UP主可能使用网页端、客户端或其他官方入口,模型的系统提示、推理档位、联网状态、上下文长度和产品版本都可能不同;如果这些信息没有明确标注,同名模型之间也未必具备可比性。
B站模式的第二项风险是主观评分权重过大。创作、协作和趣味任务本来就很难用唯一答案评分,如果没有提前公布标准,UP主可能在看到输出后临时调整判断,从而放大个人偏好。
B站模式的第三项风险是商业关系不透明。大模型厂商有动力邀请头部创作者参与测试,也可能通过提前提供产品权限、设备或合作机会影响内容选择;平台若希望榜单长期具备公信力,至少应标注商业合作、模型提供方和测试账号来源。
B站模式的第四项风险是排行榜可能反向诱导模型厂商针对热门题型优化。当某些UP主的测试拥有巨大传播量后,厂商完全可能研究其偏好并进行专项适配,最终让真实场景评测重新变成另一种“刷榜”。
要让AI无限竞技场从内容专题成长为可信评测基础设施,B站还需要补充一套最低限度的方法规范:
- 明确记录模型完整名称、版本、测试日期和使用入口;
- 标注联网搜索、深度推理、工具调用及上下文设置;
- 尽量公开提示词、输入文件、原始输出和失败案例;
- 区分客观任务与主观任务,并提前公布评分规则;
- 披露UP主与模型厂商之间的合作、赞助或产品体验关系;
- 同时展示榜首次数、参赛次数、平均名次和失败率,避免只用单一指标定胜负;
- 为同一任务保留复测机制,降低偶然输出对排名的影响。
这些规则不会抹掉UP主测评的个性,反而可以让“整活”更有参考价值。一个麻将测试可以很有趣,但需要说明规则、局面和判定方式;一次代码挑战可以很接近生产环境,但也应该公布项目规模、依赖版本和验收标准。
这份榜单最有价值的部分,不是第一名
AI无限竞技场目前还不能取代标准Benchmark,也不应该被包装成判断模型强弱的唯一尺度。首期只有10位UP主参与,任务权重、模型覆盖率和复测机制仍不清晰,把GPT-6 Astra的暂时领先直接解读成“全球最强”并不严谨。
但B站确实抓住了大模型评测正在发生的一次转向:用户越来越不关心模型在抽象题库里多拿了几分,而是关心它能不能接住真实需求。代码能否运行、文案是否需要大改、复杂指令会不会半途遗忘,这些问题比单一跑分更接近购买订阅和选择生产工具时的决策依据。
对开发者而言,这份榜单适合用来发现值得复测的模型,而不是直接替代自己的选型流程。真正决定模型是否适合项目的,仍然是业务数据、延迟、稳定性、成本、合规要求和失败容忍度;UP主的视频可以帮你缩小候选范围,却不能替你完成验收。
对模型厂商而言,B站榜单提供了一批更难通过刷题解决的中文需求样本。如果平台能够持续扩大UP主数量,并把测试条件、利益披露和评分规则做得更透明,它有机会成为中文大模型生态中一套有影响力的社区评测体系。
B站这次上线的并不只是一张排行榜,而是一种把模型能力公开展示、讨论和复核的产品机制。GPT-6 Astra今天排在第一当然足够吸睛,但真正值得观察的是:当数百个模型面对越来越多真实、古怪且不可预测的中文任务时,谁能持续完成工作,而不只是偶尔给出一个漂亮答案。
参考来源
- IT之家:B站上线“AI 无限竞技场”LLM测评榜,GPT-6 Astra现居榜首——报道榜单上线时间、首轮排名、参评模型范围,以及B站公布的AI内容消费数据。