Grok Voice 3.0杀入实时语音
SpaceXAI 于 10 月 15 日发布 Grok Voice 3.0,并通过 Voice Agent API 开放。模型主打低于 1 秒延迟,在 Artificial Analysis 语音转语音榜单中得分 86.9,试图把实时语音 Agent 从“能对话”推进到“能办事”。
Grok Voice 3.0杀入实时语音
SpaceXAI 今天发布了 Grok Voice 3.0,并通过 Voice Agent API 开放使用。
这不是一次普通的语音模型升级。Grok Voice 3.0 的核心卖点集中在三个数字上:语音转语音综合榜单得分 86.9、全双工基准得分 97%、端到端延迟低于 1 秒。官方还称,它的调用价格维持上一代水平,为每分钟 0.08 美元,即每小时 4.80 美元。
Grok Voice 3.0 是一款面向实时语音 Agent 的端到端语音转语音模型,能够直接从用户语音中理解意图并生成语音回复,减少传统 ASR、文本大模型、TTS 三段式链路带来的等待和信息损失。
如果这些数据能够在更多真实业务中复现,Grok Voice 3.0 的意义不只是“声音更自然”,而是它开始正面挑战客服、车载助手和电话销售中最关键的两个指标:响应速度与任务完成率。
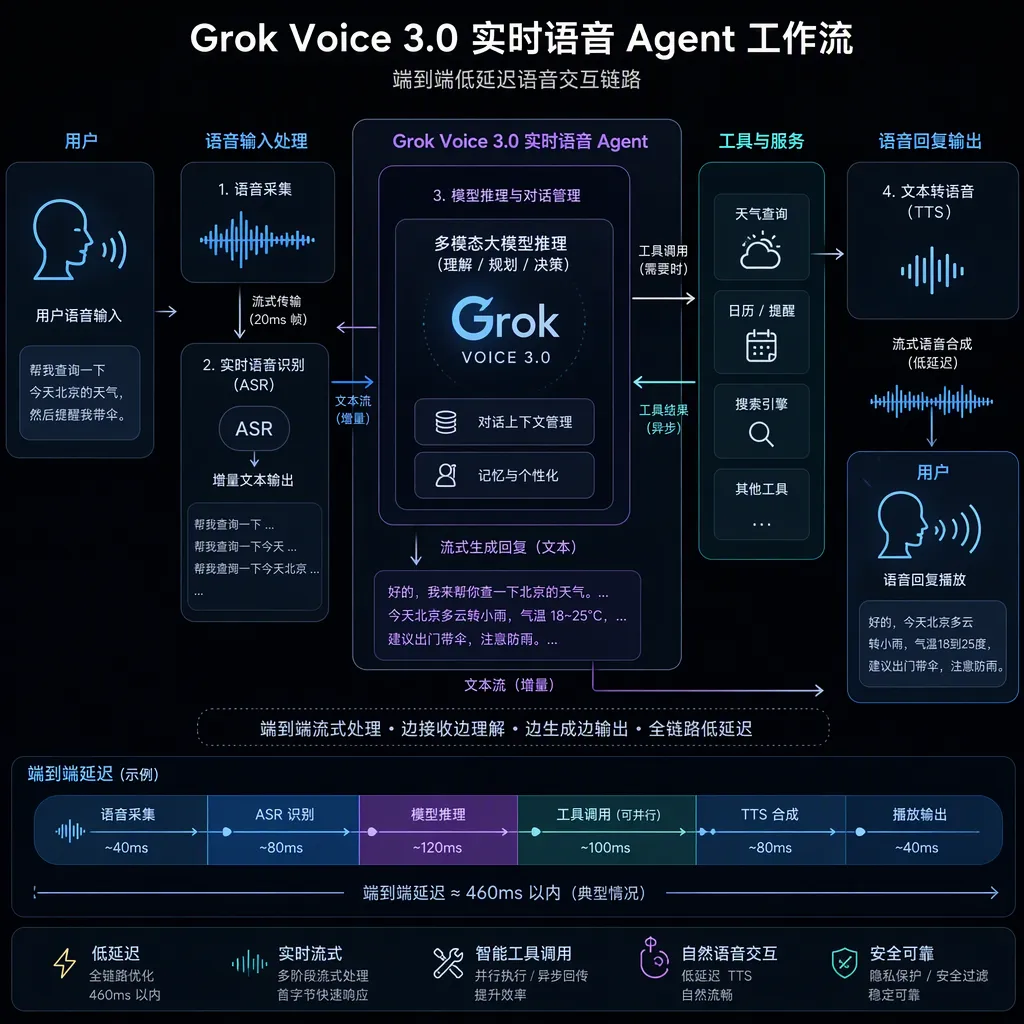
低于 1 秒,改变的不是听感而是交互方式
实时语音产品最容易被忽略的指标,不是音色,而是从用户停止说话到 Agent 开始回应之间的等待时间。
在文字聊天中,等待 2 秒通常还能接受;但在电话、车载语音和客服场景里,2 秒的空白会被用户理解为“系统没有听懂”或“通话断了”。如果用户需要连续确认两三次,整个体验就会迅速退化成传统 IVR 菜单。
语音交互延迟是指用户结束发言后,系统开始输出有效语音所需的时间,它通常同时受到语音检测、语义理解、模型推理、工具调用和音频合成影响。
Grok Voice 3.0 宣称端到端延迟低于 1 秒,意味着模型不必等到整段语音完全转写、文本模型完成长链路推理、TTS 再把全文合成后才开始说话。更理想的实现方式是边听边判断,在确认用户意图后尽快开始输出,并在后续语音中继续补全答案。
这种交互更接近人与人打电话,而不是人与一个“会朗读文字的聊天机器人”通话。用户说到“帮我查一下明天上午的日程”时,Agent 可以快速回应“好的,我看一下”,同时在后台完成日历查询;用户说“我想订一杯咖啡”时,系统也可以在保持对话的同时调用订单工具,而不必让对方等待完整的中间过程。
不过,低于 1 秒并不等于所有请求都能在 1 秒内完成。这个数字更可能对应首音频响应或语音交互的关键延迟,而不是复杂工具任务的完整完成时间。查询物流、核验身份、退款和重新发货仍然会受到业务系统响应速度、权限校验和风控流程影响。
独立测试排名第一,但领先点并不在所有维度
Artificial Analysis 的独立测试显示,Grok Voice 3.0 在语音转语音综合榜单中排名第一,得分为 86.9。
Artificial Analysis 的语音转语音综合评分,是对语音推理、τ-Voice、盲测通话偏好度和任务完成率等指标的综合评价。
其中,Grok Voice 3.0 在全双工基准测试中拿到 97%。全双工不是简单地判断模型能不能同时收音和播放,而是看它能否处理真实对话中的停顿、轮替和插话。
电话里最常见的情况是用户还没有完全说完,Agent 就已经开始回应;或者 Agent 说到一半,用户突然插入“不是这个意思”。如果系统不能及时停止、重新判断并接管新的对话轮次,就会出现两个人同时说话、模型重复上一句话、或者把插话误当成背景噪音等问题。
97%的全双工得分说明,Grok Voice 3.0 至少在实验基准中已经接近“可持续对话”的要求。这比单纯提高语音合成自然度更重要,因为企业部署实时语音 Agent 时,真正影响满意度的往往是打断、误听和转场,而不是声音是否像真人主播。
另一个关键指标是 τ-Voice。Grok Voice 3.0 得分为 71.6%,与 GPT-Live-1(Astra)相当,但官方称延迟降低了 40%。
τ-Voice 是用于衡量语音 Agent 处理不同口音、背景噪音和中途插话能力的客服通话基准。
这组数据揭示了 Grok Voice 3.0 的主要竞争策略:它没有只追求更高的语义准确度,而是试图在“理解得足够好”和“回应得足够快”之间找到更实际的平衡。
| 模型 | 语音相关指标 | 延迟表现 | 成本表现 | 公开信息中的主要定位 | |---|---:|---:|---|---| | Grok Voice 3.0 | Artificial Analysis 综合得分 86.9;全双工 97%;τ-Voice 71.6% | 低于 1 秒;τ-Voice 场景较 GPT-Live-1(Astra)低 40% | 每分钟 0.08 美元 | 实时语音 Agent、客服、车载助手 | | GPT-Live-1(Astra) | τ-Voice 与 Grok Voice 3.0 接近 | 作为对比基准,延迟更高 | Grok 官方称其成本高于 Grok Voice 3.0 | 实时语音交互 | | GPT-Realtime-2.1 | 官方未在该资料中披露具体分数 | 未披露 | Grok 官方称 Grok Voice 3.0 成本更低 | 实时语音模型 |
需要强调的是,表格中的成本比较来自 Grok 官方对 Artificial Analysis 测试结果的引用,官方没有在发布信息中给出所有竞品的统一单价。因此,开发者不能仅凭“成本更低”四个字计算最终预算,还需要结合输入音频、输出音频、并发连接、工具调用和企业服务费用核算。
价格没有上涨,API 已经切换到 3.0
Grok Voice 3.0 通过 Voice Agent API 上线,价格保持与 Grok Voice 2.0 一致,为每分钟 0.08 美元。
Voice Agent API 是一种面向实时语音 Agent 的接口,开发者可以通过持续音频连接让模型完成听取、理解、回应和工具协作,而不是逐段上传录音后等待文本结果。
对高频语音业务来说,这个价格有一定吸引力。按照每个 Agent 每天处理 1,000 分钟语音计算,纯模型调用成本约为 80 美元;如果每天处理 10 万分钟,模型成本约为 8,000 美元。这个数字还不包括电话线路、录音存储、身份认证、业务系统和人工兜底等费用,但已经足以让企业把实时语音 Agent 纳入正式的成本模型。
官方还表示,使用 grok-voice-latest 的 Agent 已经自动切换到新版本,不需要修改模型名称。这对持续运行的应用比较方便,但也带来一个工程问题:自动跟随 latest 标签意味着模型行为可能发生变化。对于客服质检、金融外呼、医疗咨询等高风险场景,开发者仍然应该保留版本固定、回归测试和人工转接机制。
下面是一个基于 WebSocket 的最小连接示意。它展示的是实时音频会话的基本结构,实际可用字段、音频编码、事件名称和工具调用协议,应以 xAI 当前 Voice Agent API 文档为准。
import base64
import json
import os
import websocket

url = "wss://api.x.ai/v1/realtime?model=grok-voice-latest"
headers = [f"Authorization: Bearer {os.environ['XAI_API_KEY']}"]

ws = websocket.create_connection(url, header=headers)
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "modalities": ["audio", "text"],
        "instructions": "你是一个简洁、可靠的中文客服助手。",
        "voice": "alloy"
    }
}))

with open("customer_audio.pcm", "rb") as audio_file:
    audio_chunk = base64.b64encode(audio_file.read()).decode("ascii")

ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": audio_chunk
}))
ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
ws.send(json.dumps({"type": "response.create"}))

while True:
    event = json.loads(ws.recv())
    print(event)
这个接口形态最适合需要持续对话的场景,例如客服、销售、预约、车载助手和语音办公。对于只需要把录音转文字的应用,实时语音 Agent 往往会带来额外成本和系统复杂度,并不是默认的最优选。
真正的壁垒在于“能办事”
Grok Voice 3.0 的发布材料中,最有价值的部分不是“全球最智能”这种宣传语,而是它已经被放进特斯拉和 SpaceX 的真实业务流程中。
官方称,Grok Voice 每天在特斯拉车辆内处理数百万次对话。驾驶员可以通过 Connectors 查询日程、回复邮件,也可以通过 Grok Bot 下单咖啡、预订晚餐。这意味着模型不是只负责回答问题,而是需要理解自然语言、确认用户意图、调用外部系统,并在操作完成后用语音反馈结果。
语音 Agent 的核心能力是把自然语言对话转换成可执行的业务动作,而不是单纯生成一段听起来流畅的回答。
这也是 Grok Voice 3.0 和普通语音助手的分水岭。传统语音助手通常围绕固定指令设计,用户必须说出接近预设命令的句式;新一代语音 Agent 则需要处理模糊表达、上下文、省略和临时改口。
例如,用户说“帮我订明晚那家餐厅,还是上次两个人的位置”,系统至少要完成时间解析、地点关联、人数推断、历史偏好读取和预订确认。真正可靠的 Agent 还应在关键动作前再次确认,避免把“看看有没有位置”误执行为“直接下单”。
Grok Voice 3.0 在 ServiceNow 的 EVA 企业语音智能体基准测试中获得 74%的最高精度得分,并在精度与客户体验的联合评分中表现最优。这说明它的目标用户并不是只想做语音聊天的开发者,而是希望把电话流程自动化的企业。
星链客服数据,说明规模化已经开始
SpaceXAI 还披露,星链客服中心每天使用多种语言承接约 2 万通客户来电,其中约 70%的来电无需人工介入即可解决,约四分之一的销售通话在客户挂断前完成下单。
这组数据的价值在于,它把语音模型的评估从实验室拉回到业务结果:自动解决率反映 Agent 能否独立完成流程,销售转化反映模型能否维持有效对话,而不是在用户最需要帮助时把电话转回人工。
官方进一步称,基于 Grok Voice 3.0 的单个 Agent 可以完成客户身份核验、硬件故障排查、退款以及设备补发。这些任务通常涉及多个后台系统和较严格的权限控制,如果描述属实,说明模型已经被放在完整的业务编排链路中,而不只是客服前端的语音入口。
当然,企业不应直接把这些比例当作通用结论。星链的产品范围、客户类型、客服脚本和后台系统都具有特殊性,70%的自动解决率无法直接复制到银行、保险或医疗行业。不同业务对身份确认、责任追溯和错误容忍度的要求差异很大。
对实时语音 Agent 市场意味着什么
Grok Voice 3.0 对市场最直接的影响,是把竞争标准从“能不能实时说话”推向“能不能在低延迟下完成复杂任务”。
过去,语音 Agent 的技术栈通常是 ASR、文本大模型和 TTS 的串联。它的优点是模块清晰、可替换性强;缺点是每一层都会增加等待时间,而且语音中的情绪、停顿、重音和打断信息在转成文字后可能丢失。
端到端语音转语音模型则试图直接处理音频到音频的映射。它可以保留更多副语言信息,也更容易针对轮次切换、打断和语气做联合优化。但代价是可解释性、调试难度和供应商锁定风险更高。开发者很难像替换一个 ASR 模块那样,单独替换端到端模型中的某个能力。
因此,Grok Voice 3.0 更适合以下几类应用:
- 需要连续通话,而不是单轮问答的客服和销售系统;
- 对首音频响应时间敏感的车载助手和语音办公工具;
- 需要处理打断、口音和背景噪音的电话场景;
- 已经具备订单、日历、退款、物流等工具调用能力的企业 Agent;
- 希望用一个语音 Agent 覆盖多语言客户服务的跨境业务。
它不一定适合所有项目。对低频使用、只需语音转写、或者必须完全控制模型行为的业务,传统模块化方案仍然更容易审计和维护。
开发者现在需要验证什么
第一,验证真实网络环境下的延迟,而不是只看官方的最佳测试结果。应分别记录用户停止说话到首个音频包、首个完整词语和完整回答的时间,并在不同网络、不同口音和不同背景噪声下重复测试。
第二,验证插话后的恢复能力。Agent 说到一半被用户打断后,是否能停止当前输出?它能否理解新的请求?如果用户只是发出“嗯”“不对”这类短促声音,系统会不会错误地开启一次完整回答?
第三,验证工具调用的错误边界。模型是否会在没有确认的情况下完成退款、下单或删除操作?外部系统超时后,Agent 是否会如实告知用户,还是编造一个看似合理的结果?
第四,验证版本稳定性。grok-voice-latest 方便快速获得升级,但生产环境最好建立录音回放、任务成功率、转人工率、幻觉率和用户挂断率等指标,并对每次模型变化做回归测试。
第五,验证成本的真实构成。每分钟 0.08 美元是一个清晰的起点,但长时间沉默、重复确认、工具失败重试和人工转接都可能推高单次会话成本。企业应按“每解决一个问题的成本”而不是单纯按“每分钟价格”比较模型。
结论:低延迟只是入场券
Grok Voice 3.0 目前最值得关注的地方,是它同时把低于 1 秒延迟、97%的全双工得分、86.9的综合榜单成绩和真实业务规模放在了一起。它未必已经证明自己在所有语音任务上都优于 GPT 系列或其他实时模型,但至少把实时语音 Agent 的竞争拉到了更具体的指标上。
对于开发者来说,真正的问题已经不是“语音模型能不能像人一样说话”,而是它能不能在用户插话时保持上下文,能不能在不到 1 秒内给出有效反馈,能不能调用业务系统完成动作,以及出错时能不能把控制权交还给人工。
Grok Voice 3.0 的 API 价格维持每分钟 0.08 美元,降低了尝试门槛;但它最终能否成为企业默认的实时语音底座,还要看更多第三方测试、长期稳定性和工具调用可靠性。可以确定的是,实时语音 Agent 已经从演示功能进入基础设施竞争阶段,而 Grok Voice 3.0 正在把“快”与“能办事”绑定在一起。
参考来源
- IT之家:SpaceXAI 发布 Grok Voice 3.0:提供发布时间、模型能力、基准测试成绩、特斯拉与星链客服应用数据。
- CSDN 社区:Grok Voice Agent API 架构解析:介绍实时语音 Agent 与传统 ASR、LLM、TTS 串联架构的差异。该页面为社区资料,接口细节仍应以官方文档为准。
- 知乎:实时语音模型相关评测整理:汇总实时语音模型在首音频响应和音频基准测试方面的公开信息。