Drex Max v1.1冲榜并公开训练法
Nace.AI 发布多模态决策模型 Drex Max v1.1,并公开完整训练论文。模型主打单次前向计算、262K 上下文和本地运行,但“榜首”说法需要结合榜单更新时间谨慎看待。
Drex Max v1.1冲榜并公开训练法
Nace.AI 在 11 月 8 日发布 Drex Max v1.1,并宣称这款多模态决策模型登上 Artificial Analysis 决策模型榜首,同时进入成本—性能帕累托前沿。与一次常规的小版本更新同步公开的,还有一篇接近“完整训练手册”的论文《Towards Foundation Decision Models: Drex》,覆盖模型架构、训练数据、RLAF 强化学习、校准方法、推理优化和消融实验。
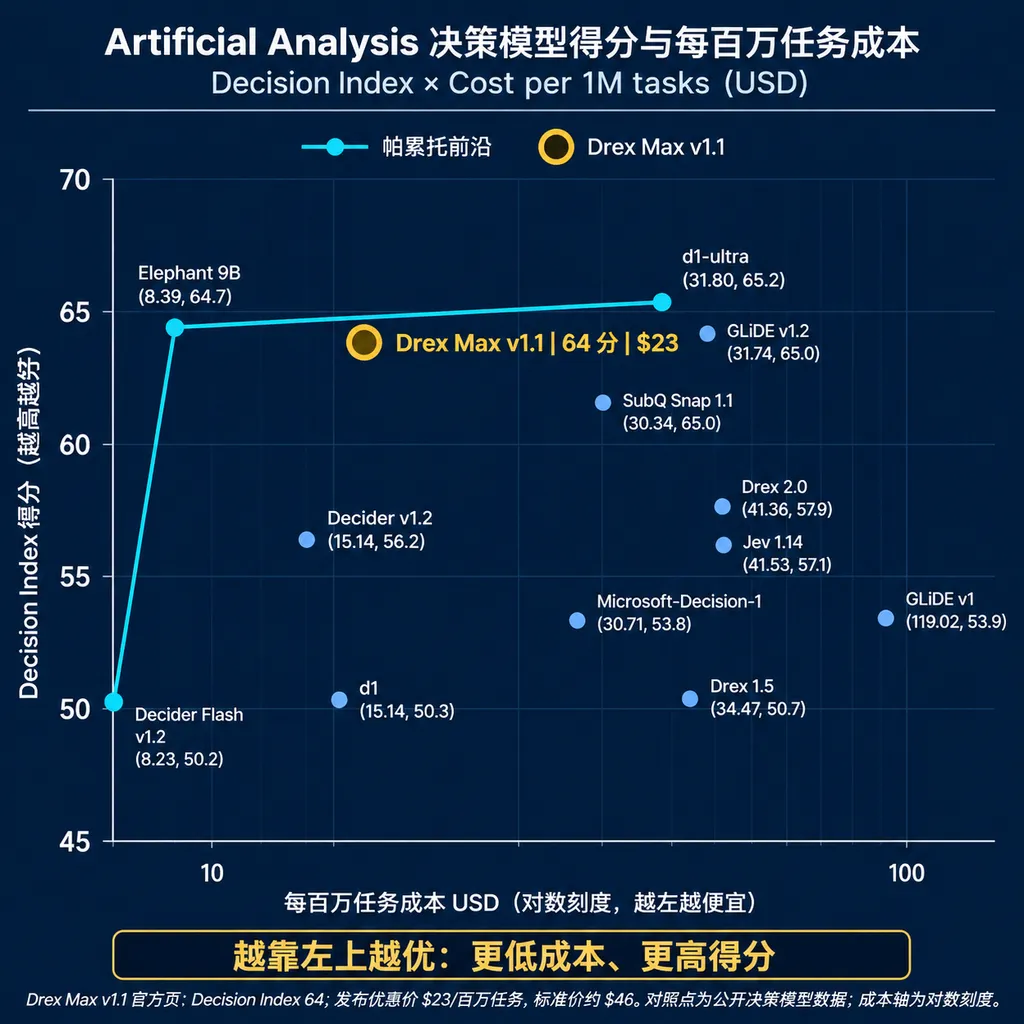
不过,“榜首”需要打一个星号。截至 2026 年 11 月 8 日,Artificial Analysis 的 Drex Max v1.1 独立页面显示其 Decision Index 得分为 64,在 23 款决策模型中排名第 5,而不是第 1;Nace.AI 当天发布的榜单截图和社区帖子则显示其一度位于决策模型第一名,并进入帕累托前沿。更合理的解释是榜单样本、模型设置或统计版本在发布前后发生了变化,而不是 Drex Max v1.1 稳定地碾压了全部竞争者。(reddit.com)
这不影响 Drex Max v1.1 成为一个值得关注的模型。它真正重要的地方不是“第几名”,而是证明了一类专门负责做选择、不负责写作文的模型,正在成为 AI Agent 基础设施中的独立品类。
决策模型不是缩短回答,而是取消生成
决策模型是接收上下文、问题和候选选项,并直接返回各选项概率分布的模型。
普通大语言模型处理“是否调用搜索工具”时,通常会先生成一段文本,例如“根据用户的问题,我认为应该调用搜索工具”,应用再从文本中解析出 yes 或 no。Drex Max 的路径更短:输入当前对话、可用工具和候选动作,模型在一次前向计算后直接输出类似“搜索 0.82、不搜索 0.18”的概率。
两者的差异不是回答长短,而是计算范式不同。传统大模型需要逐 token 自回归生成,输出还可能夹带解释、Markdown 或格式错误;决策模型不进入解码循环,也不生成自然语言,只对给定候选项打分。
这类模型更像一个通用分类器,但与普通分类器相比,它的标签不是训练时固定的。开发者可以在每次请求中临时提供 2 个、20 个甚至上百个选项,模型最多支持 255 个候选项,并返回一个闭合的概率分布。
这种接口特别适合四类生产任务:
- Agent 工具路由:决定调用搜索、代码执行、数据库还是直接回答。
- 内容审核:在通过、拒绝、升级人工审核之间进行选择。
- 工作流分发:根据邮件、工单或截图,把任务分配到不同队列。
- 质量判断:判断另一个模型的输出是否正确、相关或需要重试。
Drex Max 的价值因此不在于替代聊天模型,而在于替代 Agent 系统里大量脆弱的提示词分类器、规则引擎和文本解析逻辑。
64 分不算碾压,但成本位置很有竞争力
Artificial Analysis Decision Index 是同时考察决策准确性、置信度质量、拒答能力和选项对称性的综合指标。
截至 11 月 8 日,Artificial Analysis 页面记录的 Drex Max v1.1 得分为 64,榜单中位数为 54;单任务耗时为 234 毫秒,慢于 186 毫秒的中位数;每百万任务的平均成本为 23 美元,低于 32 美元的中位数。其标价为每百万输入 token 0.03 美元,但这是临时发布价,标准价格预计翻倍。(artificialanalysis.ai)
| 指标 | Drex Max v1.1 | 榜单中位数 | 判断 | |---|---:|---:|---| | Decision Index | 64 | 54 | 明显领先平均水平 | | 当前排名 | 第 5 / 23 | — | 第一梯队,但当前并非榜首 | | 单任务耗时 | 234 ms | 186 ms | 偏慢 | | 每百万任务成本 | 23 美元 | 32 美元 | 成本较低 | | 输入价格 | 0.03 美元/百万 token | — | 临时发布价格 | | 上下文窗口 | 262K token | — | 长上下文优势明显 | | 输入模态 | 文本、图像 | — | 支持多模态判断 |
Nace.AI 所说的“帕累托前沿”比单纯的榜首更值得看。**帕累托前沿是指在性能和成本两个维度上,找不到另一款模型能够同时做到得分更高且价格更低。**换句话说,Drex Max v1.1 未必绝对最强,但在相近得分下足够便宜,或者在相近价格下足够准确。
这也是专用决策模型最现实的竞争路线。它们在知识密集型任务上仍然打不过前沿聊天模型,但不需要为每次简单判断支付长思维链的成本。论文数据表明,Drex Max 在较早版本 Artificial Analysis 测试中的得分约为 63.7,低于 Claude Opus 5.5 的 79.0;但后者每百万请求成本达到 51295 美元,Drex Max 为 46 美元,两者相差超过 1100 倍。(arxiv.org)
所以,把 Drex Max 描述为“比 Claude 更聪明”显然不准确。更准确的说法是:在答案空间已经明确的任务中,用旗舰聊天模型做每一个选择,往往是一种昂贵的计算浪费。
27B 参数、262K 上下文,Mac 也能跑
Drex Max 是一个基于 Qwen3.8-27B 改造的稠密多模态决策模型。
模型共有 64 层,其中包括 48 层 Gated DeltaNet 线性注意力层和 16 层全注意力层。Nace.AI 移除了全注意力层中的因果遮罩,使这些层可以同时查看问题、上下文和全部候选项,而不是只能从左向右读取。
模型末端增加了一个 255 路 readout head。这个约 130 万参数的无偏置线性层,会把最后一个隐藏状态映射为 255 个 logit,再截取当前候选项对应的部分进行 Softmax。整个过程没有文本生成,也没有逐 token 解码。(arxiv.org)
| 模型 | 参数规模 | 活跃参数 | 输入模态 | 最大上下文 | 输出方式 | |---|---:|---:|---|---:|---| | Drex DLM | 8B | 8B | 文本 | 32K | Pointer head | | Drex v1.5 | 9B | 9B | 文本 | 131K | Pointer head | | Drex v2.0 | 35B MoE | 3B | 文本 | 131K | Pointer head | | Drex Max | 27B Dense | 27B | 文本、图像 | 262K | 255 路 readout head |
Drex Max 的代价是无法像 Drex v1.5 和 v2.0 那样,在多个问题之间复用完整上下文缓存。由于非因果全注意力会让上下文表示受到问题和选项影响,每换一个问题,Drex Max 都需要重新编码上下文。短任务中影响不大,但如果要围绕一份十万 token 文档连续询问几十个问题,较小的 Pointer 模型反而可能更便宜。
本地部署是这次发布的另一个重点。Drex Max v1 的 affine Q4 量化版本可以在内存不少于 24GB 的 Apple Silicon Mac 上运行,Q8_0 GGUF 则需要约 48GB 内存;BF16 权重约占 49GB,8bit 加载约占 26GB。官方的 Kapitsa 推理引擎已经支持通过 kapitsa-systemone 返回每个选项的校准概率。(huggingface.co)
需要注意的是,截至 11 月 8 日,公开的是 Drex Max v1 权重,而不是 v1.1 权重。Nace.AI 表示 v1.1 权重仍在进行本地推理优化,完成后才会发布。因此,开发者目前可以复现 v1 的架构与推理流程,但不能假设本地版本已经包含 v1.1 的全部改进。(reddit.com)
真正有价值的是训练方法被摊开了
RLAF 是一种把可验证答案、推理模型判断和概率校准结合起来的决策模型训练方法。
Nace.AI 公布的训练流程分为三个阶段:全参数监督微调、RLAF 强化学习,以及视觉编码器微调。基础训练集包含 1150460 条文本决策记录,覆盖 11 个领域;数据主要来自更强模型蒸馏、开源数据集和可通过程序或游戏引擎验证的合成任务。
第一阶段并非只用正确选项做普通交叉熵训练。团队还加入了两种一致性损失:一种要求打乱选项顺序后,模型对同一选项的概率保持接近;另一种要求打乱上下文中的句子或字段后,模型判断尽量稳定。
这是决策模型必须面对、聊天模型经常掩盖的问题。假设“批准退款”原本是选项 A,移动到选项 C 后,模型不应该因为字母和位置变化就改变决定。论文的消融实验显示,加入一致性损失后,选项重排导致答案翻转的比例从 6.3% 降至 4.2%,降幅约 33%。(huggingface.co)
第二阶段使用 RLAF,而不是简单地继续灌入 one-hot 正确标签。One-hot 标签的问题在于,它会告诉模型“正确答案概率应该是 100%”,即使问题本身存在歧义,也会把模型训练得过度自信。
Drex Max 的 RLAF 同时使用两类信号:一类是金标准答案、程序执行结果或游戏引擎结果等可验证反馈;另一类是 Qwen3.8-27B 高推理强度模式给出的选项概率。后者并不是更大的教师模型,而是 Drex Max 基础模型的生成式版本,可以先进行较长推理,再给出判断。
训练目标还通过 KL 散度约束,让 RLAF 后的模型不要偏离监督微调检查点太远。这个设计很像给模型同时安排一名裁判和一名教练:裁判告诉它什么结果可以验证,教练告诉它其他选项有多合理,KL 约束则防止模型为了追逐新奖励而完全忘掉原来的判断能力。
消融结果显示,RLAF 把 Decision Index 从 64.9 提升到 66.9,增加 2.0 分;准确率从 86.5% 提升到 88.0%,增加 1.5 个百分点;预期校准误差从 4.4% 降到 3.5%。这组结果不算革命性跃升,却证明 RLAF 改善的不只是答对率,还包括概率是否可信。(arxiv.org)
第三阶段只训练图像编码器及其投影层。结果相当直接:在 Decision Bench 的 60 道纯图像问题中,直接输入图像的准确率达到 98.3%,只输入图像文字描述时为 63.3%,提高 35 个百分点;同时,视觉训练几乎没有损伤文本任务表现。(arxiv.org)
多模态能力不是“会看图聊天”
Drex Max 的多模态能力是从图像证据中完成结构化选择,而不是围绕图片生成描述。
典型场景不是“描述这张截图”,而是把软件界面截图交给模型,再让它从“点击保存”“关闭弹窗”“向下滚动”“请求人工接管”中选择下一步动作。每个问题都能访问请求中的全部图像,视频则通过抽帧转换为多张图片处理。
这种能力对计算机操作 Agent、工业质检、保险理赔和文档审核更有实际意义。一个负责执行动作的 Agent 不需要模型写一篇分析报告,它需要的是一个可用于阈值判断的概率:当“提交订单”概率为 0.98 时可以自动执行,当最高概率只有 0.43 时则转交人工。
概率校准因此比普通准确率更重要。论文在约 11.5 万条留出决策上测得,Drex Max 的原始预期校准误差为 3.61%;重新针对 Decision Index 拟合温度参数后,可降至 1.35%。在置信度最高的 50% 决策中,模型准确率达到 99.3%。(arxiv.org)
这组数据意味着,开发者可以利用置信度建立分层路由:高置信度判断直接执行,中等置信度交给更贵的推理模型,低置信度升级人工。如果概率本身不可信,这套架构就无法成立。
Drex Max 的短板同样明确
Drex Max 擅长在已知选项中做判断,但不适合开放式知识探索和复杂生成任务。
论文显示,Drex Max 在 When2Call 和 WildGuardTest 等工具调用、安全判断任务上表现突出,但在知识密集型评测中仍远落后于前沿聊天模型。其 HLE-MultiChoice 准确率为 16.0%,Claude Opus 5.5 为 70.2%;AA-Omniscience-Decision 准确率为 27.6%,Claude Opus 5.5 为 93.4%。(arxiv.org)
模型对选项顺序也没有做到真正不变。在 1591 道测试题中,随机打乱选项后,Drex Max 有 4.3% 的决策更换了最高概率选项;当候选项达到 6 个或更多时,翻转率升至 13.3%。这比多数同类模型稳定,但距离严格意义上的排列不变仍有明显差距。(arxiv.org)
另一个风险来自 RLAF 的教师信号。论文明确承认,当生成式判断模型非常确信一个错误选项时,其奖励可能覆盖可验证答案的影响;教师模型的偏差也可能被 Drex Max 继承。这是公开方法的好处:团队没有把训练过程包装成毫无副作用的“魔法配方”,而是把未解决的问题也写了出来。
这次发布更像决策模型的“工程定型”
Drex Max v1.1 的意义,是让决策模型从榜单概念逐渐变成可部署、可审计、可本地运行的工程组件。
它没有解决通用智能,也没有在知识能力上追平旗舰模型;当前 Artificial Analysis 页面甚至不支持“稳居第一”的宣传口径。但 262K 上下文、多模态输入、255 个动态选项、本地 Mac 推理、完整权重和训练论文组合在一起,使 Drex 成为目前开放程度最高的决策模型系列之一。
对 Agent 开发者来说,最值得尝试的架构不是让 Drex Max 替换主模型,而是把它放在主模型前后:前置负责工具路由、任务分类和风险判断,后置负责验证输出、选择重试策略和决定是否升级到更强模型。
如果这类模型能够稳定地把一次判断压缩到 200 毫秒级和美分以下,Agent 系统的成本结构会发生变化。未来的 AI 应用未必由一个模型完成所有事情,而更可能由生成模型负责思考和表达、决策模型负责选择和控制、嵌入模型负责检索,三类模型各自处理最擅长的计算。
Drex Max v1.1 还不是这个分工体系的最终答案,但它已经把“专用模型能否接管 Agent 决策层”从概念问题,推进成了一个可以下载权重、复现实验并测量投入产出的问题。
参考来源
- Towards Foundation Decision Models: Drex:Nace.AI 发布的 Drex 论文页面,包含训练方法、评测结论和论文入口。
- Drex Max v1 模型权重:公开的 27B 多模态模型权重、架构说明、量化版本及基准数据。
- Drex Decision Models GitHub 仓库:Drex 系列推理代码、请求格式、运行时和模型文档。
- Kapitsa 推理引擎:面向 Apple Silicon 的本地推理引擎,支持 Drex Max v1 决策输出。
- Nace.AI 的 v1.1 发布帖:团队关于 Drex Max v1.1、榜单表现和权重发布计划的社区说明。