GPT-2缓存实测:千倍计算只快6倍
一项最新复现实验从零实现GPT-2 Small及KV Cache:理论计算量缩小约1000倍,单Token延迟却只提升约6倍。真正值得关注的,是正确性验证、显存账本与GPU瓶颈之间的落差。
GPT-2缓存实测:千倍计算只快6倍
截至2026年10月18日,一项从零实现GPT-2 Small与KV Cache的实验在开发者社区引发讨论。作者没有调用现成的高层缓存接口,而是用PyTorch复现模型结构、加载预训练权重,再分别运行有缓存和无缓存的自回归生成,检验输出正确性、单Token延迟与显存开销。
这项实验最值得关注的结果并不是“KV Cache能加速”这个常识,而是理论计算量与实际速度之间的巨大落差:上下文长度达到1000时,缓存方案对应的部分计算量估算约缩小1000倍,但单Token耗时只从29.69毫秒降至4.95毫秒,实际加速约6倍。
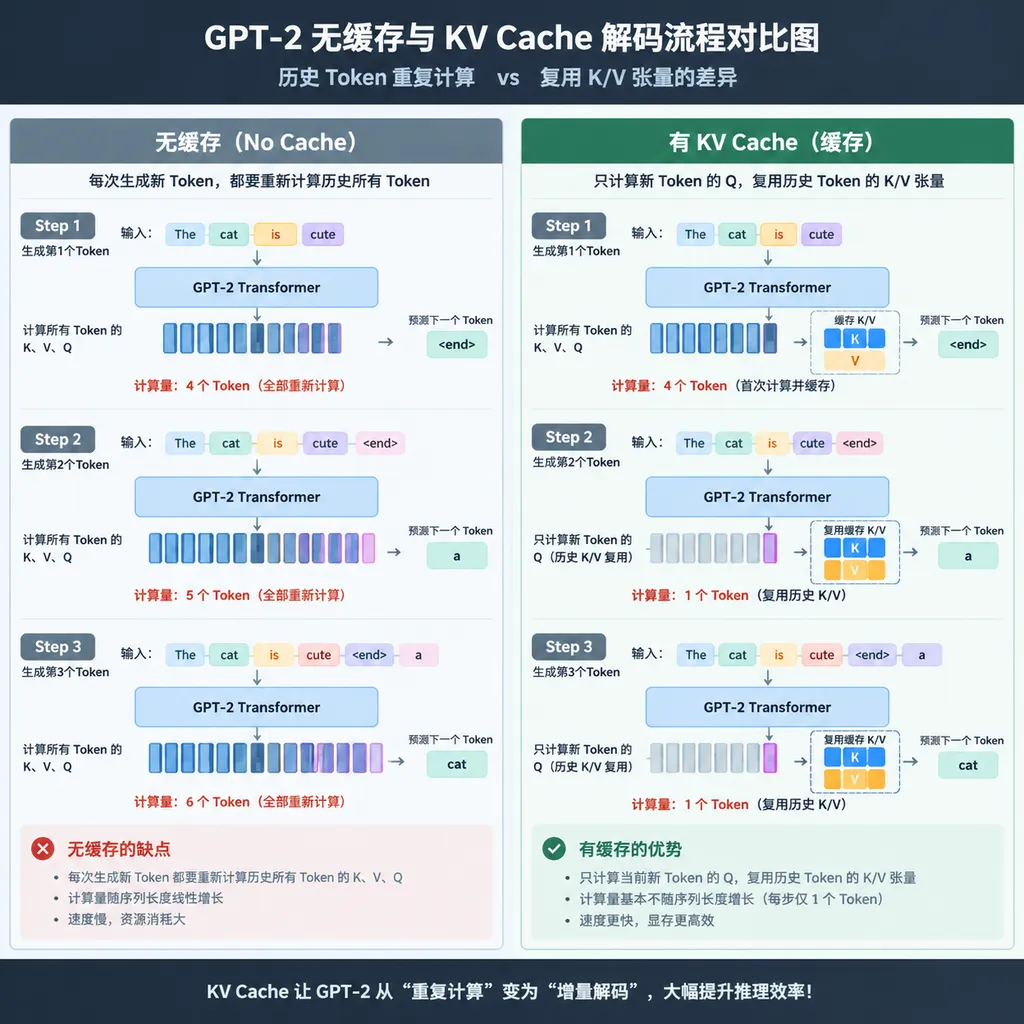
KV Cache是一种在自回归生成过程中保存历史Token注意力Key和Value张量、避免后续步骤重复计算的推理优化。 它不改变模型参数,也不减少下一个Token需要关注的历史范围,而是把已经完成的线性投影结果留在显存中,用空间换取时间。
实验到底测了什么
这次实验使用的是拥有约1.24亿参数的GPT-2 Small,硬件为NVIDIA A40,推理精度为FP32,并明确关闭TF32。测试采用batch size 1和贪心解码,每组计时前先预热GPU,在计时区间前后调用torch.cuda.synchronize(),最终取5次运行的中位数。
关闭TF32的目的,是减少不同矩阵乘法精度路径对结果比较的干扰。 NVIDIA Ampere架构默认可能让部分FP32矩阵运算走TF32路径;TF32能够提高吞吐,但尾数精度低于完整FP32,因此不适合用来做严格的逐层数值对齐实验。
实验配置可以概括为:
| 项目 | 配置 | |---|---| | 模型 | GPT-2 Small,约124M参数 | | Transformer层数 | 12层 | | 隐藏维度 | 768 | | 注意力头数 | 12 | | 最大上下文 | 1024 Token | | GPU | NVIDIA A40 | | 数值精度 | FP32,关闭TF32 | | 批大小 | 1 | | 解码方式 | Greedy Decoding | | 计时方式 | CUDA同步、预热后测试、5次中位数 |
这套设置更像一场受控实验,而不是生产环境性能展示。 现实中的推理服务往往使用FP16、BF16甚至FP8,配合连续批处理、Paged Attention、CUDA Graph和融合算子;因此这里的绝对延迟不能直接外推到现代服务框架,但非常适合观察缓存本身带来的变化。
正确性先于性能
从零实现KV Cache的第一道门槛不是跑得快,而是确认缓存路径与完整前向计算语义一致。 作者将自制实现与Hugging Face版本对齐,得到的最大logit绝对误差约为6.1e-5;在连续生成200个Token的测试中,缓存与非缓存版本的贪心解码结果完全相同。
6.1e-5的logit误差说明实现已经非常接近参考模型,但它并不等于所有输入都严格逐位一致。浮点运算的结合顺序、矩阵乘法内核和归一化实现都可能制造微小差异,而贪心解码只要没有遇到两个候选Token分数极其接近的情况,就可能在存在数值误差时仍输出相同序列。
可靠的正确性验证至少要同时覆盖张量、logit和最终生成结果三个层级。 只看生成文本容易漏掉被argmax掩盖的数值偏差,只比较单层张量又无法证明位置编码、因果掩码和缓存更新逻辑在完整模型中正确。
建议把测试拆成以下几组:
- 比较无缓存实现与Hugging Face参考实现的完整logit。
- 比较缓存解码与无缓存解码在每一步最后位置上的logit。
- 覆盖不同提示长度、空缓存、接近1024 Token上限等边界条件。
- 同时测试单Token解码和一次输入多个新Token的分块解码。
- 检查每层缓存的形状、长度、设备与数据类型是否一致。
- 使用贪心解码进行长序列回归测试,并记录第一次发生Token分歧的位置。
一个很容易漏掉的错误
这次复现暴露出的最佳测试案例,是把新旧缓存的拼接顺序写反后,单Token注意力测试仍然可能通过。 如果Key和Value以相同方式一起重排,而查询端只有一个Token,那么注意力本质上是对一组键值对做加权求和;只要每个Key仍与对应Value绑定,单纯改变这些键值对的排列顺序,结果可以保持不变。
问题会在一次解码多个新Token时暴露。分块解码中的第一个新Token只能看到历史缓存和自己,第二个新Token可以再看到第一个新Token;此时因果掩码依赖序列位置,新旧缓存顺序一旦颠倒,掩码就会作用到错误的键值位置。
正确的数据流可以简化为:
prefill:  prompt -> K_prompt, V_prompt -> cache

decode:   new_tokens -> K_new, V_new
          cache = concat(cache, new, sequence_dimension)
          attention(Q_new, cache.K, cache.V, causal_mask_with_offset)
缓存拼接必须发生在序列维,而不是注意力头维或特征维。 以常见的[batch, heads, sequence, head_dim]布局为例,GPT-2 Small单层缓存通常可整理为[1, 12, T, 64];不同实现也可能保留[batch, sequence, heads, head_dim]布局,因此不能只凭维度大小猜测拼接轴。
分块解码还必须给因果掩码加入历史长度偏移。 当缓存已有P个Token、新输入包含N个Token时,新输入中第i个位置可以访问的Key长度应为P+i+1,而不是简单套用一个不含偏移的N×N下三角矩阵。
千倍计算量为何只换来6倍速度
FLOP减少不等于端到端延迟按相同比例下降。 在上下文长度1000时,无缓存方案每生成一个Token,都要把前面约1000个Token重新送进12层Transformer;有缓存方案只需为新增Token计算一次投影和MLP,因此按新增Token计算量衡量,部分算子可以接近1000倍缩减。
实际结果却只有约6倍:
| 指标 | 无缓存 | 使用KV Cache | 改善幅度 | |---|---:|---:|---:| | 上下文长度1000时单Token延迟 | 29.69 ms | 4.95 ms | 延迟下降83.3%,约6.0倍加速 | | 完成1016 Token生成任务 | 14.66 s | 5.03 s | 时间下降65.7%,约2.91倍加速 | | 已有Token的K/V投影 | 每步重算 | 直接复用 | 理论上随上下文长度增加而扩大收益 | | KV缓存显存 | 近似为0 | 随序列长度线性增长 | 以空间换时间 |
缓存后的单Token解码通常会从计算密集型问题转向显存带宽和内核调度问题。 GPU不再为1000个历史Token反复执行大规模矩阵计算,但仍需从显存读取这些Token对应的Key和Value,并让新查询向量与全部历史Key计算注意力分数。
GPT-2 Small的模型尺寸也限制了GPU利用率。 124M参数对于A40并不算大,在batch size 1的逐Token解码中,许多矩阵乘法规模不足以持续占满计算单元,Python循环、算子启动、张量拼接和同步操作的固定成本会变得显眼。
完整生成的加速比低于长上下文末端的单步加速比是合理现象。 生成早期的上下文很短,无缓存方案重算的Token数量还不多,缓存优势尚未完全展开;把从短到长的全部步骤累计起来,最终得到2.91倍,而不是最后一个位置对应的约6倍。
这组数字提醒开发者,复杂度分析回答的是“计算规模如何增长”,性能测试回答的才是“当前硬件与实现到底跑多快”。两者都重要,但不能互相替代。
GPT-2缓存要占多少显存
KV Cache显存开销由层数、KV头数、每头维度、序列长度、批大小和数据类型共同决定。 对标准多头注意力模型,可以使用下面的公式估算:
缓存字节数 = 2 × 层数 × KV头数 × 每头维度 × Token数 × Batch Size × 每元素字节数
公式开头的2分别代表Key和Value。GPT-2 Small拥有12层、12个注意力头,每头维度为64;在FP32、batch size 1下,每增加一个Token需要:
2 × 12 × 12 × 64 × 4 = 73,728字节
也就是说,每个Token约占72 KiB;缓存1000个Token约占70.3 MiB,达到1024 Token上限时约占72 MiB。如果改用FP16或BF16,单Token约36 KiB,1024 Token约36 MiB。
| GPT-2 Small缓存规模 | FP32 | FP16/BF16 | |---|---:|---:| | 每Token、batch size 1 | 72 KiB | 36 KiB | | 1000 Token | 约70.3 MiB | 约35.2 MiB | | 1024 Token | 72 MiB | 36 MiB | | 1024 Token、batch size 8 | 576 MiB | 288 MiB |
这组结果也说明“KV Cache一定比模型权重更大”并不适用于GPT-2 Small。 124M参数以FP32保存,权重本身约需473 MiB,而1024 Token缓存约72 MiB;但缓存会随批大小、并发序列和上下文长度线性增长,模型权重则可被所有请求共享,所以到了长上下文和高并发场景,缓存仍可能成为主要显存压力。
现代模型使用GQA或MQA的重要原因之一,就是减少KV头数量。 查询头可以很多,但多个查询头共享较少的Key/Value头后,缓存公式中的KV头数会下降,显存读取量也随之减少;这不仅节省容量,还能缓解逐Token解码的带宽瓶颈。
需要说明的是,原帖公开摘要给出了测试环境、延迟和正确性数据,但没有列出可直接核验的峰值显存读数,因此本文没有虚构额外的实测数字。上表是根据GPT-2 Small配置推导出的纯KV张量理论值,不包括模型权重、CUDA上下文、PyTorch缓存分配器、临时注意力矩阵和算子工作区。
显存测量最容易被分配器误导
测量KV Cache显存时,不能只看系统工具显示的进程占用。 PyTorch的CUDA缓存分配器会保留已经申请但暂时不用的显存,因此任务管理工具看到的占用可能在释放张量后仍不下降。
更可靠的实验应同时记录:
memory_allocated:当前活跃张量实际占用的显存。memory_reserved:PyTorch向CUDA申请并保留的显存池。max_memory_allocated:测试区间内活跃张量峰值。- 理论KV大小:用张量形状、元素数量和数据类型独立计算。
重复拼接缓存还可能制造额外的临时显存和复制开销。 教学实现通常每一步执行一次concat,这会申请更大的连续张量并复制旧缓存;生产推理引擎则倾向于预分配、分页管理或按块写入,避免序列增长时反复搬运全部历史数据。
这项实验真正有用的地方
这次复现的价值,在于把KV Cache从一个抽象优化词汇拆成了可验证的工程问题。 它同时展示了三件容易被忽略的事实:数值接近不代表测试充分,FLOP减少不等于延迟同比下降,缓存容量也不等于进程峰值显存。
对于准备自己实现推理引擎的开发者,最应该复用的是实验方法,而不是某一个加速数字。 A40、FP32、batch size 1和GPT-2 Small共同决定了这次约6倍的结果;换成消费级GPU、半精度、批量推理或融合注意力内核,加速比都可能明显变化。
对于只需要部署模型的团队,从零实现KV Cache并不是合理的生产路线。 成熟框架已经处理了缓存布局、分块解码、分页分配、连续批处理和多请求调度;手写实现更适合用于理解机制、验证新注意力结构或定位框架行为,而不是直接替代经过长期优化的推理系统。
一个合格的复现实验最终应该给出正确性、延迟、吞吐和显存四套数据。 延迟要报告首Token时间与逐Token时间,吞吐要区分单请求和并发场景,显存要区分理论缓存、活跃分配与进程保留,正确性则必须覆盖多Token分块输入。
截至目前,这项实验给出的结论很明确:KV Cache依然是自回归模型推理中不可缺少的基础优化,但“少算1000倍”不意味着“快1000倍”。在GPU推理里,省掉计算只是第一步,接下来还要面对显存带宽、内核启动、缓存搬运和调度效率,而这些往往才是长上下文解码的真正瓶颈。
参考来源
- Reddit:GPT-2 KV cache from scratch:本次实验的原始讨论,包含正确性、延迟、硬件环境与测试方法摘要。
- Hugging Face:GPT-2模型页面:GPT-2 Small模型文件、配置和使用说明,可用于核对模型规模与结构参数。
- GitHub:OpenAI GPT-2官方仓库:GPT-2原始实现、模型说明及相关资料。
- GitHub:KV Cache基础概念:介绍自回归解码中的KV缓存机制及其显存增长规律。
- 知乎:KV Cache深度解析:讨论KV Cache的显存公式、长上下文压力与生产选型问题。