TempoPFN:合成数据练成预测模型
TempoPFN 获 NeurIPS 2026 接收:它只用合成数据预训练线性 RNN,却能直接完成零样本时间序列预测。真正值得关注的不是又多了一个基础模型,而是一条更便宜、可复现且较少受数据泄漏干扰的训练路线。
TempoPFN:合成数据练成预测模型
TempoPFN 已被 NeurIPS 2026 接收,它试图证明:时间序列基础模型不一定要吞下海量真实数据,也不一定要依赖庞大的 Transformer。 这项工作由 Vladyslav Moroshan、Julien Siems、Arber Zela、Timur Carstensen 和 Frank Hutter 完成,论文编号为 arXiv:2510.25502,目前已经公开代码、模型权重与训练配置。
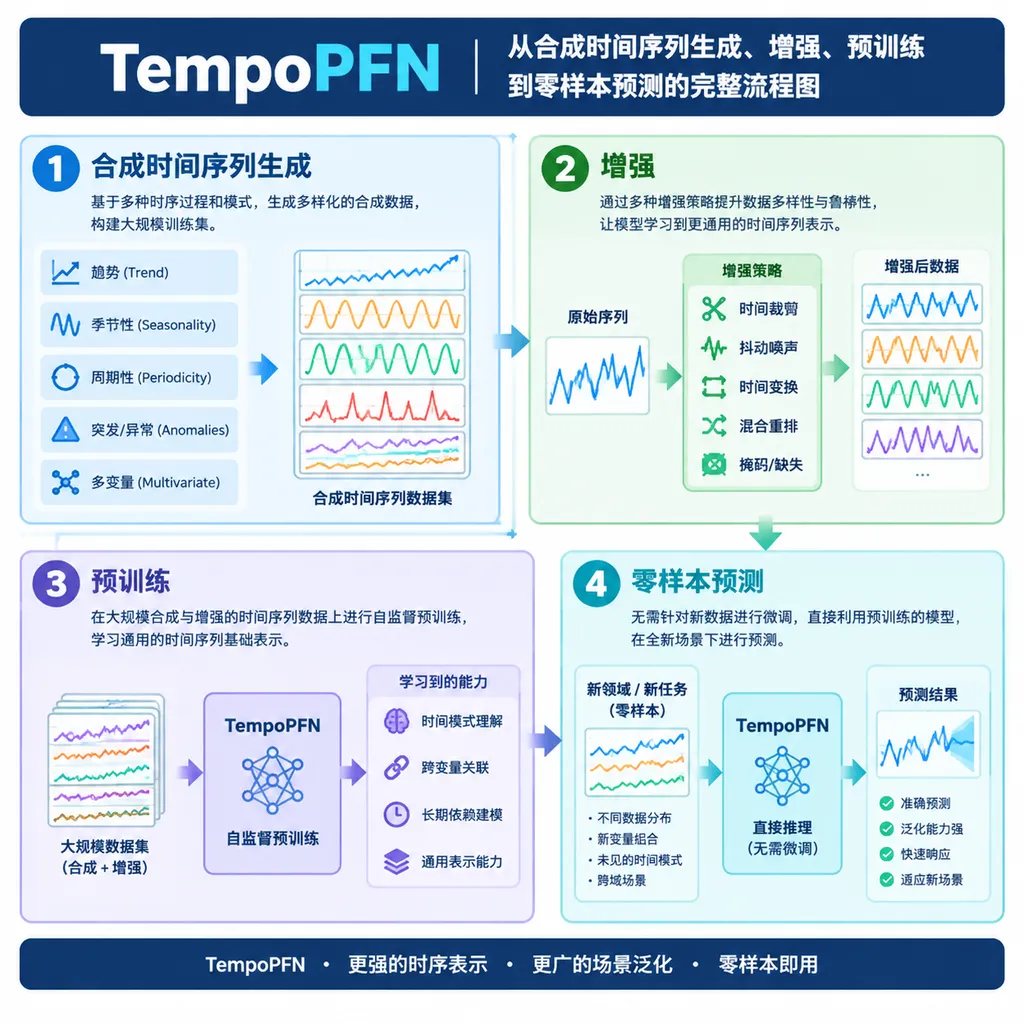
TempoPFN 是一个面向单变量时间序列的基础模型,它完全使用合成数据预训练,并在不针对目标数据集微调的情况下直接进行预测。模型名称中的 PFN 指 Prior-Data Fitted Network,即先从人为定义的任务分布中学习通用推断规则,再把这些规则迁移到从未见过的新序列上。
这篇论文并不是到 2026 年 10 月才第一次出现,其预印本编号显示研究最早在 2025 年公开;最近发生的关键变化,是论文获得 NeurIPS 2026 接收,并以 Apache 2.0 许可证完整开放实现。对于开发者来说,会议接收固然是学术背书,但代码、权重和合成数据生成流程同时开放,实际意义更大。
它解决的不是“预测”,而是训练数据问题
零样本时间序列预测是指模型不在目标数据集上重新训练或微调,仅根据输入的历史序列直接预测未来。 例如,一个预训练模型此前没有见过某家门店的销量曲线,但拿到最近数月的销量后,仍能输出下一周或下一个月的预测结果。
这个目标听起来和大语言模型的零样本能力相似,但时间序列领域的数据条件更差。文本模型可以从公开网页、图书和代码中获得相对统一的 token 序列,而时间序列散落在能源、零售、交通、金融、医疗和工业系统中,采样频率、单位、噪声水平和访问权限都不同。
真实时间序列预训练还存在难以排除的数据泄漏风险。 如果一个模型在预训练时已经接触过评测数据,或者接触过同一数据源中高度重叠的时间窗口,那么所谓零样本结果可能只是记忆或近邻匹配,而不是跨任务泛化。时间序列又经常包含重复周期,泄漏比文本中的逐字重复更难识别。
TempoPFN 的选择相当直接:既然很难证明真实预训练集没有污染测试集,那就不使用真实序列预训练。项目给出的核心承诺是,模型预训练数据全部由程序生成,因此训练集来源可以被追踪、重建和审计。
这种做法让 TempoPFN 的价值不只体现在排行榜上。它提供了一个更干净的实验对象:当模型在真实基准上取得有效结果时,研究者至少可以排除“预训练时见过测试序列”这一类解释。
合成预训练不是简单画几条正弦曲线
合成预训练是指先定义一组数据生成过程,再从这些过程采样出大量训练任务,让模型学习其中可迁移的结构规律。 如果生成器只会制造固定周期的正弦波,模型当然很难应对真实世界中的突变、漂移、异方差和缺失模式;TempoPFN 的关键因此不是“数据由机器生成”,而是生成分布能否覆盖真实序列的结构空间。
项目公开的是一套合成时间序列生成器和数据增强库,而不是一份静态训练集。生成器可以组合趋势、季节性、噪声、频率变化和局部结构,增强流程则继续改变尺度、长度与观测形态。训练时持续采样新任务,意味着模型更难通过记住有限样本完成训练。
这里可以把合成生成器理解为一台不断出题的机器。它不需要精确复刻某一家商店或某一个传感器,而是要覆盖“缓慢上涨后回落”“周期中夹杂异常冲击”“波动幅度随时间扩大”等更基础的动态模式。
合成数据路线的上限取决于先验是否足够丰富。 真实序列中可能存在政策变化、设备老化、促销活动和多个外生变量共同作用,这些因素无法靠少量数学过程完整表达。一旦真实任务超出生成器覆盖范围,零样本模型就可能表现出稳定但系统性的偏差。
这也是 TempoPFN 最需要警惕的地方:没有真实数据泄漏,不等于没有人为偏见。真实数据的偏见来自采集过程,合成数据的偏见则来自研究者选择了哪些生成器、参数范围和增强规则。
为什么偏偏是线性 RNN
线性 RNN 是状态更新对隐藏状态保持线性结构的一类循环网络。 与带有复杂门控和逐步非线性计算的传统 RNN 相比,线性递推可以改写为并行扫描操作,从而在 GPU 上更高效地处理长序列。
RNN 在概念上仍然按照时间顺序传递状态,但线性递推不必真的在硬件上逐点等待前一步完成。借助 associative scan 一类算法,多个时间位置可以分层合并,其并行深度从线性增长降为对数级增长。TempoPFN 所说的“完全可并行”,主要指训练和推理中的序列计算能够采用这种并行实现,而不是说时间依赖本身被取消了。
这条路线与 Transformer 的取舍明显不同。标准自注意力可以让任意两个时间点直接交互,但注意力矩阵的计算和显存开销通常随序列长度呈平方增长;线性 RNN 把历史压缩到递推状态中,计算规模更容易随长度线性扩展,但也可能在压缩过程中丢掉细粒度历史信息。
TempoPFN 的判断是,时间序列预测不总需要一台昂贵的全局检索机器。 对大量以趋势、周期和局部动态为主的单变量任务,一个设计得当、经过广泛任务预训练的线性递推器,可能比结构更重的模型更符合成本收益比。
这种判断并不新奇,但 TempoPFN 把三个此前常被分开讨论的方向放到了一起:PFN 式任务分布学习、完全合成的预训练数据,以及适合长序列并行计算的线性 RNN。创新点主要来自组合后的完整系统,而不是某一个孤立组件。
TempoPFN 与主流路线有什么不同
TempoPFN 与 Chronos、TimesFM、Moirai 等时间序列基础模型的最大差异,是预训练数据来源和序列骨干同时发生了变化。 前几类模型通常依赖大规模真实时间序列或真实与合成数据的混合,TempoPFN 则把可复现的合成任务分布放在中心位置。
| 路线 | 代表模型或方法 | 预训练数据 | 核心结构 | 零样本使用 | 主要优势 | 主要限制 | |---|---|---|---|---|---|---| | 合成 PFN 路线 | TempoPFN | 完全合成 | 线性 RNN | 支持 | 可复现、泄漏风险低、长序列计算友好 | 当前聚焦单变量,能力受生成器覆盖范围限制 | | 序列 token 化路线 | Chronos 系列 | 通常包含大规模真实序列 | Transformer | 支持 | 可借用语言模型式训练范式 | token 化会引入量化取舍,长上下文成本较高 | | 大规模 patch 路线 | TimesFM | 大规模时间序列语料 | Decoder-only 模型 | 支持 | 规模化训练和通用预测能力较强 | 训练数据审计与复现门槛更高 | | 通用多变量路线 | Moirai | 多领域真实时间序列 | Masked Encoder | 支持 | 支持多变量及不同频率任务 | 系统复杂度和计算成本通常更高 | | 传统统计路线 | ARIMA、ETS | 不需要预训练语料 | 显式统计模型 | 不适用 | 可解释、部署成本低 | 面对复杂非线性和跨域任务时能力有限 |
这张表不能替代同一协议下的跑分。不同模型在预测长度、上下文长度、概率预测指标、数据归一化和是否允许适配等方面并不一致,把多个榜单压缩成一个“平均提升百分比”反而容易误导。
截至 2026 年 10 月 18 日,公开资料没有给出一个足以概括全部任务的单一性能数字。 论文完整版本为 38 页,包含 22 幅图和 17 张表,结果需要结合具体数据集、预测范围与指标阅读。项目对自身结果的表述是达到第一梯队的零样本预测精度,而不是在所有基准、所有预测长度上都排名第一。
在缺乏统一数字的情况下,更值得关注的是实验是否回答了三个问题:合成预训练能否稳定迁移到真实数据,线性 RNN 是否在相同计算预算下有优势,以及结果能否排除真实数据泄漏。TempoPFN 对第三个问题给出了目前相当干净的答案,对前两个问题则仍需要更多独立复现。
真正有用的是那套“时间序列出题器”
TempoPFN 最可能产生长期影响的部分,未必是最终模型,而是合成数据生成和增强工具。 官方介绍提到,这套合成数据已经被 Toto-2 和 TS-ICL 使用,说明它正在从单篇论文的训练管线变成可复用的研究基础设施。
时间序列基础模型一直缺少类似图像领域 ImageNet 或文本领域大规模网页语料的公共底座。真实工业数据通常不能公开,公开数据又容易被反复用于训练和评测,最终造成测试集逐渐失去区分度。一个透明、可扩展的生成器库,至少能让研究者明确知道模型学过什么。
对企业开发者而言,合成预训练也降低了冷启动成本。 当业务只有少量历史数据时,团队可以先用通用权重做基线,再决定是否针对本地序列微调;当数据涉及商业机密或隐私时,也可以先在不集中真实数据的条件下验证模型架构和推理链路。
不过,TempoPFN 目前的“单变量”定位必须被认真对待。真实业务预测往往不仅有目标值,还需要价格、天气、节假日、库存和活动计划等协变量。只观察目标序列历史,模型很难预测从历史中没有任何先兆的外部冲击。
这意味着 TempoPFN 更适合做通用零样本基线、无外生变量场景和大批量序列的快速筛选,而不是直接替代完整的需求预测系统。在线上业务中,它仍应与季节性朴素法、ETS、ARIMA 以及企业现有模型同时回测,并通过滚动窗口评估稳定性。
开放程度比模型尺寸更值得肯定
TempoPFN 的开放方式降低了研究者验证论文结论的门槛。 GitHub 仓库提供源代码、配置、数据相关目录和示例,模型权重发布在 Hugging Face,代码采用 Apache 2.0 许可证;开发者既可以直接评估预训练模型,也可以检查合成数据是如何产生的。
官方目前没有在项目首页突出宣传一个夸张的参数规模,这反而符合这项研究的重点。TempoPFN 想证明的不是“参数更多就更准”,而是训练分布、模型归纳偏置与计算结构可以共同决定泛化能力。
对时间序列领域来说,这种思路比继续扩大模型更有现实意义。很多预测任务运行在成本敏感的环境中,需要同时处理数千到数百万条商品、设备或门店序列;单条序列只节省几毫秒,汇总后的计算和能源差异也会十分可观。
我们的判断
TempoPFN 是一次有说服力的路线验证,但还不是时间序列预测的通用终局。 它用完全合成的数据和相对克制的线性架构,挑战了“基础模型必须依靠海量真实语料和 Transformer”的默认假设,这个方向值得比单次榜单名次更多的关注。
它最强的卖点是可审计,而不是神奇。训练数据由程序生成,使评测中的真实数据泄漏更容易排除;生成器、训练代码和权重同时开放,也让其他团队可以修改先验并验证边界。
它最明显的短板同样来自这一设计。生成器没有覆盖的结构,模型无法凭空学会;单变量输入也限制了它对复杂业务因果因素的利用。后续真正决定 TempoPFN 影响力的,将是这套合成任务库能否持续扩展到多变量、外生变量、层级序列和概率校准,而不是模型能否再赢下几个公开数据集。
如果后续独立评测能够确认其在长上下文、批量推理和跨领域预测上的成本优势,TempoPFN 可能成为一个实用的默认基线。它未必会击败每一个专用模型,但它让开发者获得了一把更干净的尺子:先用无真实数据污染的模型测出问题难度,再判断是否值得投入更重的训练和业务特征工程。
参考来源
- TempoPFN GitHub 仓库:项目源代码、配置、示例、许可证及 NeurIPS 2026 接收信息。
- TempoPFN 模型主页:官方发布的模型权重与使用说明。
- Reddit:NeurIPS 2026 接收公告:论文接收、作者名单及合成数据应用情况的社区公告。
- Reddit:TempoPFN 早期研究讨论:围绕线性 RNN、合成预训练和零样本预测的社区讨论。