Arena周榜三款新模型入局
Arena 2026年第42周榜单出炉,Gemini 3.5 Flash、MiMo V2.6 Pro与FLUX 2 Flex新入榜。头部格局未变,但国产模型在代码与前端开发场景继续上探。
三款新模型入榜,真正的变化发生在细分赛道
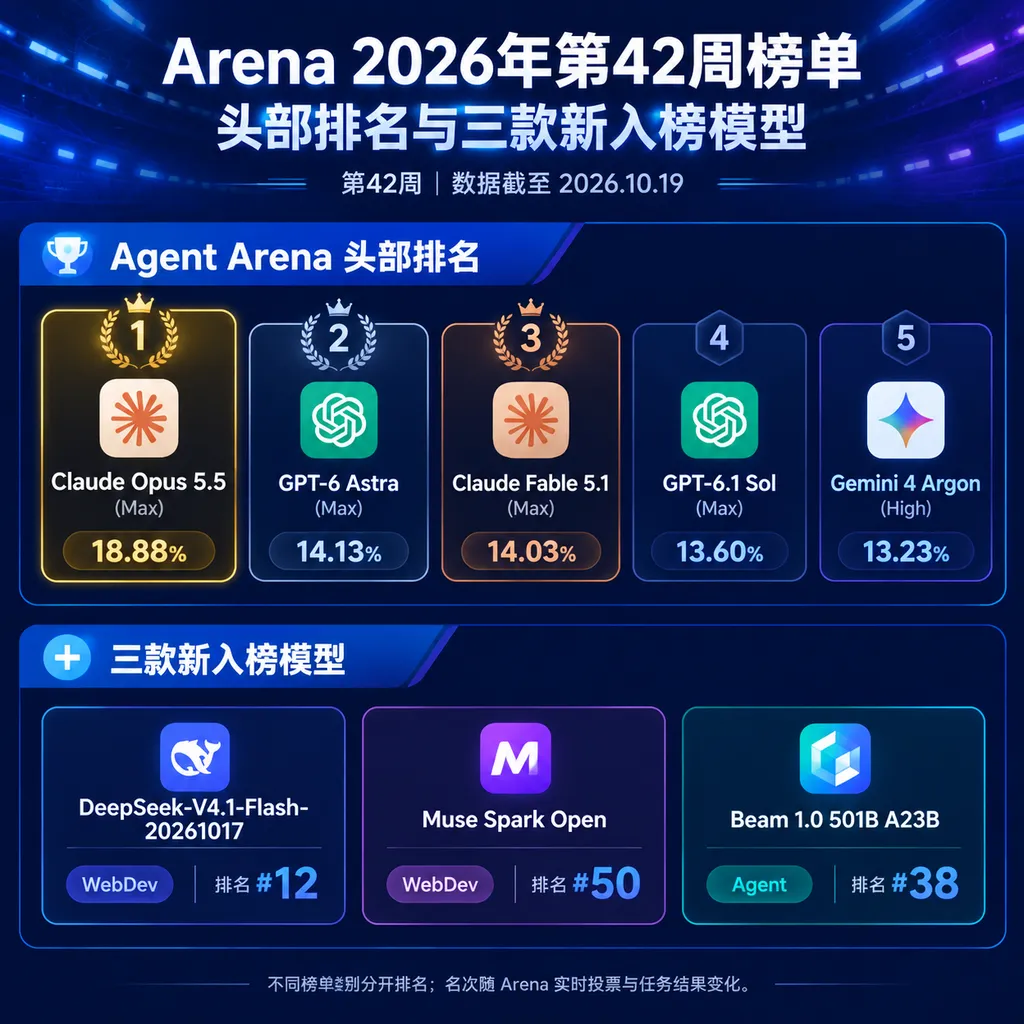
Arena 在 10 月 19 日公布了 2026 年第 42 周 AI 大模型榜单,统计周期为 10 月 12 日至 10 月 18 日。Gemini 3.5 Flash Medium、MiMo V2.6 Pro 与 FLUX 2 Flex 是本周三款新进入相关榜单的模型,其中 Gemini 3.5 Flash Medium 在综合榜排到第 30,MiMo V2.6 Pro 在前端开发榜首次进入前 20,FLUX 2 Flex 则为图像模型榜带来新的竞争者。
本周榜单最值得关注的并不是综合榜冠军易主,而是快速模型、国产代码模型和可控图像模型同时进入有效排名。Google、Anthropic 继续控制综合榜最前排,小米、月之暗面、阿里和智谱则在中上游形成相对稳定的国产模型梯队,竞争开始从“有没有旗舰模型”转向“能否在代码、前端、长文本和成本等具体场景占住位置”。
先看结果:综合榜没有洗牌,但前30更拥挤了
**Arena 综合榜是基于用户匿名两两盲选结果计算的模型偏好排名,衡量的是回答更受用户喜欢的概率,而不是一套固定试卷上的绝对能力。**本期 Gemini 4 Argon High 以 1525 分继续排名第一,Claude Opus 5.5 High 以 1507 分排名第二,Claude Opus 4.6 High 和 Claude Fable 5 High 均为 1504 分,并列第三。
头部模型之间的差距仍然很小。榜单前 10 名全部达到 1494 分以上,第一名与第十名最多只差 31 分;按照 Arena 对置信区间和接近竞争关系的处理方式,这种分差不足以支持“某个模型已经全面碾压其他模型”的结论。
| 综合榜位置 | 模型 | 厂商 | ELO 分数 | 本周信号 | |---:|---|---|---:|---| | 1 | gemini-4-argon-high | Google | 1525 | 蝉联第一 | | 2 | claude-opus-5.5-high | Anthropic | 1507 | 位列第二 | | 3 | claude-opus-4-6-high | Anthropic | 1504 | 并列第三 | | 3 | claude-fable-5-high | Anthropic | 1504 | 并列第三 | | 16 | kimi-k3-max | 月之暗面 | 1488 | 国产模型最高位 | | 22 | qwen3.8-max | 阿里 | 1483 | 排名保持稳定 | | 26 | mimo-v2.6-pro | 小米 | 1480 | 进入国产第一梯队 | | 27 | glm-5.3-max | 智谱 | 1478 | 与MiMo仅差2分 | | 30 | gemini-3.5-flash-medium | Google | 1476 | 本周新入综合榜 |
Gemini 3.5 Flash Medium 首次获得正式排名便来到第 30 位,ELO 为 1476 分。这个成绩距离综合榜第 16 位的 Kimi K3 Max 只有 12 分,距离第 27 位的 GLM 5.3 Max也只有2分,说明它至少已经进入当前主流旗舰与次旗舰模型密集交战的分数区间。
Gemini 3.5 Flash Medium 是 Gemini 3.5 Flash 系列在 Arena 中使用中等推理配置的参评版本。“Flash”通常指向更低延迟、更高吞吐和更容易规模化部署的产品定位,而“Medium”更可能代表 Arena 测试时采用的推理强度或计算预算档位,不能简单等同于一个完全独立的基础模型。
Gemini 3.5 Flash Medium 的第 30 名不能被解读为能力不足。对于快速模型而言,真正的竞争对象并不只是 Gemini 4 Argon High、Claude Opus 5.5 High 这样的高计算预算模型,还包括同样强调响应速度和单位任务成本的轻量版本;如果它能以更低延迟维持 1476 分,其商业价值可能高于名次本身。
国产模型站稳中上游,但还没有击穿综合榜头部
**国产模型在第 42 周综合榜形成了从第 16名到第27名的连续中上游梯队。**Kimi K3 Max 以 1488 分排名第 16,是本期位置最高的国产模型;Qwen 3.8 Max 以 1483 分排名第 22;MiMo V2.6 Pro 和 GLM 5.3 Max 分别以 1480 分、1478 分排名第 26 和第 27。
这组数据说明国产头部模型已经摆脱“偶尔冲榜、随后快速回落”的早期状态。四款模型之间最大分差只有 10 分,而且本周排名基本稳定,意味着它们面对的已经不是能否进入主流视野的问题,而是如何跨过 1490 分至 1500 分附近的拥挤区间。
国产模型与榜首之间仍有明确距离。Kimi K3 Max 比 Gemini 4 Argon High 低 37 分,比 Claude Opus 5.5 High 低 19 分;考虑到榜首模型的置信区间以及用户偏好波动,这不是不可追赶的鸿沟,但也不能因为个别任务体验接近,就宣称综合能力已经完全持平。
| 国产模型 | 综合榜排名 | ELO 分数 | 与国产最高分差距 | 主要观察点 | |---|---:|---:|---:|---| | kimi-k3-max | 16 | 1488 | 0 | 代码榜进入前十,综合表现最稳 | | qwen3.8-max | 22 | 1483 | 5 | 综合能力均衡,位置稳定 | | mimo-v2.6-pro | 26 | 1480 | 8 | 前端开发榜首次进入前20 | | glm-5.3-max | 27 | 1478 | 10 | 紧贴MiMo,仍处于同一竞争区间 |
**国产模型当前最有现实意义的进展发生在代码赛道。**Kimi K3 Max 已经稳定进入代码榜前十,MiMo V2.6 Pro 则首次进入前端开发榜前 20,这类细分榜成绩比综合榜上升两三个名次更能说明产品价值,因为开发者最终购买的是完成任务的能力,而不是一个抽象总分。
MiMo V2.6 Pro进前端榜前20,小米押中了一个高价值场景
**MiMo V2.6 Pro 是小米面向复杂推理、代码生成和智能体任务打造的高能力模型版本。**它本周在前端开发榜以 1629 分排名第 19,首次进入该榜前 20;同一榜单中,Claude Opus 5.5 Max 以 1813 分排名第一,GPT 6 Astra Max 以 1786 分排名第二,Claude Sonnet 5.5 XHigh 以 1774 分排名第三。
| 前端开发榜位置 | 模型 | ELO 分数 | 与榜首差距 | |---:|---|---:|---:| | 1 | claude-opus-5.5-max | 1813 | 0 | | 2 | gpt-6-astra-max | 1786 | 27 | | 3 | claude-sonnet-5.5-xhigh | 1774 | 39 | | 19 | mimo-v2.6-pro | 1629 | 184 |
MiMo V2.6 Pro 的前 20 成绩值得肯定,但距离第一梯队仍有 145 分至 184 分的明显差距。前端开发榜考验的不只是生成一段能运行的 JavaScript,还包括需求理解、页面结构、视觉还原、交互完整性和多轮修改稳定性;第 19 名意味着它已经具备实用竞争力,却还没有进入可以正面挑战 Claude 与 GPT 顶级版本的位置。
前端开发也是比传统算法题更接近真实交付的测试场景。一个模型可能会写排序算法,却未必能把一个包含响应式布局、状态管理、表单校验和视觉细节的页面一次做对,因此 MiMo 的进榜更能体现工程能力,而不是训练数据中背过多少题。
小米模型进入这一赛道还有一层产品意义。前端生成可以与手机系统、IoT 控制台、应用原型和内部研发工具结合,模型即使没有拿到综合榜前三,只要能在高频工程任务中控制成本并保持稳定,就可能比纯聊天榜名次更容易转化成实际使用量。
Kimi K3 Max进入代码榜前十,比综合榜第16更重要
**Kimi K3 Max 稳定进入代码榜前十,是本周国产模型最具含金量的排名变化。**代码任务具有较强的可验证性,程序能否运行、测试是否通过、修改是否引入回归,都比开放式聊天更容易建立客观反馈,因此代码榜前十通常意味着模型已经能进入真实开发工作流的候选名单。
Kimi K3 Max 在综合榜以 1488 分排名第 16,说明它并不是只靠单一代码能力冲高。综合偏好与代码能力同时处于前列,通常意味着模型在需求澄清、长上下文理解、错误定位和解释质量上没有明显短板,这些能力决定了代码助手能否从“自动补全工具”升级为可持续协作的开发代理。
代码榜成绩仍然不能代替仓库级评测。Arena 更擅长比较用户对单次或多轮回答的偏好,而真实软件工程还涉及跨文件依赖、构建环境、测试执行和数小时任务连续性;开发者在选型时,仍应把仓库级修复成功率、工具调用稳定性和单位完成任务成本放在同一张表里看。
FLUX 2 Flex入榜,图像模型开始比拼“可控性”而非只看画质
**FLUX 2 Flex 是本周新进入 Arena 图像相关榜单的生成模型。**现有参考信息没有给出它的具体名次、分数和票数,因此目前能确认的是它已经达到 Arena 正式展示排名所需的最低有效样本条件,而不能据此判断它已进入图像榜头部。
FLUX 2 Flex 的名称释放出一个清晰信号:图像模型正在从固定档位转向更灵活的生成配置。对于实际工作流,用户关心的不只是第一张图是否惊艳,还包括提示词遵循、文字渲染、角色一致性、局部编辑、尺寸适配和迭代速度;“Flex”如果对应更灵活的质量与速度平衡,其价值会更多体现在批量素材生产,而不是单张样片展示。
图像 Arena 的主观性通常比文本榜更强。不同用户对写实、审美、构图和风格的偏好差异巨大,一张更华丽的图片也可能因为没有严格遵循提示词而失票,因此 FLUX 2 Flex 后续是否值得关注,要看它在积累更多投票后能否保持排名,而不是只看首周入榜。
Arena榜单该怎么看:ELO不是考试分数,误差也不能省略
**ELO 是一种根据两两对战结果动态估算相对强弱的评分系统。**它最早广泛用于棋类排名,在 Arena 中则把同一个提示词交给两个匿名模型,再根据用户选择更新双方分数;击败高分模型通常比击败低分模型获得更多分数。
Arena 的优势是减少品牌偏见。用户投票时看不到模型名称,至少可以降低“因为相信某家公司,所以觉得它回答更好”的先入为主影响,也能覆盖固定基准难以穷举的开放问题、写作风格和真实使用需求。
Arena 的局限是用户偏好不等于事实正确率。更长、更自信或排版更漂亮的回答可能得到更多票,但它未必更准确;安全策略、拒答边界和回答语言也会影响结果,因此榜单尤其适合观察产品体验,却不适合作为医疗、法律、数学证明或生产代码正确性的唯一依据。
置信区间决定了相邻名次是否真的有差异。以本周榜首为例,Gemini 4 Argon High 为 1525±9,Claude Opus 5.5 High 为 1507±8;当模型区间接近或重叠时,单纯比较榜单序号会放大统计噪声。新模型还容易受到样本量较少、提示词构成变化和早期关注度集中的影响,至少需要连续观察数周。
不同分榜之间也不能直接比较分数。综合榜的 1480 分、代码榜的 1480 分和前端开发榜的 1480 分来自不同对局与参评模型集合,它们没有统一标尺,把这些数字横向相减没有统计意义。
这期榜单释放了三个信号
**第一个信号是旗舰模型的领先优势正在从“绝对统治”变成“高位胶着”。**综合榜前 10 全部在 1494 分以上,用户已经越来越难仅凭一次回答稳定区分头部模型,模型厂商下一阶段需要争夺的会是可靠性、速度和成本,而不只是更高的峰值能力。
**第二个信号是国产模型已经站稳主流区间,但突破综合榜前十仍是下一道门槛。**Kimi、Qwen、MiMo 和 GLM 集中在第 16 至第 27 名,说明国产头部模型不是孤立的单点突破,但与 Google、Anthropic 最强档位相比仍缺少一个稳定进入综合前十的代表。
**第三个信号是细分榜正在比综合榜更早暴露产品机会。**Kimi K3 Max 的代码榜前十、MiMo V2.6 Pro 的前端榜第 19,以及 FLUX 2 Flex 进入图像榜,分别对应软件开发、界面生成和视觉内容生产三个可直接落地的方向。
本周榜单因此更像一次结构性更新,而不是冠军争夺战。Gemini 3.5 Flash Medium 证明快速模型可以贴近旗舰密集区,MiMo V2.6 Pro 证明国产模型能在前端开发中取得有效席位,FLUX 2 Flex 则让图像生成的可控性竞争继续升温;但三款模型都还需要更多票数和连续周数据,才能判断首周表现究竟是稳定能力,还是短期样本波动。
参考来源
- IT之家:Arena公布2026年第42周AI大模型周榜——提供本周统计周期、综合榜与前端开发榜排名、新入榜模型及国产模型表现等数据。