3D空间推理,Agent的新考场
SketchAgentBench 用 25 个参考场景、275 次运行和 1120 次盲评,测试 11 款 LLM Agent 能否通过代码、渲染与视觉反馈还原 3D 世界。它测的不只是建模,而是 Agent 能否在真实反馈中发现并修正空间错误。
3D空间推理,Agent的新考场
LLM Agent 的评测正在从“能不能把代码写对”,走向“能不能用代码把一个三维世界搭对”。 11 月 6 日上线的 SketchAgentBench,把 11 款模型放进浏览器里的 Three.js 3D 环境,要求它们根据参考图片编写场景代码、查看渲染结果,再继续调整几何结构、材质和相机。
首版评测包含 25 个参考场景,共完成 275 次 Agent 运行,并通过 1120 次匿名视觉模型投票换算 Elo 排名。公开结果中,Gemini 4 Argon 暂居第一;Claude Sonnet 5.5 被设为 1000 分的 Elo 基准点。(oursignal.com)
SketchAgentBench 是一个面向 3D 编程 Agent 的空间推理基准。 它不让模型在选择题里判断“红色方块在蓝色球体左边还是右边”,而是要求模型真正生成可执行的 3D 场景,并通过渲染画面证明自己理解了物体的形状、位置、比例与遮挡关系。
这不是又一个看起来热闹、实际只测提示词审美的 Demo。它真正有价值的地方,是把空间推理、代码生成、工具使用和视觉自我修正塞进了同一个任务循环。
它具体怎么考模型
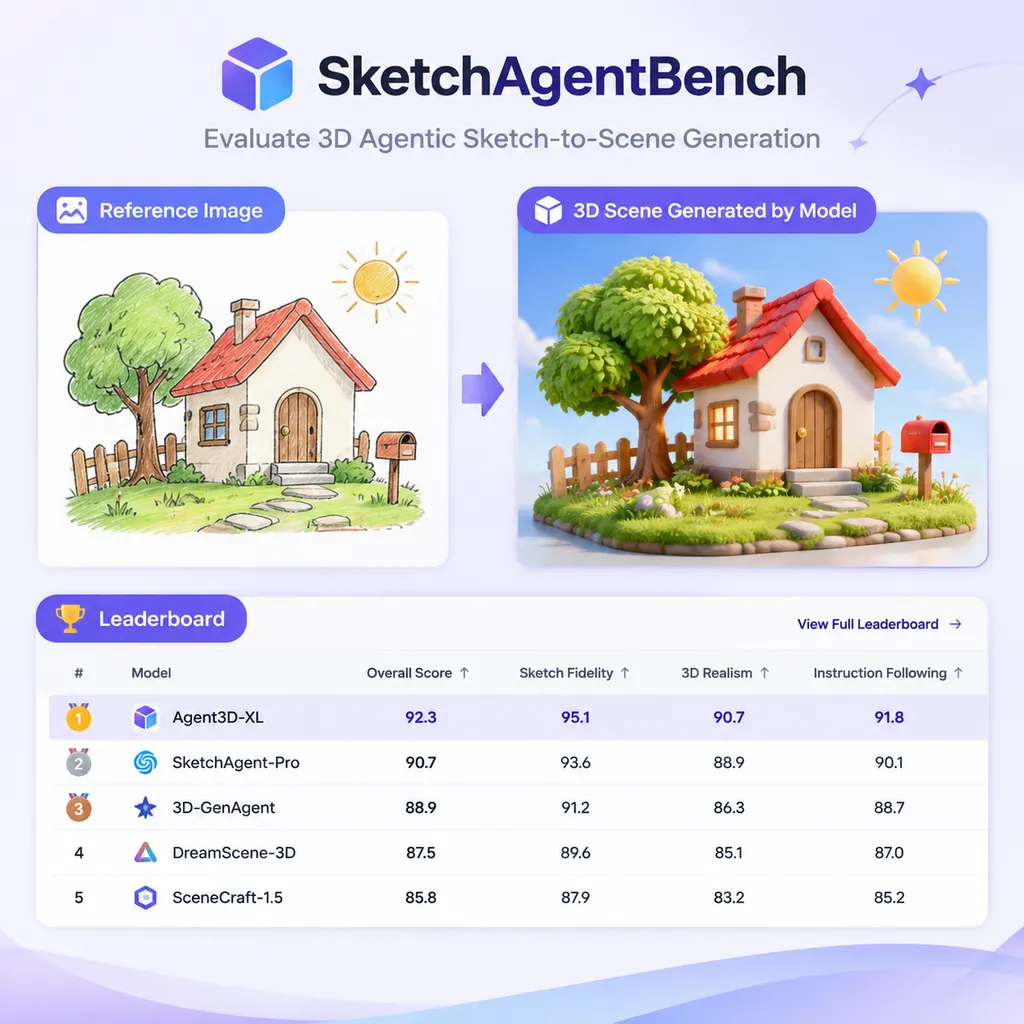
SketchAgentBench 的核心流程是“观察—编码—渲染—检查—修改”。 Agent 首先看到一张参考图片,然后在一个浏览器 Three.js Playground 中编写代码,构建几何体、灯光、材质和相机,接着查看实际渲染画面,并根据视觉反馈继续修改。
这个过程和普通的文生代码评测区别很大。
传统代码 Benchmark 往往有明确的单元测试:函数输入 2 和 3,输出是不是 5;仓库里的 Bug 修完后,测试套件能不能通过。但 3D 场景很少存在唯一答案。一只茶壶可以由球体和圆柱体拼出来,也可以通过曲线旋转成型;多伦多天际线可以使用精细模型,也可以用几十个长方体近似。
3D Agent 面对的是一个“解法不唯一、结果必须看起来正确”的问题。 代码能运行,只能说明语法没错;真正困难的是生成结果是否具有正确的空间关系。
例如,模型可能成功生成一栋小屋,但烟囱悬在屋顶上方;也可能搭出一个书架,但所有隔板都挤在同一高度。对代码执行器来说,这些程序完全合法,对人类视觉来说却明显错误。
SketchAgentBench 官方反馈仓库目前列出的公开任务主题包括 cottage、bookcase、tea set、Toronto skyline 和 Pikachu,即小屋、书架、茶具、多伦多天际线和皮卡丘。这个组合有意覆盖了建筑结构、规则家具、曲面器皿、复杂城市轮廓和角色造型几类不同的空间问题。(github.com)
| 评测环节 | 模型需要完成什么 | 实际考察能力 | |---|---|---| | 观察参考图 | 识别物体、部件与遮挡关系 | 视觉理解、物体分解 | | 编写场景代码 | 创建几何体、材质、灯光和相机 | 代码生成、Three.js 使用 | | 首次渲染 | 把抽象代码变成可见结果 | 工具调用、执行可靠性 | | 检查画面 | 找出比例、位置与视角错误 | 视觉比较、空间推理 | | 迭代修改 | 调整参数或重构场景 | 自我纠错、长程任务规划 | | 最终盲评 | 与其他模型生成结果两两比较 | 综合视觉相似度与完成度 |
Gemini领先,但排行榜不是全部
Gemini 4 Argon 暂时领先,说明强视觉能力和强编码能力正在同一批模型上汇合。 在这类任务里,单独擅长写代码或者单独擅长看图都不够:模型需要把参考图转换成一套可执行的空间表示,还要理解渲染画面为什么和目标不同。
SketchAgentBench 首版使用 11 款 LLM Agent、25 个参考场景和 275 次运行,并将 1120 次匿名视觉模型投票转换为 Elo 分数。这个设计比简单计算 CLIP 相似度更接近人类判断,因为评判者可以综合观察构图、形状、颜色和整体完成度,而不是只比较两个向量之间的距离。(oursignal.com)
Elo 排名更适合回答“哪个结果更好”,却不适合解释“模型具体哪里更强”。 一个模型可能特别擅长调整相机,让最终截图更像参考图,但实际物体背面的结构完全错误;另一个模型可能搭出了更完整的三维结构,却因为灯光和视角不讨巧而输掉视觉投票。
因此,Gemini 4 Argon 排名第一可以说明它在这套任务和评判机制下表现最好,但不能直接推导出它拥有最强的通用空间智能。
这也是我们对 SketchAgentBench 的第一个判断:它是一套很有产品感的 Agent 评测,但暂时还不是一套足够严谨的几何能力测量仪。
为什么这比普通3D问答更难
空间推理不是识别物体名称,而是理解物体在三维世界中如何相互约束。 模型需要判断茶壶嘴应该从壶身哪个位置伸出、书架隔板应该如何分布、屋顶斜面与墙体如何连接,以及相机放在哪里才能呈现与参考图接近的透视关系。
一张二维图片还会主动隐藏信息。模型只能看到物体的一个投影视角,看不到背面和内部结构,却必须构造一个能够从当前视角正确渲染的三维场景。
这本质上是一个欠约束问题。 同一张参考图可能对应无数种三维结构,Agent 必须在视觉相似度、几何合理性和实现成本之间寻找一个足够好的解。
更麻烦的是,3D 场景里的错误会互相掩盖。相机角度不对时,模型可能误以为物体比例不对;灯光太暗时,模型可能继续修改材质;一个部件被遮挡时,模型甚至不知道自己是否已经创建了它。
这和真实 Agent 工作非常接近。现实中的 Agent 很少能直接拿到“第 37 行代码错了”这种干净反馈,它看到的通常只是网页布局不对、按钮点不到、图表没有出现,或者三维场景和目标不像。
3D Agent评测突然变多了
SketchAgentBench 并不是孤立项目,而是 2026 年快速升温的 Agentic 3D 评测路线之一。 这一方向的共同目标,是把模型从被动回答空间问题,推进到主动操作工具、构建场景并验证结果。
| 基准 | 主要任务 | 规模 | 交互环境 | 评分方式 | 最值得关注的能力 | |---|---|---:|---|---|---| | SketchAgentBench | 根据参考图片重建完整场景 | 25 个场景、11 款模型、275 次运行 | 浏览器 Three.js | 1120 次盲评投票与 Elo | 轻量、直观的视觉迭代能力 | | 3DCodeBench | 从文本或图片生成程序化 3D 模型 | 212 个任务、评测 12 款 VLM | Blender 代码环境 | 自动指标与人类偏好排名 | 复杂 3D API 和程序化建模 | | SceneActBench | 在完整多物体场景中执行布局、相机、关节和动态任务 | 210 个源实例、520 个任务样例 | Blender Agent 环境 | 隐藏真值与几何指标 | 精确场景操作与动作执行 | | ESI-Bench | 主动移动、观察和操作物体以解决空间问题 | 10 类任务、29 个子类 | OmniGibson 仿真环境 | 被动、主动与 Oracle 条件准确率 | 感知—行动闭环与探索策略 |
3DCodeBench 是一套通过代码评估 VLM 程序化 3D 建模能力的基准,任务同时覆盖文生 3D 和图生 3D。其公开数据集包含 212 个 Blender 5.0 Python 建模任务,参考结果从多个固定方位渲染。(huggingface.co)
SceneActBench 是一套评估视觉语言 Agent 能否操作完整多物体三维场景的基准,包含五类任务、210 个源实例和 520 个任务样例。11 种模型配置的综合分数仅分布在 38.6 至 50.2 之间,而且没有任何模型能在所有任务上稳定领先。(huggingface.co)
ESI-Bench 是一套强调主动感知与行动闭环的具身空间智能基准,要求 Agent 自己决定移动到哪里、观察什么,以及是否需要操作物体。研究发现,当前模型的主要问题并不是“看不懂”,而是经常选择错误动作,继而获得错误视角并触发连锁失败。(huggingface.co)
SketchAgentBench 的定位更像一座轻量化的“3D Agent Arena”。 它没有 SceneActBench 那样严格的隐藏几何真值,也没有 ESI-Bench 那样复杂的物理交互,但部署成本更低,结果也更容易被开发者直接看懂。
你不需要分析 ADD-S、角度误差或表面重建容差,只要把两个模型生成的小屋放在一起,通常几秒钟就能判断哪个更像。
真正测到的是空间智能吗
SketchAgentBench 测到的是“通过代码解决视觉空间任务的综合能力”,而不是纯粹的空间推理能力。 一个模型得分低,可能不是因为它不理解三维关系,而是因为它不熟悉 Three.js、没有正确设置相机,或者生成的代码在执行时失败。
这类复合评测的优势是更接近真实产品,劣势是难以定位能力瓶颈。
| 失败现象 | 可能原因 | |---|---| | 物体缺失 | 视觉识别失败,或代码未成功执行 | | 部件位置错误 | 空间关系理解错误,或坐标系使用错误 | | 形状粗糙 | 建模策略过于简单,或工具知识不足 | | 画面不像参考图 | 相机、光照、材质或几何结构均可能有问题 | | 多轮修改后反而变差 | Agent 缺乏稳定的误差诊断和版本控制能力 |
视觉模型参与评分还会带来“模型评模型”的循环问题。 如果投票模型偏好更鲜艳的材质、更居中的构图或更具插画感的结果,参赛 Agent 就可能通过视觉风格赢得投票,而不是依靠更准确的空间结构。
1120 次投票能够降低单次判断的随机性,却无法自动消除系统性偏好。更理想的方案,是同时公布视觉 Elo、代码执行成功率、平均迭代轮数、调用成本,以及关键部件的几何误差。
25 个参考场景也不足以支撑过于宽泛的结论。 五类公开任务覆盖了几种典型造型,但距离室内设计、工业 CAD、游戏关卡、机械装配和机器人操作仍有明显距离。
首版排行榜因此更适合看趋势,而不是拿来证明某个模型已经“解决了 3D 空间推理”。
对开发者真正有用的地方
SketchAgentBench 最有价值的产物可能不是榜单,而是它展示的 Agent 工作方式。 一个可用的 3D Agent 不应该只输出一大段代码然后结束,而应该能持续观察执行结果、判断偏差来源,并选择最小修改方案。
这种能力可以迁移到很多实际开发场景:
- 前端 Agent 根据截图还原网页,并通过浏览器截图持续校正布局;
- 数据 Agent 生成图表后检查坐标轴、标签遮挡和视觉层级;
- 游戏开发 Agent 搭建关卡后检查碰撞、视角和物体分布;
- 建筑设计 Agent 根据草图生成可交互空间,并检查门窗、墙体和家具关系;
- 机器人 Agent 根据新视角修正对物体位置和可操作区域的判断。
开发者评估模型时,也应该开始关注“闭环表现”而不是单次生成效果。 模型第一次生成得不够好并不可怕,真正决定 Agent 可用性的,是它能不能理解反馈,以及第二次修改是否朝正确方向前进。
一个模型如果首次结果只有 60 分,但两轮修改后稳定达到 90 分,通常比首次达到 80 分、随后越改越乱的模型更适合部署。
这也是未来 Agent Benchmark 应该增加的数据:成功率之外,还要报告平均行动步数、执行失败率、Token 消耗、完成时间和自我修复成功率。
这次发布意味着什么
SketchAgentBench 说明 3D 正在成为编码 Agent 的新压力测试。 过去一年,模型厂商不断刷新数学、编程和知识问答成绩,但这些静态测试越来越难区分模型是否具备真正的环境理解能力。
3D 场景提供了一个天然的综合考场。模型必须写代码,但代码只是手段;模型必须看图,但看懂也只是起点;模型最终还要让一个可执行环境产生正确结果。
这种评测比传统跑分更接近我们对 Agent 的实际期待。 Agent 不是把答案写在聊天框里,而是进入环境、采取行动、检查后果并继续工作。
SketchAgentBench 当前规模不大,评判方式也仍有改进空间,但方向是对的。它把一个长期被拆开测试的问题重新合了起来:模型是否能把视觉理解转换为代码,把代码转换为三维结果,再根据结果修正自己的理解。
如果说传统空间推理题是在问模型“你知道左和右吗”,那么 SketchAgentBench 问的是:你能不能亲手把它搭出来,并在搭错以后自己发现?
答案目前还不稳定,但这恰恰是这套基准值得关注的原因。
参考来源
- TabbyML / SketchAgentBench 官方反馈仓库:提供排行榜、Playground 入口与当前公开任务主题。
- 3DCodeBench 论文页面:介绍程序化 3D 建模 Agent 的任务设计与主要发现。
- 3DCodeBench 数据集说明:列出 212 个 Blender 5.0 Python 建模任务及数据结构。
- SceneActBench 论文页面:介绍五类多物体 3D 场景操作任务和 520 个评测样例。
- SceneActBench GitHub 仓库:提供模型成绩、几何指标、数据来源与运行环境。
- ESI-Bench 论文页面:讨论主动空间探索、感知—行动闭环与 Action Blindness 问题。
- Qwen3.7-Max 空间推理与 3D 建模实测:展示模型将抽象空间需求转换为可交互 3D 产品原型的应用案例。