Anthropic神秘模型三天破猜想
PSI 使用 Anthropic 未公开模型,在第三天完成一项悬而未决 18 年的量子计算猜想证明,并交由 Lean 4 逐步验证。真正值得关注的,是 AI 科研 Agent 开始把开放问题探索、论文写作与形式化验证串成完整流程。
Anthropic 未发布模型三天证明量子计算猜想,AI 科研 Agent 再进一步
一家规模不大的物理研究机构,用 Anthropic 尚未公开的模型,在第三天完成了一个悬而未决 18 年的量子计算猜想证明。
11 月 6 日,Physical Superintelligence(下称 PSI)宣布,其内部研究系统证明了阿伦森-安拜尼斯猜想。该系统由 PSI 研究人员 David Turturean 开发,运行在 PSI 自有基础设施上,核心模型来自 Anthropic,但具体型号、参数规模和推理成本均未公开。
这不是一次只输出论文草稿的语言模型演示。PSI 表示,系统在运行第三天得到完整证明,随后又两次改进结果,并将证明写成 Lean 4 可以检查的形式。公开仓库显示,最终四个定理没有使用占位符或额外公理,并通过两个独立实现的 Lean 内核重新检查。(github.com)
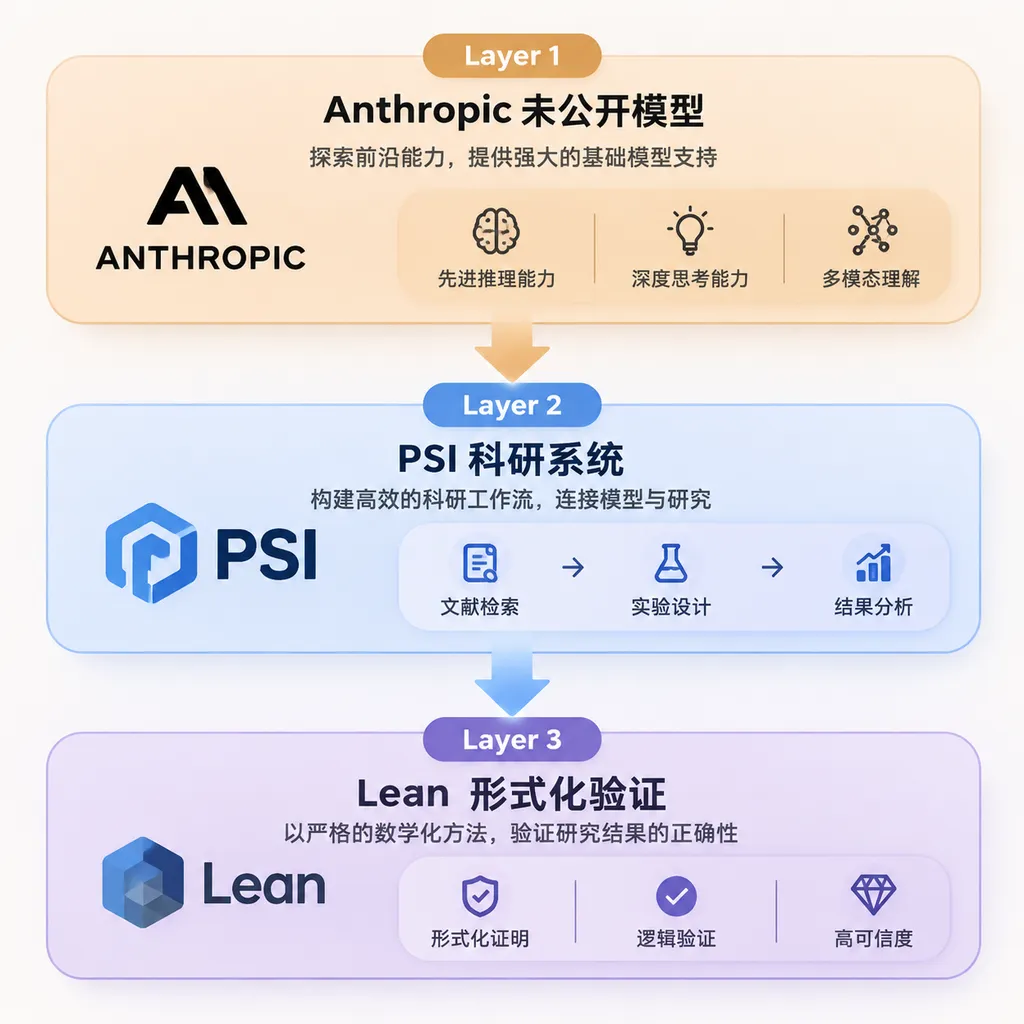
这项工作的意义不是“AI 又做对了一道数学题”,而是前沿模型首次在量子复杂性理论的核心开放问题上,交出了一套可以公开复现、逐步审计的完整证明链条。
它究竟证明了什么
阿伦森-安拜尼斯猜想是一个关于低阶有界多项式必然存在高影响力变量的数学命题。
这个定义听起来和量子计算关系不大,但它实际约束的是量子计算机在什么条件下能够获得指数级加速。
量子查询复杂度是衡量算法为了回答一个问题,需要读取多少次输入信息的理论模型。普通算法每次读取一个输入位;量子算法则可以通过叠加态,让一次查询同时作用于多个位置。Shor 算法之所以能在大整数分解上展现巨大优势,依赖的正是输入中存在周期性结构。
问题在于:如果输入是随机的,没有周期、对称性或其他特殊规律,量子计算机还能不能获得指数级优势?
Scott Aaronson 和 Andris Ambainis 发现,量子算法经过 T 次查询后,其输出“是”的概率可以表示为一个次数不超过 2T 的多项式。如果能够证明所有取值被限制在一定范围、同时具有非零方差的低阶多项式,都至少存在一个“影响力足够大”的变量,那么经典算法就可以优先读取这些关键变量,逐步逼近量子算法的输出。
变量影响力是指翻转某个输入位后,函数输出平均会发生多大变化。
可以把它理解为在一张极其复杂的决策表中寻找关键开关:如果输出确实会变化,就必然存在至少一个开关对结果产生可检测的影响。经典算法不需要读取整张表,只要持续找到并检查这些关键开关,就能以多项式级的额外成本模仿量子算法。
PSI 给出的结果不仅证明“关键变量存在”,还提供了显式下界。对于次数不超过 d、方差至少为 ε 的有界多项式,至少存在一个变量,其影响力不低于一个与 ε^(5/2) / d^6 成正比的数值,并进一步满足猜想要求的 (ε/d)^7 形式。(github.com)
这正是猜想需要的多项式下界,而不是一个只能覆盖特殊输入或特定次数的弱化版本。
量子计算没有因此“失去意义”
这项证明限制的是随机、无结构输入上的量子查询优势,而不是所有量子算法的运行速度。
最容易出现的误读,是把结果概括为“量子计算机不比经典计算机快”。这显然不准确。
证明真正表达的是:如果一个问题的输入接近随机分布,同时没有额外承诺条件,那么量子算法通常无法凭空获得指数级查询优势。想实现巨大的加速,问题本身往往需要存在可以被量子算法利用的结构。
Shor 算法依赖周期结构,Grover 搜索提供的是平方级加速,而不是指数级加速。量子模拟、密码分析和部分线性代数任务同样建立在特定数学结构之上。阿伦森-安拜尼斯猜想被证明后,这些已知优势并没有消失。
更准确的说法是,量子计算的优势不是免费的。量子叠加可以扩大搜索和计算方式,但不能让一个完全无结构的问题自动变得容易。
| 场景 | 输入是否具有结构 | 可能的量子优势 | 本次证明的影响 | |---|---:|---:|---| | Shor 大整数分解 | 有明显周期结构 | 可实现超多项式级优势 | 不受否定 | | Grover 无序搜索 | 结构较弱 | 平方级加速 | 与结论一致 | | 随机输入上的一般查询问题 | 基本无结构 | 难以获得指数级优势 | 本次证明覆盖的核心方向 | | 量子硬件运行速度与纠错 | 取决于工程实现 | 尚受噪声和规模限制 | 不属于该猜想讨论范围 |
因此,这项成果更像是在量子计算的能力地图上画出一条边界,而不是宣布量子路线失败。
三天得到证明,关键不只是模型变强
AI 科研 Agent 是能够持续调用文献、计算工具和验证系统,自主推进多步骤研究任务的人工智能系统。
PSI 没有把成功简单归因于一次提示词或一段超长上下文,而是强调其内部搭建的 research system。公开信息没有披露 Agent 数量、总 Token 消耗、运行轮次和具体工具链,但从最终产物看,这个系统至少完成了四类工作:
- 从既有论文中定位可以组合的数学工具;
- 搜索并筛选可能成立的证明路线;
- 把自然语言证明转写为 Lean 4 形式化代码;
- 在证明失败或边界不够强时继续修改,并重新验证。
这比“模型回答一个数学问题”复杂得多。开放问题没有标准答案,也没有测试集可以即时打分。系统必须自己判断一条路线是否值得继续、某个引理是否足够强,以及最终结果到底证明了原猜想,还是只证明了一个看似接近的弱化版本。
PSI 的价值首先体现在工程闭环上:它没有让模型停在一篇读起来合理的论文,而是要求模型把关键命题交给形式化系统检查。
Lean 是一种定理证明器,它会根据明确的逻辑规则逐步检查证明,而不是根据语言是否通顺判断答案。
大模型可以写出极具说服力的错误论证,Lean 则要求每一步都能由定义、公理和已有定理推出。对于长达几十页、依赖多个数学分支的证明,这相当于把“同行觉得似乎没问题”变成“计算机确认逻辑步骤可以通过”。
从黎曼猜想到量子复杂性,科研 Agent 的工作方式正在定型
2026 年的 AI 数学突破开始从单模型推理,转向多 Agent 搜索、工具调用和形式化验证的组合。
今年 8 月,Anthropic 曾让一个未公开研究版 Claude 尝试黎曼猜想。模型没有证明黎曼猜想,却将可以证明位于临界线上的黎曼 ζ 函数零点比例下界,从 41.6% 提高到 67.2%。两轮运行合计生成约 3100 万个输出 Token,第二轮组织约 60 个子 Agent,执行约 2400 条 Shell 命令,并编写数百个 Python 脚本。(m.ithome.com)
阿伦森-安拜尼斯猜想这次更进一步:目标不是竞赛题或已有答案的形式化补全,而是一个仍处于研究前沿的完整开放问题。
| 案例 | 原始目标 | 最终结果 | Agent 规模 | 验证方式 | |---|---|---|---:|---| | Claude 挑战黎曼猜想 | 证明或推进黎曼猜想 | 未解决主问题,将相关下界从 41.6% 提高至 67.2% | 约 60 个子 Agent、3100 万输出 Token | 数学家审阅与形式化证明 | | PSI 证明阿伦森-安拜尼斯猜想 | 解决完整开放猜想 | 第三天得到完整证明,之后两次改进 | 未披露 | Lean 4 完整形式化、双内核复查 |
两个案例共同显示,模型最有价值的能力未必是凭空发明一套全新数学体系,而是把分散在不同时代、不同论文和不同研究方向中的知识重新组合,并在巨大的搜索空间中持续试错。
人类研究者可能阅读几十篇核心论文,再凭经验选择少量路线。科研 Agent 可以并行探索数百条路线,让部分 Agent 提出假设,部分 Agent 搜索反例,部分 Agent 检查引用,最后再让形式化系统负责逻辑验收。
这更像一支速度极快、成本暂时未知的数字研究团队,而不是一位无所不知的“AI 数学家”。
Lean 通过,不等于争议已经结束
形式化验证可以证明逻辑推导成立,但不能自动保证形式化命题与人类想解决的问题完全一致。
PSI 的公开仓库已经做了相当严格的检查:核心定理没有 sorry 占位符,没有自行添加公理,没有绕过 Lean 内核的危险声明;项目还记录了公理审计、源码摘要和重放日志。仓库同时标明,论文面向人类阅读,论文中的部分解释、历史背景和开放问题没有对应的 Lean 声明。(github.com)
这意味着仍有三层工作需要人类研究社区完成。
第一层是命题对应检查,确认 Lean 中证明的形式化命题确实等价于阿伦森-安拜尼斯猜想,而不是在转换定义时改变了条件。
第二层是论文与形式化代码对应检查,确认自然语言论文中的每个关键步骤,都能在公开形式化文件中找到相应证明。
第三层是数学价值评估,判断证明使用了哪些既有成果、哪些连接是新的,以及证明能否进一步推广到更强的量子复杂性结论。
此前证明该猜想特殊情形的斯坦福团队已经开始阅读这份完整证明,并评价其为一项重要结果,但完整的社区验证仍需要时间。PSI 仓库也明确写明,David Turturean 审阅了论文,并对正确性负责。(github.com)
所以,现阶段最准确的表述是:PSI 已公开一份通过 Lean 检查的完整证明,并获得相关研究者的初步积极评价;它还需要经历更广泛的独立复核,才能成为整个领域没有争议的标准结论。
AI 科研的分水岭,可能是“可验证性”
这次案例最值得重视的不是三天,而是证明可以被外部研究者下载、运行和逐步检查。
如果只有“三天解决 18 年猜想”这句话,它很容易沦为另一场模型能力营销。真正提高可信度的,是 PSI 同时公开了论文、Lean 源码、验证脚本、依赖版本和审计记录。
这也给 AI 科研 Agent 提出了一条更现实的评价标准:未来不能只看模型声称解决了多少开放问题,而要看结果是否满足四个条件——原始任务是否明确、过程是否可追踪、结论是否可复现、证明是否能由独立工具验证。
目前仍然缺失的关键数据包括运行总成本、Token 消耗、失败路线数量、人类干预程度,以及 Anthropic 未公开模型相对于公开版本究竟提升了多少。没有这些数据,外界还无法判断“三天证明”是可以规模化复制的能力,还是一次计算资源密集、命中率很低的成功样本。
但方向已经相当清楚:AI 科研 Agent 正在从“帮研究人员读论文、写代码”,进入“主动搜索开放问题证明,并提交机器可验证结果”的阶段。
它还没有取代科学家。它正在改变科学家能够搜索多大的研究空间,以及一个新结果从猜测到验证需要多长时间。
参考来源
- PSI:阿伦森-安拜尼斯猜想证明、Lean 4 代码与验证记录——项目官方仓库,包含论文、形式化证明、审计脚本和验证说明。
- IT之家:Anthropic 神秘模型帮助攻克量子计算重大难题——介绍事件时间、研究机构及其对量子计算加速边界的影响。
- IT之家:Claude 挑战黎曼猜想并刷新相关数学下界——提供 60 个子 Agent、3100 万输出 Token 和 2400 条 Shell 命令等对比数据。