20万次会话揭开Claude科研真相
Anthropic 分析逾20万次科研会话发现,科学家主要用 Claude 分析数据和写论文,却很少让它提出假设或采集数据。AI 已进入科研流程,但暂时更像高效研究助理,而不是独立科学家。
Anthropic 最新研究显示,科学家使用 Claude 最集中的场景不是提出新理论,而是分析数据、编写代码和撰写论文。
11 月 5 日,Anthropic 发布《AI for scientific discovery: How researchers use Claude》研究报告,分析了 2026 年 8 月 2 日至 9 月 30 日间的 207,049 次科研相关会话。其中,Claude 对话与 Cowork 会话共 128,914 次,Claude Code 会话共 78,135 次;研究团队还调查了 528 名正在积极使用 AI 的科学家。(anthropic.com)
这份报告给出的答案相当现实:当前的科研 AI 首先是一套生产力工具,其次才可能成为发现工具。
科学家愿意把统计分析、数据可视化、代码调试和论文润色交给 Claude,却仍然倾向于把提出研究问题、设计关键实验和判断结果价值留在人类手中。这种分工不是因为科学家缺乏想象力,而是因为现阶段 AI 最容易证明价值的地方,恰好是那些输入输出清晰、结果可以验证、能够在计算机内完成的工作。
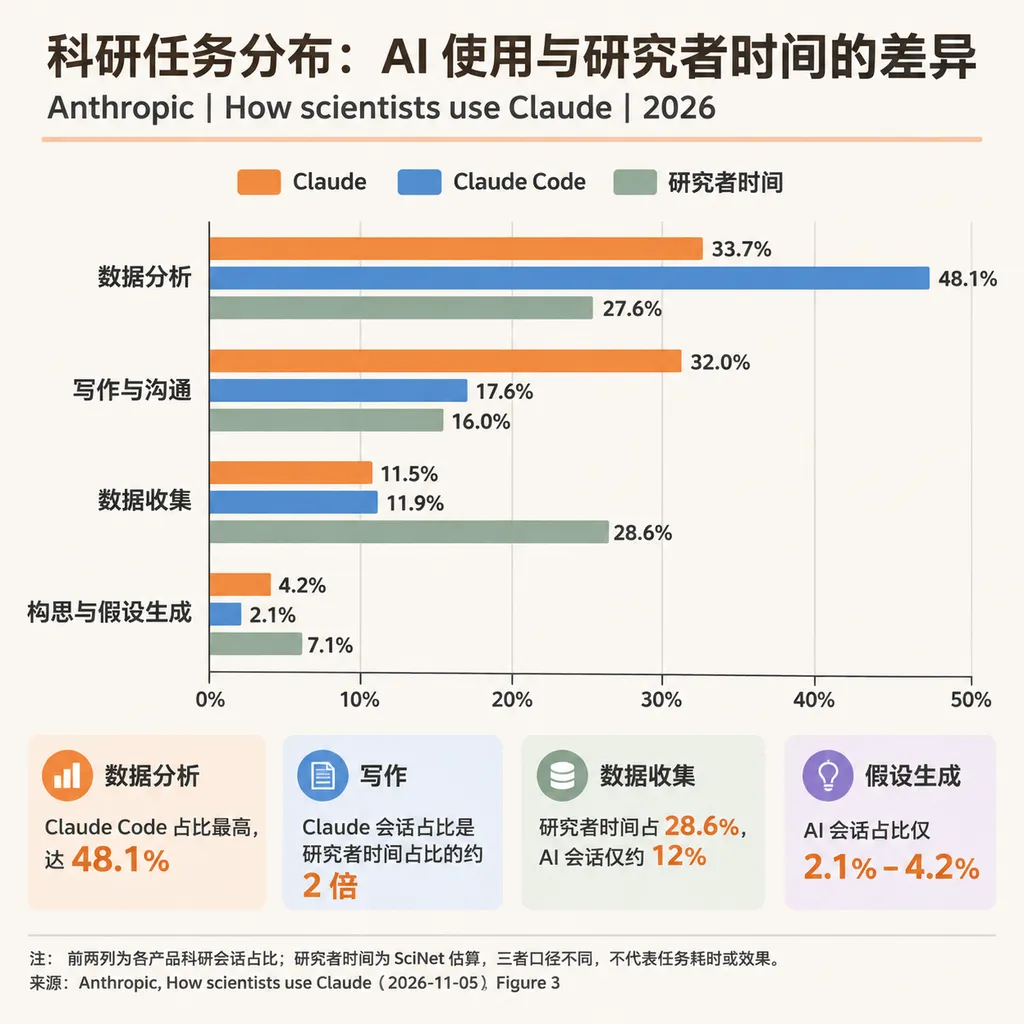
科学家最常让 Claude 做什么
数据分析是 Claude 在科研场景中的第一大用途。
在普通 Claude 科研会话中,数据分析占 33.7%;到了可以直接读取文件、编写和运行代码的 Claude Code,这一比例升至 48.1%。换句话说,Claude Code 每两次科研会话中,几乎就有一次是在处理数据。
写作与沟通紧随其后,占普通 Claude 科研会话的 32.0%。这个比例是研究人员实际工作时间占比 16.0% 的两倍,说明论文起草、结果解释、语言修改和图表说明已经成为大模型最成熟的科研落点之一。
| 科研任务 | Claude 会话占比 | Claude Code 会话占比 | 研究人员时间占比 | |---|---:|---:|---:| | 数据分析 | 33.7% | 48.1% | 27.6% | | 写作与沟通 | 32.0% | 17.6% | 16.0% | | 数据采集 | 11.5% | 11.9% | 28.6% | | 阅读与知识获取 | 7.6% | 3.7% | — | | 理论分析 | 5.0% | 4.7% | — | | 设计与开发 | 4.7% | 7.7% | — | | 构思与假设生成 | 4.2% | 2.1% | 7.1% |
科研数据分析是指对实验或观察数据进行清洗、统计检验、建模、可视化和结果解释。
这类任务天然适合 AI:数据通常已经数字化,执行过程可以通过代码复现,结果也能用测试集、统计指标或人工复核来验证。一名研究人员可以让 Claude Code 读取 CSV 文件、检查缺失值、重构分析脚本、解释异常结果,再根据反馈反复修改。整个闭环都发生在计算机里,不需要模型真的走进实验室。
相比之下,假设生成只有 4.2% 的 Claude 会话和 2.1% 的 Claude Code 会话。数据采集同样明显偏低:研究人员把 28.6% 的工作时间花在采集数据上,但相关任务只占约 12% 的 Claude 科研会话。
这组数字揭示了一个比“AI 能不能做科研”更重要的问题:科研流程中最耗时的环节,并不一定是 AI 最容易介入的环节。
Claude Code 的科研用户高度集中
Claude Code 是能够直接操作代码和本地项目文件的代理式编程工具,因此它在定量学科中的使用远高于其他领域。
计算机科学研究人员只占全球研究人员的 4.3%,却贡献了 Claude Code 科研会话的 32.7%。人工智能与机器学习研究人员占全球研究人员的比例仅为 1.2%,其会话却占普通 Claude 科研使用的 5.0%,并占 Claude Code 科研使用的 15.2%。(anthropic.com)
| 学科或子领域 | 全球研究人员占比 | Claude 会话占比 | Claude Code 会话占比 | |---|---:|---:|---:| | 计算机科学 | 4.3% | 11.9% | 32.7% | | AI 与机器学习 | 1.2% | 5.0% | 15.2% | | 工程学 | — | 8.4% | — | | 医学 | — | 7.7% | — |
这种集中并不令人意外。计算机科学、统计学和数学的大部分研究对象,本来就存在于符号、代码和数据结构中;Claude Code 可以直接接触这些对象,并通过运行程序获得即时反馈。
实验化学、生物医学和材料科学则不同。模型可以阅读实验记录、分析光谱或建议实验条件,却不能独立配制试剂、操作离心机、招募临床受试者,也不能承担实验安全和伦理责任。
纯语言模型的能力边界,最终会被现实世界的物理接口卡住。
报告估计,农业科学、生物医学、化学和材料科学中,约 38%—41% 的研究时间涉及物理步骤,而各学科的中位数只有约 4%。只要实验室机器人、自动化设备和科研数据库没有与模型形成可靠闭环,AI 就很难接管这些工作的主体。
为什么科学家不愿把“想点子”交给 AI
假设生成是根据已有证据提出可检验解释或预测的研究任务。
这项任务的会话占比低,并不能简单解释为 Claude 不会提出想法。大模型当然可以一次生成数十条研究假设,真正困难的是判断哪条假设值得花半年时间、数十万美元和一组研究人员去验证。
科研假设至少面临三层门槛。
第一层是新颖性。一个听起来合理的想法,可能早已被论文验证或否定;如果模型没有完整、实时且结构化的文献与实验数据,它很容易把已有结论重新包装成“新假设”。
第二层是可检验性。好假设不仅要逻辑通顺,还必须能被现实中的实验、样本规模和仪器条件验证。模型可以提出一个蛋白质机制,但研究团队未必拥有对应的实验平台。
第三层是研究品位。科学价值不只取决于答案是否正确,还取决于问题是否重要。选择一个能够改变领域方向的问题,本质上涉及长期经验、资源判断和对学术共同体的理解。这些能力很难通过单次对话表现出来。
因此,科学家目前更愿意让 Claude 扩展候选思路、查找反例或挑战已有推理,而不是让它决定整个项目研究什么。AI 在这一阶段更像一名不会疲倦的讨论对象,而不是实验室负责人。
使用量与模型能力高度相关
AI 能力评分是 Anthropic 用来估计模型理论上能够完成某项科研任务程度的指标。
报告发现,科学家并没有盲目使用 Claude,而是在主动避开模型不擅长的任务。能力评分最低的 20% 任务几乎无人使用 Claude;能力排名前 20% 的任务,其使用强度明显高于研究人员在这些任务上投入的正常时间。
对于普通 Claude,这些高能力任务的相对使用强度约为 2.1 倍;对于 Claude Code,则达到约 3.9 倍。换句话说,如果一项任务既能在计算机中完成,又能快速判断答案对错,研究人员使用 AI 的概率会提高约 2—4 倍。(anthropic.com)
数据可视化和统计检验就是典型例子。模型可以反复运行代码,错误会以报错信息、测试结果或异常图表的形式立即出现。这种反馈环境很适合强化学习,也很适合代理式工具持续尝试。
提纯反应混合物、开展现场观察或与患者互动则处在另一端。它们不仅需要身体行动,还包含安全、伦理、沟通和监管问题。单纯提升模型参数规模,并不会自动消除这些障碍。
这意味着,科研 AI 的下一轮竞争未必只看谁的模型跑分最高,而要看谁能把模型接入更多可信工具,并建立可审计的工作流。
专用科研工具可能改变任务分布
Claude Science 是 Anthropic 面向科学研究设计的工作平台,用于连接科研数据库、计算环境和专业分析工具。
报告中的补充样本显示,专用工具确实能把 AI 从写作和通用分析推向更复杂的科研任务。在 Claude Science 上,构思与假设生成所占份额约为普通 Claude 的两倍;在生物学和生物医学场景中,“提出蛋白质结构与功能假设”出现的相对频率达到普通 Claude 的 6.0 倍。
Claude Science 中超过 80% 的会话被估计需要博士级知识,而普通 Claude 和 Claude Code 的对应比例约为 50%—70%。其高自主程度会话占比达到 73.3%,高于普通 Claude 的 23.7% 和 Claude Code 的 64.1%。(anthropic.com)
这说明问题可能不只是模型能力,而是产品形态。把一个通用聊天机器人放在科学家面前,它自然会被用于问答和写作;当模型能够读取专业数据库、运行分析包、渲染蛋白质结构并保留可追溯结果时,用户才会把更核心的任务交给它。
类似的变化已经在编程领域发生过。聊天机器人主要回答代码问题,代理式编码工具则可以修改整个项目、运行测试并根据报错继续工作。科研 AI 要从“帮我解释”走向“帮我研究”,也需要完成相同的工具化跃迁。
AI 能让科学研究快多少
科研加速倍数是指在相同预算和时间约束下,使用 AI 后的研究产出相对于不使用 AI 的比例。
Anthropic 建立了三个情景模型,估算 AI 可能释放的研究时间。按照当前能力,如果 AI 被广泛采用,它可以承担完成一项新研究所需时间的 27%—52%,各学科中位数为 38%。对应的研究产出增速从艺术领域的 1.35 倍、化学的 1.41 倍,到计算机科学的 1.96 倍和统计学的 2.02 倍不等。
| 模拟情景 | 计算机科学/统计学 | 化学、生物等实验学科 | 关键限制 | |---|---:|---:|---| | 当前 AI 能力全面普及 | 最高约 2.0 倍 | 化学约 1.41 倍 | 多数任务仍需人类参与 | | 自动完成 75% 非物理步骤 | 约 7—8 倍 | 约 2—3 倍 | 实验和现场工作无法自动化 | | 自动完成全部非物理步骤 | 约 15—16 倍 | 约 3—4 倍 | 物理实验成为主要瓶颈 |
这里的 15 倍不是对未来科研产出的直接预测,而是一个高度理想化的经济模型结果。它假设 AI 可以处理所有非物理步骤,研究预算能够顺利转化为更多项目,而且没有考虑大型设备排期、实验耗材、监管审批和研究质量下降等问题。
但这个模型仍然指出了一个重要趋势:越数字化的学科,越可能率先获得数量级的效率提升。
如果计算机科学研究因 AI 获得更高产出,它又会反过来推动下一代 AI 系统,形成“AI 加速 AI 研究,再由更强 AI 加速其他科学”的反馈回路。真正决定这一循环速度的,可能不是聊天能力,而是验证、执行和工具调用能力。
这份报告不能证明 Claude 已经会独立科研
会话占比只能反映用户把 AI 用在什么地方,不能直接证明 AI 改善了研究质量。
这项研究分析的是消费级套餐中的会话,并不覆盖企业内部部署、研究机构自建系统或其他模型平台。一次会话也不等于一次完整研究任务,更不能代表一名独立研究人员。
调查样本主要来自生命科学和健康科学,而且受访者都是积极使用 AI 的研究人员,因此他们对 AI 的采用程度和未来预期可能高于科研群体平均水平。
Anthropic 的隐私方案只保留学科、子领域和任务类别等标签,不保存研究数据、实验方法、初步发现或未发表论文。这保护了用户隐私,却也意味着研究团队无法逐项判断 Claude 给出的分析是否正确、论文是否写得更好,或者某个假设是否真正产生了科学价值。
报告同时带有明显的厂商视角。Anthropic 既是研究者,也是 Claude、Claude Code 和 Claude Science 的产品提供方,因此这份报告更适合用来观察使用结构,而不应被当作独立的模型效果评测。
科研 AI 仍处于“副驾驶”阶段
这项研究最有价值的结论,不是科学家已经大量使用 AI,而是他们清楚地知道哪些工作可以交给 AI。
当前 Claude 在科研中的最佳角色,是处理高频、耗时、可验证的认知劳动:清洗数据、运行统计分析、维护研究代码、生成图表、梳理文献和打磨论文。它减少的是研究流程中的摩擦,而不是取代科学判断本身。
科学家最看重的两项任务——提出好问题和获得新数据——恰恰仍是 Claude 使用最少的地方。这说明 AI 已经进入科研生产线,却还没有坐上决定研究方向的位置。
未来的分水岭不会是模型能否写出一篇看似专业的论文,而是它能否提出真正新颖且可验证的假设,调用可信数据与实验工具完成验证,并把每一步证据交给人类审计。
在做到这些之前,Claude 是一名效率很高的研究助理,但还不是能够独立承担科学责任的研究者。
参考来源
- IT之家:Anthropic 揭秘科学家用 Claude 都干啥 — 汇总 Anthropic 研究的样本规模、学科分布和主要任务占比。