Adobe把照片变成可探索世界
Adobe在MAX 2026展示四项生成式AI实验,用对话塑造角色、把单张图片扩展为可探索场景,并让音效与修图操作变得可复制、可直接操控。
Adobe把照片变成可探索世界
Adobe今天在MAX 2026大会展示了一批生成式AI实验:用户可以走进一张普通照片、像导演试镜一样与虚拟角色对话,还能把一次修图操作“复制粘贴”到其他人物或商品上。
这四项受到关注的实验分别是Project Screen Test、Project Sight Span、Project Sound Bender和Project Rinse Repeat,覆盖AI角色、空间化图像、生成式音频和Photoshop自动化编辑。它们目前都不是已经交付的正式产品,没有公开上线日期、订阅价格或明确的Creative Cloud集成计划。
需要说明的是,Adobe官方在今年MAX Sneaks环节一共介绍了10项研究创新,四个项目只是其中被重点展示和报道的一组。Adobe Sneaks是Adobe用于公开演示早期研究原型的技术预览环节,项目可能进入Photoshop、Premiere、Firefly等产品,也可能永远停留在实验室。
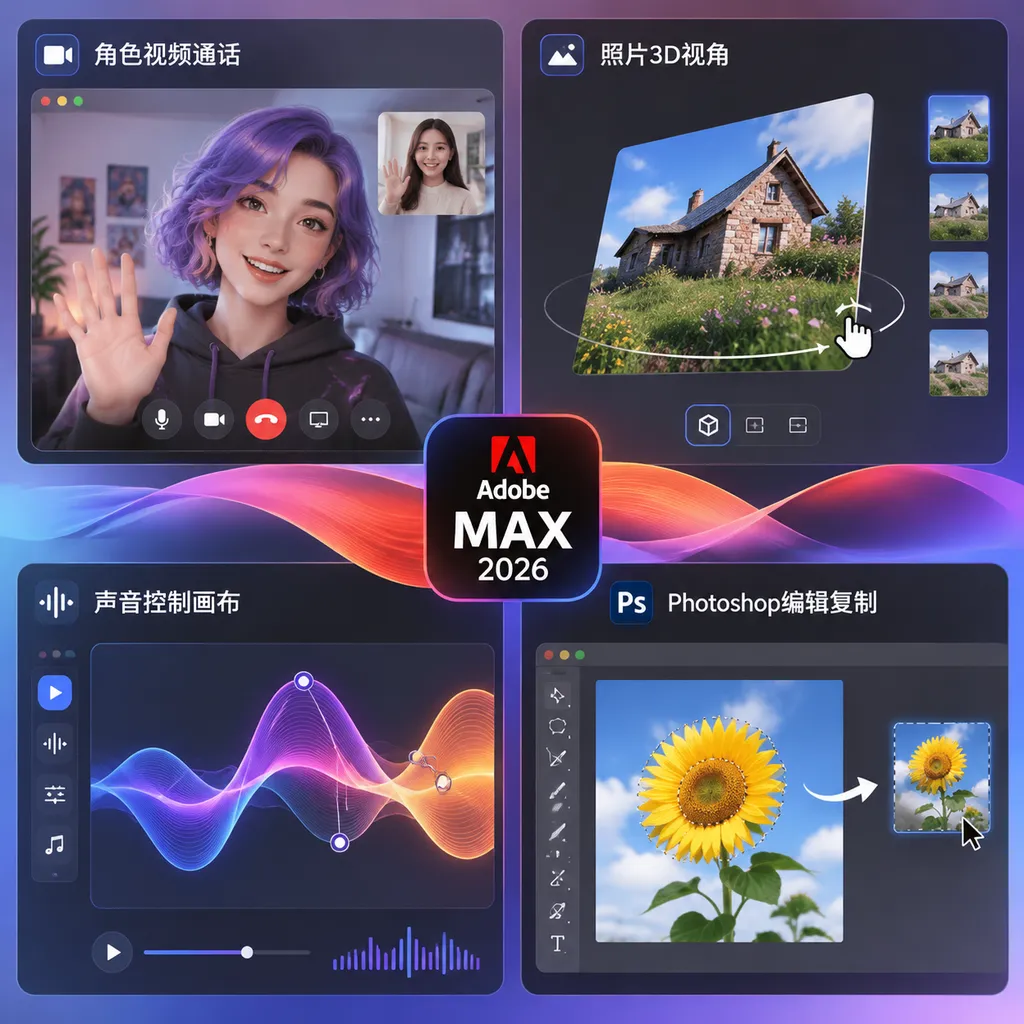
四项实验分别解决什么问题
四项实验的共同点不是“生成更多内容”,而是把提示词背后的模型能力重新包装成创作者熟悉的交互方式。
| 项目 | 核心能力 | 主要输入方式 | 适用场景 | 当前局限 | |---|---|---|---|---| | Project Screen Test | 通过对话建立AI角色的外形、声音与人格 | 性格描述、语音样本、实时对话 | 动画短片、虚拟角色、广告人物设定 | 角色长期一致性和正式产品集成方式未公布 | | Project Sight Span | 将单张平面图像扩展为可移动视角的空间 | 照片、绘画或插画 | 重构图、分镜、广告视觉、概念设计 | 漫游预览细节较模糊,不等同于可交付3D模型 | | Project Sound Bender | 生成并实时混合与视频同步的音效 | 视频、文字描述、二维声音画布 | 短视频、游戏概念、影视声音设计 | 精确时间线编辑和工程级参数尚未展示 | | Project Rinse Repeat | 把一次编辑过程迁移到其他对象 | Photoshop原生编辑操作 | 人像批修、电商商品图、重复视觉处理 | 复杂遮挡和不同材质下的稳定性仍待验证 |
Screen Test:角色设定从写提示词变成“试镜”
Project Screen Test是一个通过自然语言对话塑造虚拟角色的实验系统,目标是让角色拥有可持续修改的人格,而不是每次生成视频时重新抽卡。
用户首先输入“焦虑、害羞、笨拙”一类基础性格标签,再为角色选择预设声音、用文字描述声线,或上传一段音频作为声音参考。角色生成后,用户可以像进行视频通话一样直接与它交谈,继续补充成长背景、目标、缺点、恐惧、说话方式和动作习惯。
这种交互真正解决的是AI视频中的角色控制问题。现有视频模型即使能保持人物的发型和服装,也经常无法保持人物的行为逻辑:同一个角色在上一段镜头里谨慎内向,换一个提示词后可能突然变成夸张的喜剧演员。
**角色一致性是指同一虚拟人物在不同镜头和情境中持续保持外观、语言习惯、行为动机与性格特征。**Screen Test试图把这些要求从散落的提示词变成一份可编辑的角色状态,让创作者先“选演员”,再“拍镜头”。
完成角色设定后,用户还可以描述一个环境或剧情,让系统生成动态试镜片段。例如,把一个性格局促的机器人放进拥挤的生日派对,观察它如何说话、移动和回应其他人物,再回到人格面板调整其恐惧或动作习惯。
Screen Test的价值不只是聊天界面更自然,而是它可能在生成模型和影视生产流程之间增加一层“角色资产”。如果这份资产能在多个镜头、多个项目乃至不同Adobe应用中复用,它就比单次生成一条角色视频更有价值。
但Adobe还没有证明最困难的部分:对话形成的人格能否稳定约束长视频。几分钟的演示可以让角色显得鲜活,几十个镜头中的表演一致性、服装连续性、空间关系和口型同步,才是生产环境真正关心的问题。
Sight Span:不是旋转照片,而是补出照片之外的世界
Project Sight Span是一个从单张图像生成可导航环境的实验工具,用户可以改变观察位置,并从原图没有拍摄到的角度重新构图。
**单图场景重建是指系统根据一张二维图像推断物体深度、遮挡关系、相机位置及画面之外的内容,再生成新的观察视角。**它与普通的生成式扩图不同:扩图通常沿画布边缘补充内容,Sight Span则允许相机向侧面移动、绕到主体背后,甚至彻底改变拍摄机位。
例如,一张人物站在房间中央的照片只记录了人物正面和部分墙壁,Sight Span需要推断人物背后的房间布局、被身体遮挡的家具,以及新角度下人物面部、纹身和服装的形变。Adobe称该项目支持照片、绘画和插画,并能尽量保留原作品的艺术风格。
演示中的取舍很明确:用户在空间内移动时,物体和背景会呈现低清晰度、像素化的预览;选定最终机位后,系统再恢复或重新生成高分辨率画面。这种设计很像3D软件中的低精度视口与最终渲染,把计算资源留到用户确认构图之后。
Sight Span最容易被误解为“一张照片自动生成完整3D模型”,但Adobe目前展示的更接近生成式视角合成。官方没有说明它能否导出带有精确网格、材质、碰撞体和真实尺寸的3D资产,因此不能直接把它等同于Blender或游戏引擎中的场景重建工具。
Sight Span也不是一台还原真实世界的相机。原图之外的信息并不存在,系统生成的桌子背面、人物侧脸和房间结构本质上都是合理猜测。它适合广告构图、概念设计和分镜探索,却不适合要求事实准确的新闻摄影、司法影像或商品真实性证明。
与苹果Spatial Reframing一类空间重构能力相比,Sight Span展示出的视角调整幅度更大,也更主动地生成原画面之外的内容。代价是作品与“照片记录”的距离更远:当相机移动到原拍摄位置之外,最终画面已经是一张以照片为参考生成的新图像。
Sound Bender:把声音模型的潜空间做成一块控制板
Project Sound Bender是一个生成、提取并实时调整声音变化的交互式音频工具,用户可以像在颜色选择器里移动光标一样控制音效。
用户上传一段视频,再输入“冒着气泡的科幻炼金锅”之类的声音描述,系统会生成对应音效并与画面节奏同步。工具随后提供一个方形声音画布,四个角可以代表不同声音特征,例如气泡爆裂、岩石沸腾、电子音高变化和电火花噼啪声。
**生成式音频插值是指系统在多个声音特征之间连续计算中间状态,让用户获得渐变结果,而不是只能从固定音效列表中选择。**当光标靠近某个角落时,对应声音特征会更突出;移动到画布中央,则能听到几种特征混合后的结果。
Sound Bender最聪明的地方,是没有要求用户理解频谱、包络、滤波器或合成器参数。创作者听到声音不对时,只需要把光标向“更沉”“更密”“更电子”的方向移动,模型负责把语义变化转换成音频变化。
这比反复修改提示词更适合声音设计。文字很难精确描述“把爆裂声减少20%,同时增加低频轰鸣,但不要改变节奏”,而二维控制面板能让用户边听边调,反馈周期接近传统音频插件。
不过,Sound Bender目前展示的是创意探索能力,不是完整的数字音频工作站。影视后期仍然需要处理响度标准、分轨、自动化曲线、环境混响、对白避让和版权溯源,Adobe尚未说明这些生成音效将如何进入Premiere或Audition的正式工程流程。
Rinse Repeat:四项实验里最可能真正节省工时的一个
Project Rinse Repeat是一个记录局部编辑过程并将其迁移到其他对象上的Photoshop实验功能,效果类似复制粘贴,但复制的是编辑意图,而不是像素。
**语义编辑重放是指系统理解一次操作的目的,再根据新对象的形状、位置和材质重新执行相同编辑。**例如,修图师手动去除合影中一个人的痘痘后,Rinse Repeat可以识别这是一组皮肤瑕疵处理操作,并把相似流程应用到其他人物,而不是把第一张脸的皮肤贴到第二张脸上。
电商场景可能更适合这项能力。设计师为一只商品杯添加了阴影后,系统可以把“光源方向、阴影柔度和落点关系”迁移到不同形状、不同尺寸的商品上,而不是机械复制一块完全相同的黑色阴影。
Rinse Repeat最关键的技术细节,是迁移后的结果仍由Photoshop原生工具重建。用户可以继续调整图层、蒙版和具体参数,不必接受一张已经被模型拍扁的最终图片。
这种“可编辑”比生成效果是否惊艳更重要。专业创作不是一次生成后直接交付,而是要经历客户反馈、局部修改、版本对比和多人协作;如果AI只输出一张不可逆的图片,它就很难进入成熟工作流。
四项实验中,Rinse Repeat也是最接近Adobe传统优势的项目。它不需要替代Photoshop,而是读取用户在Photoshop里的操作,把重复劳动自动化。相比重新发明一款全新的AI图片应用,这种路径更容易被现有用户接受,也更可能较早产品化。
Adobe真正押注的是“提示词之后”的交互
Adobe这次展示的核心判断是:提示词不会成为创意软件的最终界面。
文字输入适合表达目标,却不适合完成所有细节控制。用户可以说“让声音更有科技感”,但很难用一句话描述混音比例;可以说“换一个拍摄角度”,但无法只靠文字准确指定相机移动轨迹;可以写一页角色设定,却未必能判断这个角色说话时是否可信。
四项实验分别用对话、相机移动、二维控制板和复制粘贴取代连续改提示词。模型仍在后台生成内容,前台却重新回到了创作者熟悉的动作:聊天、拖动、观察、调整和复用。
这条路线比单纯追求更大的生成模型更符合Adobe的位置。Adobe未必需要在基础模型榜单上击败所有竞争对手,它需要证明Photoshop、Premiere和Firefly仍然是把模型能力变成可控生产流程的最佳界面。
与此同时,这些工具也会继续压缩素材库和基础执行岗位的价值。Sight Span可以临时生成新机位,Sound Bender可以生成定制音效,Rinse Repeat能减少批量修图,Screen Test则让小团队更快建立虚拟角色。过去需要采购素材、搭建简单场景或交给助理完成的工作,将越来越多地由软件即时完成。
但“降低操作门槛”不等于“取消专业判断”。模型可以给出十种声音变化,却不知道哪一种适合品牌;可以生成角色恐惧,却不能保证人物弧光成立;可以补出照片背后的房间,却不知道这个空间是否符合真实建筑结构。
现在还不该把它们当成产品发布
这次展示最值得关注的不是某个按钮明天就能用,而是Adobe正在把生成式AI从内容生成器改造成工作流系统。
目前四个项目都缺少正式产品必须公布的信息,包括支持平台、处理延迟、最高输出分辨率、企业数据策略、生成额度、订阅价格以及商业使用条款。Adobe也没有承诺它们一定会进入Creative Cloud或Firefly。
Adobe在MAX Sneaks展示的项目过去确实有机会演化为正式功能,但实验演示与大规模交付之间还有明显距离。单张精心选择的示例可以掩盖复杂遮挡、多人场景、长时间一致性和极端输入下的失败率,真正的产品要面对的是用户上传的所有糟糕素材。
我们的判断是,Rinse Repeat的近期实用价值最高,Sight Span的视觉冲击力最大,Screen Test代表的长期产品空间最广,而Sound Bender最能体现Adobe对新交互方式的思考。
如果Adobe能把这四种能力做成非破坏性、可追溯、跨应用复用的原生工具,它们就不只是MAX舞台上的AI魔术;如果最终只剩下一组等待进度条结束的生成按钮,那么它们与市场上大量独立AI工具不会有本质区别。
参考来源
- IT之家:Adobe公布四项AI实验项目——整理Project Screen Test、Project Sight Span、Project Sound Bender和Project Rinse Repeat的演示方式、使用场景与当前实验状态。