GitHub让Agent技能跨平台复用
GitHub 正在推动 Agent Skills 从单一产品配置变成可跨 Agent 迁移的工程资产。真正可移植的是流程与知识,工具、权限和运行环境仍需宿主适配。
GitHub 在 11 月 12 日发布 Agent Skills 实战指南,把一个正在快速扩张的行业共识说得更直白:团队不应该为 Copilot、Claude Code、Codex、Cursor 分别重写同一套工作流程,而应该把流程写成可审查、可版本化、可跨 Agent 搬运的技能文件。(github.blog)
**Agent Skills 是一种以 SKILL.md 为核心、用于封装专业知识和可重复工作流的开放文件格式。**一个技能通常是一个普通目录,里面可以放指令、脚本、参考文档和模板;Agent 先根据元数据判断是否需要它,命中任务后再加载完整指令和相关资源。
这件事值得关注,不是因为 GitHub 又给 Copilot 增加了一种配置文件,而是因为 Agent 生态终于开始从“每家都有自己的提示词体系”,走向“同一份能力可以被多个宿主消费”。过去开发者迁移 Agent,最痛苦的往往不是模型能力差异,而是团队已经积累的代码审查规则、发布流程、数据口径和安全检查全部绑在某个产品里。
不过,GitHub 所说的“Build once, run on any agent”需要打一个星号:**能跨平台复用的是技能中描述的流程和判断标准,不是完整运行环境。**技能可以告诉 Agent 如何查询数据库,却不会自动获得数据库账号;技能可以规定发布前执行哪些检查,却不能替代 CI 的分支保护;技能可以引用一个 Shell 脚本,却不能保证每个宿主都安装了相同的命令行工具。
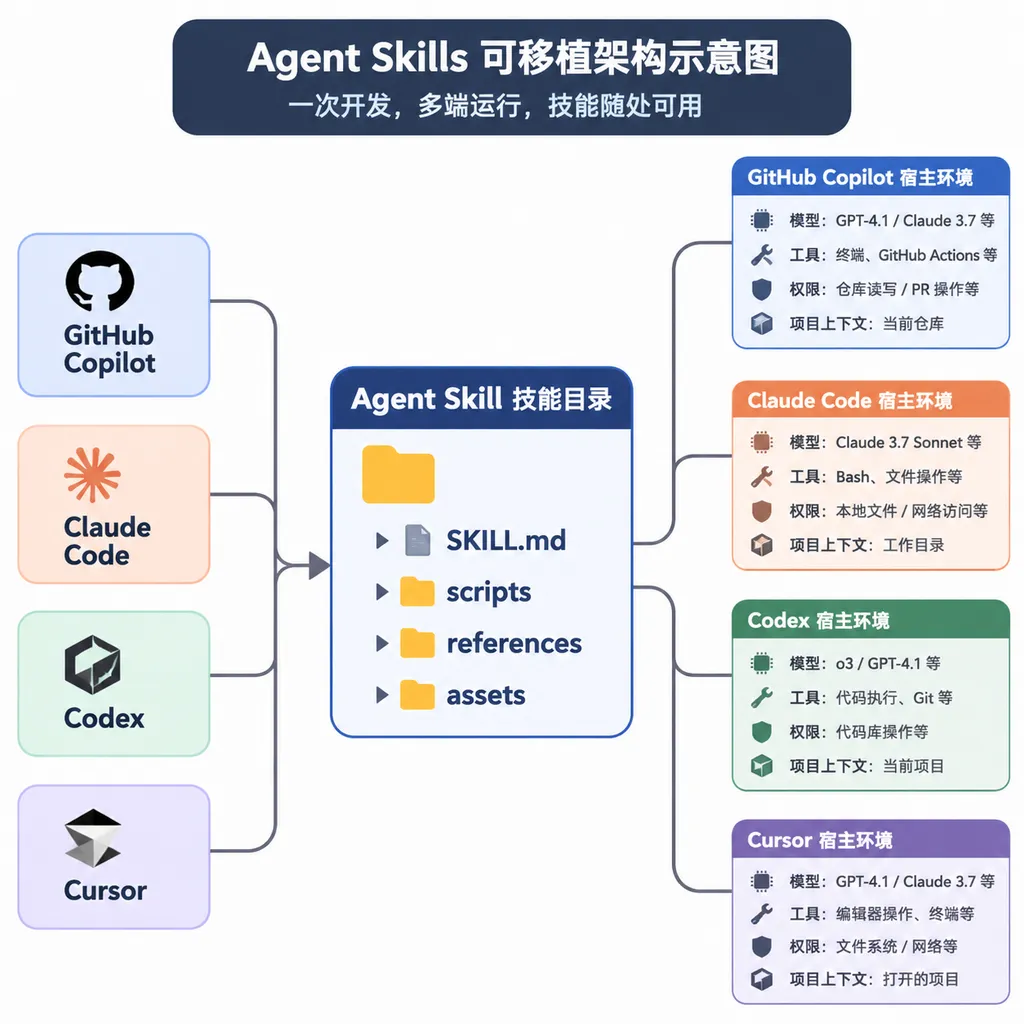
GitHub真正推动的是什么
**GitHub 推动的核心变化,是把 Agent 能力从聊天记录和产品设置中抽离出来,变成可以进入 Git 仓库的工程资产。**一套成熟技能不再是某位工程师收藏的一段“神奇提示词”,而是能够经过 Pull Request、代码审查、版本发布和回滚的目录。
一个最小技能只需要如下结构:
code-review/
└── SKILL.md
一个适合团队使用的技能通常会扩展为:
code-review/
├── SKILL.md
├── scripts/
│   ├── run-tests.sh
│   └── collect-diff.sh
├── references/
│   ├── security-rules.md
│   └── review-checklist.md
└── assets/
    └── review-report.md
SKILL.md 是技能的入口文件,YAML 头部负责发现,Markdown 正文负责执行。name 和 description 是最重要的两个字段,其中 description 不只是给人看的说明,更接近 Agent 的路由规则:它需要讲清楚技能做什么、何时调用,以及哪些任务不应该调用。
---
name: code-review-self-check
description: Review AI-generated code changes against the original request, repository rules, tests, and security requirements. Use before opening or approving a pull request.
---

# Code Review Self Check

## When to use

Use this skill after an agent changes code and before creating a pull request.

## Procedure

1. Read the original task and summarize its acceptance criteria.
2. Inspect the changed files without relying on the coding agent's summary.
3. Run the repository's existing tests and static checks.
4. Compare implementation results with every acceptance criterion.
5. Report PASS, FAIL, or PARTIAL with file-level evidence.

## Boundaries

- Do not modify production code during verification.
- Do not mark PASS when tests were skipped.
- Ask for approval before running scripts with external side effects.
这段文件并不复杂,但它解决了普通提示词最难解决的三个问题:何时触发、按照什么顺序执行、什么结果才算完成。相比“帮我认真检查一下代码”,技能文件把“认真”拆成了可以复核的验收标准。
可移植不等于复制目录
**Agent Skills 的可移植性建立在格式统一、路径适配和能力降级三层机制上。**如果只把同一个文件夹复制到不同产品,却没有检查宿主支持的工具、扩展字段和权限模型,得到的通常只是“能够被发现”,而不是“能够稳定运行”。
| 对比维度 | GitHub Copilot | Claude Code | OpenAI Codex | Cursor | 可移植策略 |
|---|---|---|---|---|---|
| 常见项目级目录 | .github/skills/ | .claude/skills/ | .agents/skills/ | .cursor/skills/ 或兼容目录 | 保留一份源目录,安装时映射路径 |
| 核心入口 | SKILL.md | SKILL.md | SKILL.md | SKILL.md | 只使用开放规范中的基础字段 |
| 脚本执行 | 取决于 Copilot 工具与权限 | 取决于本地工具授权 | 取决于沙箱和命令权限 | 取决于 Agent 模式 | 在技能中声明依赖,不假设工具存在 |
| 自动选择技能 | 根据描述和任务匹配 | 根据描述和任务匹配 | 根据描述和任务匹配 | 取决于具体实现 | 为描述编写明确触发条件 |
| 宿主扩展 | 支持部分专属字段和工作流 | 支持 Hooks、子上下文等能力 | 支持自身运行机制 | 支持自身规则体系 | 把扩展层与通用技能层分开 |
**最稳妥的实践是建立“单一技能源”,再由安装脚本或打包工具生成宿主需要的目录和清单。**GitHub 在 Data Forge 示例中采用的就是这种思路:以 skills/*/SKILL.md 为源文件,再生成 Claude Code、Cursor 和 GitHub Copilot 所需的产品配置,并在 CI 中检查生成文件是否与源文件发生漂移。
这个模式与前端项目同时输出 ESM、CommonJS 和类型声明很像。业务逻辑只维护一次,各宿主格式只是构建产物;如果开发者手工维护四份技能,半年后大概率会出现 Copilot 版本修了安全规则、Cursor 版本却还在执行旧流程的情况。
第一步:选择适合封装的任务
**适合做成 Agent Skill 的任务必须边界明确、重复出现,并且具有可以复用的判断过程。**代码审查、版本发布、数据库迁移检查、故障复盘、依赖升级和指标开发,都比“帮我开发整个系统”更适合技能化。
GitHub 给出的判断标准相当实用:一个技能最好有明确的任务、输入和输出。团队可以先回答四个问题:
- 这个任务是否每周都会被重复解释?
- 不同工程师执行时,是否经常漏掉相同步骤?
- 执行结果能否用文件、测试或报告验证?
- 任务失败时,能否明确停在某个检查点?
**不适合技能化的工作通常需要稳定服务接口、长期状态、强制权限控制或长时间运行。**如果流程必须维护跨小时任务状态、提供审计数据库、在模型之外强制执行权限,应该构建应用、工作流引擎或 CI 服务,而不是继续给 SKILL.md 增加更多段落。
第二步:把业务上下文移出技能
**真正决定一套技能能否跨项目复用的因素,是技能内部有没有硬编码业务名称和环境配置。**如果代码审查技能写死了仓库名、分支名、数据库表和部署区域,它只是一个项目脚本,不能算可移植技能。
GitHub 展示的 Data Forge 把业务信息放进独立 Manifest,由 forge-init、forge-builder、forge-dbx 和 forge-lint 等技能共同读取。技能只负责通用流程,Manifest 则负责描述当前项目的实际环境。
project:
  name: support-desk
  metric_store: support_metric_store

platform:
  engine: duckdb
  pipeline_framework: spark_python

quality:
  require_tests: true
  require_schema_approval: true
**Manifest 是项目事实的单一来源,Skill 是处理这些事实的方法。**同一套技能从 DuckDB 切换到 Databricks 时,理论上只需要修改平台配置,而不需要改写检查顺序、命名规则和审批节点。
这种分离还有一个隐藏价值:团队可以区分“仓库里现在是这样写的”和“公司规定必须这样写”。Agent 扫描旧代码发现一种命名方式,不代表这种命名就是正确规范;项目事实可以被自动发现,团队规则则应由人确认并放进可审查的标准文件。
第三步:让多个技能组合,而不是造超级技能
**多个职责单一的技能通常比一个数千行的超级技能更可靠。**一个技能负责读取项目环境,一个技能负责执行查询,一个技能负责代码规范,一个技能负责组织完整流程,这种拆分能让每个模块单独测试和更新。
GitHub 的 Data Forge 示例包含四个关键技能:
| 技能 | 主要职责 | 可替换部分 |
|---|---|---|
| forge-init | 扫描仓库和数据结构,生成项目 Manifest | 项目发现逻辑 |
| forge-dbx | 提供统一的数据查询和任务执行入口 | DuckDB、Databricks 等适配器 |
| forge-lint | 检查命名、SQL 格式、连接策略和安全规则 | 团队标准 |
| forge-builder | 将需求组织为七阶段流程并产出 Pull Request | 流程编排 |
组合技能的关键不是让 Agent 自由发挥,而是让技能之间共享明确产物。forge-init 输出 Manifest,forge-builder 消费 Manifest;上一阶段完成后写入状态,下一阶段先验证状态;需要业务判断时暂停并要求人工确认。
GitHub 展示的流程包含七个阶段,每个阶段都设置人工检查点。这个设计比“让 Agent 自主跑到底”保守,但更接近真实企业环境:数据库结构变更、批量数据回填和生产发布,本来就不应该因为模型认为自己有把握而跳过审批。
第四步:用CI验证,不要让技能自己给自己打分
**Agent Skills 可以指导检查过程,但强制门禁仍然应该放在 CI、仓库规则和权限系统中。**GitHub 的 Proof Agent 示例强调了一条重要原则:自我验证不等于验证,因为生成代码的 Agent 很容易受到自己先前解释和假设的影响。
更可靠的结构是让独立验证者读取原始需求和代码差异,而不是直接接受开发 Agent 的总结。验证结果可以统一为:
PASS:所有验收标准通过,并提供文件或测试证据。FAIL:存在明确错误、安全风险或未满足的要求。PARTIAL:部分检查无法完成,或缺少运行环境和权限。
**验证结果必须带证据,否则 PASS 只是另一段自然语言。**证据可以是具体文件和行号、测试结果、静态检查输出、截图或生成产物,最终是否允许合并则交给 GitHub Actions 和分支保护规则决定。
第五步:处理权限与供应链风险
**Agent Skill 本质上是可能影响 Agent 行为、读取项目文件并触发脚本的供应链依赖。**从公共仓库安装技能之前,只看 Star 数量和 README 远远不够,开发者需要检查 SKILL.md、脚本目录、外部资源引用、联网要求和工具权限。
GitHub 已明确提醒,第三方技能可能包含提示注入、隐藏指令或恶意脚本;对 Shell 和 Bash 的预授权尤其需要谨慎,因为它可能让技能绕过逐次确认并直接运行终端命令。(docs.github.com)
团队至少应该建立以下安全基线:
- 将技能固定到 Git Tag 或 Commit SHA,而不是始终跟随主分支。
- 在安装前预览完整文件树,并审查所有可执行脚本。
- 默认不预授权 Shell、文件删除和外部网络访问。
- 把凭据留在宿主的 Secret 管理系统中,不写入技能目录。
- 使用 CI 检查技能源与各宿主生成文件是否一致。
- 为内部技能配置负责人、许可证和版本变更记录。
Agent Skills与现有方案有什么区别
**Agent Skills 不是 MCP、自定义指令和工作流引擎的替代品,而是位于它们之间的流程知识层。**把几种概念混在一起,会导致技能承担它无法可靠完成的权限和状态管理工作。
| 方案 | 核心定义 | 最适合解决的问题 | 是否跨 Agent | 是否负责权限 | |---|---|---|---|---| | Agent Skills | 可按需加载的流程、知识、脚本和资源目录 | 重复工程任务与专业工作流 | 目标是跨 Agent 复用 | 否 | | Custom Instructions | 长期或全局生效的行为规则 | 编码风格、命名习惯、通用约束 | 通常依赖具体产品 | 否 | | MCP | Agent 连接外部工具与数据源的协议 | 工具发现、参数调用和数据访问 | 可跨支持 MCP 的客户端 | 由工具与宿主控制 | | CI/CD | 确定性自动化和强制门禁 | 测试、构建、部署和合并检查 | 与 Agent 无关 | 可以强制执行 | | 工作流应用 | 有状态的长期业务系统 | 审计、队列、重试和复杂审批 | 取决于产品实现 | 可以强制执行 |
一句话概括:**MCP 给 Agent 提供“手和接口”,Agent Skills 告诉它“这项工作应该怎么做”,CI 则决定“结果不合格时能不能继续”。**这三层组合起来,才是一套能进入生产环境的 Agent 工程体系。
GitHub为什么现在加速推进
**GitHub 此时强调可移植性,是因为 coding agent 的竞争正在从模型性能转向工作流入口和生态控制权。**当 Copilot、Claude Code、Codex、Cursor 和更多 Agent 同时进入开发团队后,企业不会愿意把内部知识重复维护五遍。
Vercel 的 skills CLI 已经把技能安装、发现、更新和锁文件管理做成独立工具,其官方仓库目前写明支持 OpenCode、Claude Code、Codex、Cursor,以及另外 75 个 Agent。这个数字说明 Agent Skills 已经不只是某一家模型公司的功能,而是在形成类似 npm 包的分发层。
GitHub 的优势则在于版本控制、Pull Request、Actions、权限和代码审查都已经存在。技能一旦成为仓库文件,GitHub 天然可以承接它的托管、评审、发布、安全扫描和协作流程。换句话说,GitHub 不一定需要垄断技能格式,只要成为技能最常被存放和治理的地方,就能获得新的平台位置。
值不值得现在投入
**Agent Skills 已经值得团队试用,但还不值得把所有自动化系统重写一遍。**最合理的切入点不是建设庞大的企业技能市场,而是选择一个团队反复解释、容易出错、又能够验证结果的任务,先做出第一个小技能。
建议从代码审查、自检、依赖升级或发布检查中选择一个场景,用两周观察四项指标:
- 相同任务的重复提示长度是否下降;
- Agent 漏掉固定步骤的次数是否下降;
- 从需求到 Pull Request 的平均时间是否缩短;
- 换用另一种 Agent 后,需要修改多少技能内容。
**如果切换宿主时只需要改变安装路径、工具声明和少量适配层,说明技能边界设计正确。**如果每换一个 Agent 都要重写一半正文,通常意味着技能混入了过多产品专属命令、项目硬编码或隐式环境假设。
GitHub 这次给出的方向是对的:Agent 的长期价值不会只来自更强的模型,还来自团队能否把自己的工程判断沉淀下来。模型会更新,编辑器会更换,Agent 产品也可能被淘汰;但经过审查的发布流程、安全规则、数据口径和验收标准,不应该跟着某个聊天窗口一起消失。
真正有价值的 Agent Skills,不是一份更长的 Prompt,而是一份 Agent 可以执行、工程师可以审查、团队可以迁移的“工作说明书”。
参考来源
- GitHub Universe 2026:Build once, run on any agent 示例仓库 —— 包含 Proof Agent、Data Forge、技能打包与跨宿主适配示例。
- Agent Skills 开放规范仓库 —— 提供
SKILL.md格式、字段约束和 Agent 集成规范。 - GitHub Awesome Copilot —— GitHub 维护的 Copilot 指令、Agent 与 Skills 示例集合。
- Vercel Skills CLI —— 提供技能发现、安装、更新、临时使用和多 Agent 目录适配。
- Anthropic Skills —— Agent Skills 的公开技能示例与早期格式实践。
- Microsoft Skills —— 展示大规模技能库、渐进式加载和多 Agent 安装方式。