Edge0-145B:把145B模型搬上电脑
Edge0 发布145B级本地模型,单张RTX 5090 D可实现121.2 token/s的Agent解码速度。但它依赖稀疏MoE、内存卸载和定制推理引擎,并非普通电脑都能轻松运行。
145B模型开始争夺个人电脑
Edge0 在11月13日正式发布 Edge0-145B 和 Edge0-120B,试图把过去属于多卡服务器的百亿乃至千亿参数模型,搬到单张消费级显卡上运行。
Edge0-145B 是一个面向本地编程和Agent任务的1450亿参数稀疏混合专家模型,基于 Qwen3.8-Flash-Next 派生,并针对4位精度进行原生训练。官方公布的最高成绩来自 RTX 5090 D 24GB:16K上下文预填充速度为3554.9 token/s,聊天解码速度为99.7 token/s,Agent解码速度达到121.2 token/s。(huggingface.co)
这组数字足够吸引眼球,但“145B模型在个人电脑上运行”需要加上几个限定条件:目前正式支持的是 Linux 或 Windows、NVIDIA GPU 和 CUDA 13;权重文件仍然超过40GB;测试中的低显存配置依靠系统内存与显存协同,而不是把整个模型塞进一张16GB显卡。
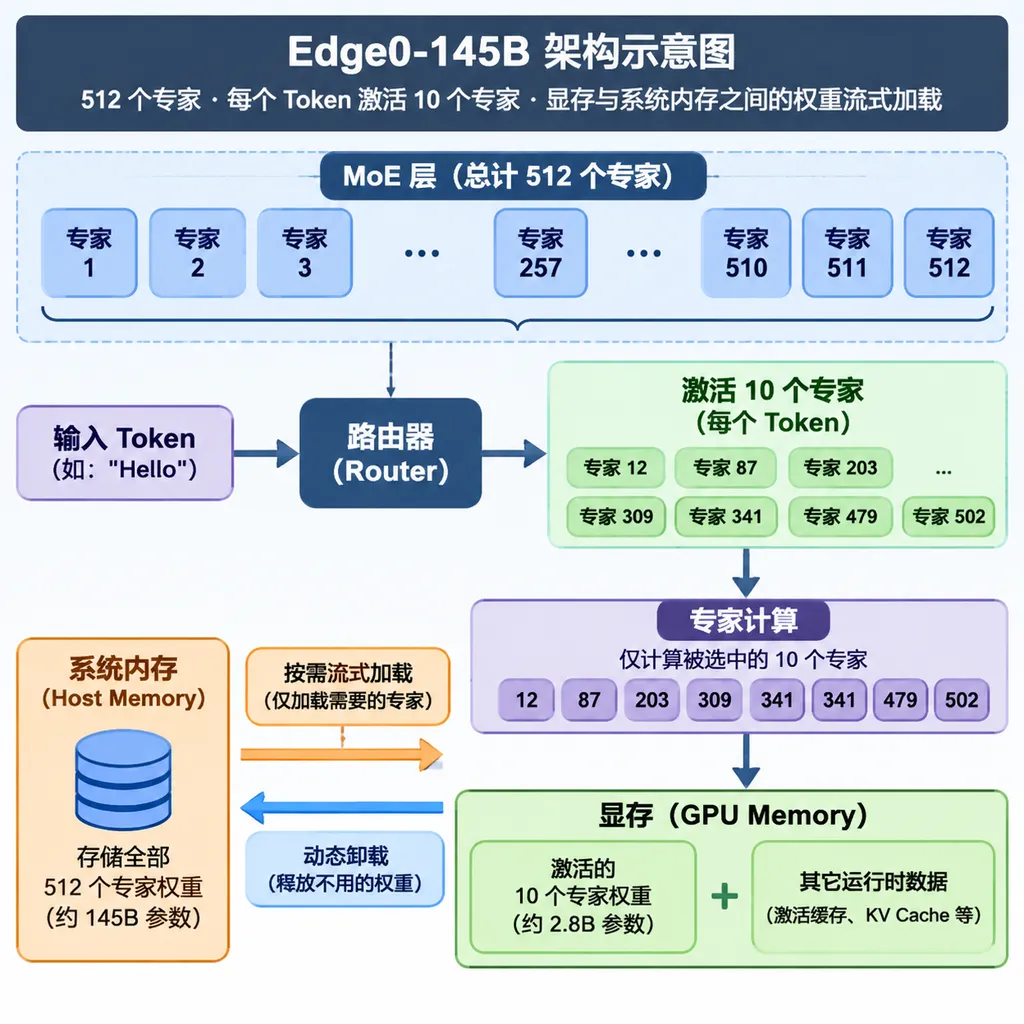
它不是每次都计算145B参数
稀疏混合专家模型是把模型内部的前馈网络拆成大量“专家”,每次只选择少数专家参与计算的神经网络架构。
Edge0-145B 总参数量为145B,但每个Token实际激活的参数约为10.12B,只相当于总参数量的约7%。模型包含48层网络,每层设置512个路由专家,每个Token选择10个路由专家,同时启用1个共享专家。
这意味着145B更多代表模型能够容纳的知识容量,而不是每生成一个Token都要完成145B参数的计算。它更像一家拥有512名专业顾问的咨询公司:公司规模很大,但处理一个问题时,只会叫来最相关的10名顾问,而不是让所有人同时开会。
Edge0-145B 使用的“Latent MoE”则进一步压缩了专家层的输入宽度。注意力模块维持2560维宽度,Token进入专家层前先被投影到1792维,完成专家计算后再投影回2560维。官方给出的专家池规模为84.6B参数,而模型中另有51.2B参数属于FP8格式的N-gram嵌入表。(huggingface.co)
因此,Edge0-145B不能简单视为一款与145B稠密模型计算量相同的产品。它的实际单Token计算规模更接近10B级模型,但总参数池、路由机制和长上下文结构要复杂得多。这不是“参数造假”,却提醒用户:比较MoE模型时,必须同时看总参数量、激活参数量和权重存储体积。
40GB权重怎么塞进24GB显存
Edge0 的核心能力不是量化本身,而是让没有进入显存的专家权重仍然能够及时参与推理。
Edge0-145B 提供 Q3_K 和 NVFP4 两种构建版本,权重文件分别为40.81GiB和47.79GiB。即使使用更小的Q3_K版本,文件大小也明显超过RTX 5090 D和RTX 4090的24GB显存容量。
Edge0-strata 推理引擎采用专家权重流式加载方案,把高频使用的专家保留在显存中,其余专家放在系统内存,并根据路由结果按需调入。由于每个Token只激活少量专家,推理系统不需要让全部145B参数同时驻留显存。
这套方法解决的是“驻留容量”问题,而不是消灭内存需求。官方开启权重驻留后的测试数据显示,Q3_K版本占用23.14GiB显存和31.28GiB系统内存;NVFP4版本占用23.25GiB显存和38.27GiB系统内存。两部分保存的是不同专家集合,不能理解为同一批权重被重复计算。
官方还公布了一组“16GiB显存+20GiB内存”成绩:16K预填充335 token/s,聊天解码36.8 token/s,Agent解码44.9 token/s。但这项测试是在RTX 5090 D上通过cgroup限制可用资源完成的,并不是在某张普通16GB显卡上测试。官方也明确表示,这些数字是测试预算,而非最低系统要求。(huggingface.co)
换句话说,Edge0证明了145B模型可以在严格受限的显存与内存预算下运行,却还没有证明任何一台16GB游戏本都能稳定复现同样体验。SSD速度、PCIe带宽、内存带宽、CPU调度和专家命中率,都会直接影响实际速度。
RTX 4090已经能达到可用速度
Edge0-145B 在RTX 4090上的Agent解码速度为91.7 token/s,这已经超过多数人阅读模型输出的速度。
| 硬件与版本 | 4K预填充 | 16K预填充 | 聊天解码 | Agent解码 | |---|---:|---:|---:|---:| | RTX 5090 D 24GB,Q3_K | 2169.9 token/s | 3554.9 token/s | 99.7 token/s | 121.2 token/s | | RTX 5090 D 24GB,NVFP4 | 1839.6 token/s | 3165.7 token/s | 79.6 token/s | 98.3 token/s | | RTX 4090 24GB,Q3_K | 2042.0 token/s | 3179.4 token/s | 69.9 token/s | 91.7 token/s | | 受限16GiB显存+20GiB内存,Q3_K | 249 token/s | 335 token/s | 36.8 token/s | 44.9 token/s |
Q3_K版本在RTX 5090 D上的Agent解码速度比NVFP4快约23.3%,16K预填充速度快约12.3%,权重体积还小约14.6%。至少从Edge0公布的数据看,Q3_K不是一个单纯以质量换空间的低配版本,反而是当前更值得普通用户优先尝试的构建。
NVFP4也并非在所有设备上都更慢。官方数据显示,在RTX Spark N1X 60GiB上,NVFP4的Agent解码速度为46.0 token/s,高于Q3_K的36.7 token/s。这说明两种格式的实际表现高度依赖硬件指令、内存带宽和内核优化,不能只根据位宽判断速度。
跑分不错,但仍是官方自测
Edge0-145B 的定位不是通用聊天模型,而是本地编程、终端操作和Agent工作流模型。
| 模型 | deepswe 1.1 | terminal-bench 2.1 | IFBench | GPQA-Diamond | HLE | |---|---:|---:|---:|---:|---:| | Edge0-145B | 64.6 | 86.5 | 80.6 | 90.4 | 35.4 | | Edge0-120B | 51.3 | 75.3 | 79.3 | 87.4 | 31.0 | | Qwen3.8-Flash-Next | 58.7 | 83.3 | 81.3 | 91.7 | 35.9 | | DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 79.2 | 90.8 | 33.8 | | Qwen3.8-27B | 42.2 | 73.0 | 79.5 | 89.2 | 30.8 |
Edge0-145B 在deepswe 1.1上得到64.6分,比基础模型Qwen3.8-Flash-Next的58.7分高5.9分,增幅约10.1%;terminal-bench 2.1从83.3提高到86.5,增幅约3.8%。这表明Edge0的训练重点确实落在软件工程和终端任务,而不是只做权重量化。
Edge0-145B 并没有在所有项目上超过基础模型。它的IFBench为80.6,低于Qwen3.8-Flash-Next的81.3;GPQA-Diamond为90.4,低于后者的91.7;HLE为35.4,也略低于35.9。Edge0更像是一次面向本地Agent的专项重构,而不是全面超越原模型的新一代基础模型。
这些成绩目前主要来自项目方自测,尚缺少更广泛的第三方复现。尤其是Agent类基准对脚手架、工具权限、提示词模板和超时设置非常敏感,86.5分的terminal-bench成绩值得关注,但还不能直接等同于用户在真实代码仓库中的成功率。
256K上下文不等于256K都驻留显存
Edge0-145B 支持256K上下文,但只让32K范围的INT8 KV Cache保持驻留。
模型采用混合注意力结构,每4层设置一次完整注意力,其余部分结合稀疏索引器。这样的设计降低了长上下文对KV Cache的持续压力,也更适合本地设备处理大型代码仓库、长文档和多轮Agent轨迹。
模型还包含一个1.26B参数的MTP草稿模型,用于推测解码。推测解码是让一个较小的模型先批量猜测后续Token,再由主模型一次验证多个候选,从而减少主模型逐Token运行的次数。Edge0公布的高解码速度,很可能同时受益于稀疏激活、专家缓存和MTP,而不能全部归功于4位量化。
“本地电脑”目前主要指高端NVIDIA主机
Edge0-145B 当前的部署门槛仍然高于标题给人的第一印象。
| 项目 | Edge0-145B现状 | |---|---| | 操作系统 | Linux、Windows | | GPU | 单张NVIDIA GPU | | CUDA版本 | CUDA 13 | | 模型格式 | Q3_K、NVFP4 | | 权重大小 | 40.81GiB、47.79GiB | | 上下文长度 | 256K | | 推理引擎 | edge0-strata,由edge0-infer启动 | | macOS正式支持 | 暂未提供145B正式发布支持 |
官方虽然公布了Apple M2 Ultra的测试数据,但同时强调该成绩不代表macOS版本已经开放。M2 Ultra上的Q3_K Agent解码速度为57.0 token/s,技术上已经达到可用水平,但用户目前不能把这组跑分理解为“下载后即可在Mac运行”。(huggingface.co)
Edge0 提供统一的edge0-infer入口,可通过命令行、交互式聊天或本地服务运行模型,Windows用户还可以使用Edge0 Chat桌面应用选择模型目录。145B与120B模型实际由edge0-strata执行,而此前35B模型使用的是基于GGML的原生引擎,两套后端目前仍然存在差异。
开源代码不等于模型可随意商用
Edge0 的框架代码采用Apache-2.0许可证,但Edge0-145B模型使用自定义的Edge0 Community Model License 1.0,并同时受到上游Qwen许可证约束。
该许可证允许个人使用、研究、修改、非商业分享、企业内部使用以及在满足上游条款时商业使用模型生成的内容。不过,销售或商业捆绑模型、运营商业模型服务,以及提供独立的商业编程或办公助手,需要另行获得Edge0的书面许可。(huggingface.co)
这意味着Edge0-145B适合开发者研究、本地个人Agent和企业内部实验,但准备把它直接做成收费产品的团队,不能只看到GitHub仓库里的Apache-2.0标识。框架许可证与模型权重许可证是两件不同的事。
Edge0真正值得关注的是推理系统
Edge0-145B最有价值的地方,不是创造了一个新的145B基础模型,而是把超大稀疏模型的部署问题从“显存必须装下全部权重”改写成了“显存只装下当前需要的专家”。
这个方向对本地Agent尤其重要。Agent生成任务通常持续时间长、输出Token多,还会频繁读取代码、日志和工具结果;云端模型会带来持续费用、数据外发和网络延迟,而小型本地模型又经常在复杂规划和代码修改上能力不足。Edge0试图用消费级硬件承担更大模型,正好击中了这组矛盾。
但Edge0-145B目前更接近极客和开发团队的工程预览,而不是面向所有消费者的一键式产品。40GB以上的模型文件、CUDA 13、系统内存需求、定制推理引擎和仍待验证的第三方跑分,都决定了它不会像7B或14B模型那样容易普及。
Edge0-145B仍然改变了本地模型的讨论边界。过去大家争论的是“24GB显存能不能运行70B”,现在问题已经变成“能否通过稀疏激活和权重流式加载,在同一张显卡上运行145B甚至更大的模型”。如果Edge0后续能把安装流程、跨平台支持和专家加载稳定性做成熟,百亿参数本地模型可能不再是硬件容量问题,而会变成推理系统设计问题。
参考来源
- Edge0 GitHub项目主页:包含2026年11月13日发布记录、架构参数、性能测试、平台支持和许可证说明。
- Edge0-145B Q3_K模型页面:包含模型权重、硬件测试数据、架构配置及运行说明。
- Edge0 Hugging Face主页:汇总Edge0-145B、120B、35B及语音模型。
- Edge0 SSD流式专家文档:解释专家权重映射、缓存和按需加载机制。
- Edge0预路由器技术文档:解释如何提前预测专家选择并隐藏权重加载延迟。