Doc-foundry让AI自证检测规则
Doc-foundry用蓝红多智能体生成和攻击Sigma规则,再由确定性引擎计算误报、漏报与绕过结果。它真正有价值的不是“AI写规则”,而是把验证证据和审批链一起交付。
Doc-foundry让AI编写安全规则,还要求AI拿出有效证据
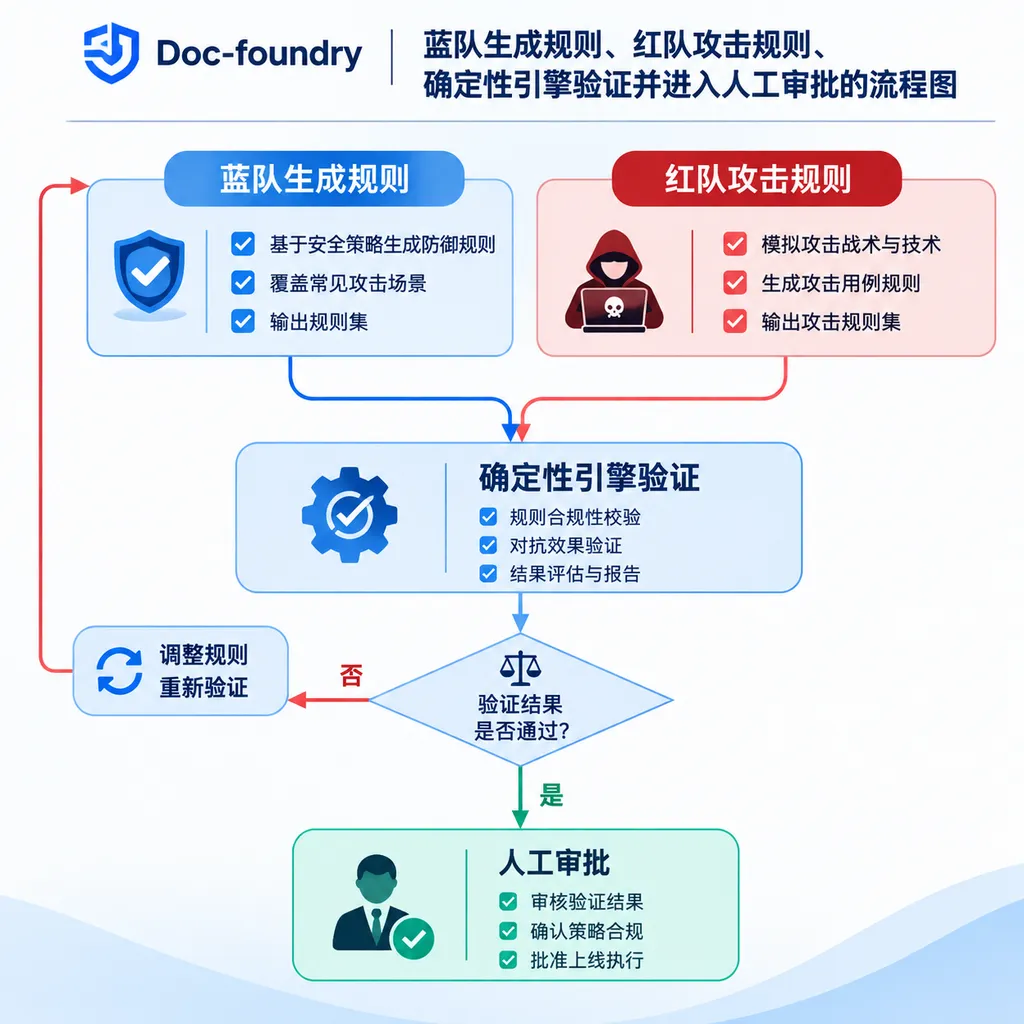
**AI 自动生成安全检测规则并不稀奇,难的是证明这条规则真的能抓住攻击,同时不会让 SOC 团队淹没在误报里。**近日出现在 GitHub 上的开源项目 DOC-foundry,试图把这两个问题合并成一条流水线:让蓝队智能体编写 Sigma 规则,让红队智能体寻找绕过方式,再交给一个不使用大模型的确定性引擎裁决规则是否有效。
截至 2026 年 11 月 14 日,这个项目仍然非常早期,GitHub 仓库只有 3 次提交、0 个 Star 和 1 个 Fork。它显然还不是一套可以直接替代成熟 SIEM 工程平台的产品,但它提出的方向值得安全团队关注:模型可以负责提出规则和攻击思路,最终结论必须由可重复运行的测试决定。 (github.com)
它不是又一个“让大模型写Sigma”的项目
**Sigma 是一种厂商无关的日志检测规则格式,可以把同一套检测逻辑转换到 Splunk、Elastic、Microsoft Sentinel 等不同安全平台。**它解决的是检测规则的可移植性问题,但一条语法正确的 Sigma 规则,并不等于一条有效的安全规则。
普通的大模型生成器通常做到这里就结束了:输入一个 CVE、MITRE ATT&CK 技术编号或攻击描述,模型输出一段 YAML。规则看起来字段齐全,有标题、有 ATT&CK 标签、有检测条件,甚至会附上误报说明,但它可能存在三类常见问题:
- 规则依赖攻击者可以轻易修改的字符串,例如固定文件名或命令参数;
- 规则使用了日志源根本不会提供的字段,实际部署后召回率直接归零;
- 规则为了提高召回率写得过宽,在生产环境触发大量正常行为。
**DOC-foundry 是一个面向 Detection-as-Code 的多智能体检测工程工作流。**Detection-as-Code 是把安全规则当作软件代码管理的方法,包括版本控制、测试、评审、发布门禁和可追溯记录,而不只是把 YAML 文件扔进 SIEM。
DOC-foundry 的核心变化,是把“生成规则”降级成整个流程中的一个步骤。一次完整运行会交付三类文件:
- 经过蓝队与红队循环修改的 Sigma 规则;
- 记录每轮修改、绕过和收敛过程的威胁报告;
- 包含正样本、正常样本、对抗变体、误报和漏报结果,以及可复现哈希的证明包。
项目作者把第三项视为主要差异:模型不只是交付答案,还要交付一套能够重新执行的证据。这个判断是对的,因为安全检测最怕的并不是规则写得慢,而是规则看起来专业,却从来没有在攻击样本和正常样本上跑过。
四个智能体提方案,确定性引擎做裁判
**DOC-foundry 把大模型限制在“提出候选方案”的位置,而不允许模型决定自己的规则是否通过。**当前工作流包含 Threat Analyst、Telemetry、Blue Detection Engineer 和 Red-Team Adversary 四个角色,分别负责规范化威胁、构造遥测数据集、编写规则和提出绕过攻击。
其主要流水线可以简化为:
ingest → extract → telemetry
                     ↓
blue_author → evaluate → mutation battery → red_propose
     ↑                                      ↓
     └──── repair ← verdict ← red_verify ───┘
                              ↓
                         gate → bundle
**蓝队智能体负责生成第一版规则,并根据真实的误报、漏报和绕过证据重写规则。**它拿到的不是一句模糊的“规则还不够好”,而是具体到某个攻击事件为什么没有触发、某个正常事件为什么被误报,以及哪一种变形绕过了当前条件。
**红队智能体负责提交可以被机器验证的绕过样本,而不是只写一段攻击点评。**如果红队声称某个改名或混淆方式可以绕过规则,确定性引擎会把这个事件重新喂给规则;只有规则确实没有触发,这次绕过才会计入结果。未经引擎确认的攻击建议会被丢弃。
**确定性裁判是 DOC-foundry 最关键的可信边界。**项目自带一个用 Python 编写的 Sigma 子集匹配器,相同规则和相同事件会得到相同布尔结果,不依赖模型判断、随机采样或网络状态。引擎负责计算 TP、FP、TN、FN、Precision、Recall 和 F1,并将规则标记为 broken、brittle 或 real-coverage。 (raw.githubusercontent.com)
这里的逻辑很像软件开发中的单元测试:大模型相当于程序员,可以写代码,也可以提出测试思路;确定性引擎相当于测试运行器,不会因为作者解释得很有说服力,就把失败的测试改成通过。
它怎样攻击一条看似正确的规则
**对抗变异测试是把已知恶意事件机械地改写,再检查规则是否仍然触发。**DOC-foundry 当前实现的变异包括命令大小写变化、空格填充、插入脱字符或引号、二进制文件改名,以及将程序移动到其他路径。
项目提供的离线示例使用了 Windows 自带工具 certutil。第一版规则依赖 Image 中的程序路径,因此当攻击者把 certutil.exe 复制并重命名为 AdobeUpdater.exe 或其他名称时,规则就会失效。
蓝队收到绕过证据后,会把检测锚点改到更难伪装的 OriginalFileName 等遥测字段。第二轮中,同一个改名事件再次被测试;如果新规则成功触发,红队的绕过主张就会被引擎驳回。
这种设计有两个值得肯定的细节。
**第一,红队在第一轮提交的真实攻击会被固定下来,后续每轮重复测试同一组攻击。**如果红队每轮都可以临时更换目标,蓝队永远无法收敛;固定攻击集则类似回归测试,可以证明上一轮修复的问题没有重新出现。
**第二,模型写出无法解析或无法完整评估的 Sigma 语法时,系统不会假装测试通过。**当前引擎支持 contains、startswith、endswith、正则、通配符、布尔条件和部分 N of 表达式,但不支持 CIDR、Base64 修饰符、数值比较、字段引用和聚合条件。遇到不支持的结构时,引擎会直接抛出错误,将该轮标记为 broken,再把错误信息交给蓝队修复。 (raw.githubusercontent.com)
这比静默忽略未知语法可靠得多。安全工具如果把自己无法理解的规则当作通过,生成的不是检测能力,而是一种更危险的虚假确定性。
4,466份开源资料用于“出题”,不参与“判卷”
**DOC-foundry 的知识库是一个离线 BM25 检索系统,用于给蓝队和红队提供真实的规则与攻击资料。**项目当前声明收录 3,769 份来自 SigmaHQ 的检测文档,以及 697 份来自 MITRE ATT&CK Enterprise 数据的攻击技术文档,合计 4,466 份;此外还使用 LOLBAS 和 Atomic Red Team 内容。 (raw.githubusercontent.com)
蓝队会从 SigmaHQ 规则中检索相近的检测思路,红队会从 ATT&CK 防御规避技术和 LOLBAS 中寻找真实攻击手法。项目选择 BM25 而不是向量数据库,理由也比较务实:安全规则里充满 T1036.003、OriginalFileName、certutil 这类精确标识,关键词检索通常比语义相似度更可控,而且可以完全离线运行。
**知识库只负责提升候选方案质量,不参与最终证明。**换句话说,检索到一条高质量 SigmaHQ 规则,并不能让新规则自动获得通过;最终判定仍然来自测试语料、匹配结果和经过验证的红队样本。知识库内容也不进入证明包的可复现哈希。
这个边界划得很重要。RAG 可以降低模型胡编字段和攻击技术的概率,但“引用过正确资料”与“当前规则能够命中当前日志”是两件不同的事。
两条流水线解决两个不同问题
**DOC-foundry 实际提供“证明循环”和“评审链”两套不同工作流。**两者使用相似的智能体角色,但不能混为一谈。
| 工作流 | 主要问题 | 是否执行规则 | 是否计算FP/FN | 主要输出 | |---|---|---:|---:|---| | Proof Loop | 规则能否命中固定攻击样本并避开正常样本 | 是 | 是 | 规则、报告、proof.json | | Review Chain | 红队和SOC负责人会怎样修改这条规则 | 否 | 否 | 最终规则、评审历史、review.json |
评审链的顺序是蓝队初稿、红队评审、蓝队修订、SOC Lead 运营评审、蓝队最终版本。红队会推动规则覆盖更多变体,SOC Lead 则会反过来压缩误报和告警量,这两种力量天然冲突。
项目展示的 Joomla iCagenda 漏洞案例中,第一版规则要求 Web 服务进程启动 Shell 后,还必须出现 whoami、uname 等侦察命令。红队指出攻击者完全可以跳过侦察,直接下载载荷或建立反向 Shell;扩大范围后,SOC Lead 又指出宽松的用户和父进程条件会让正常的 www-data 任务大量触发。最终版本增加父子进程约束、正常解释器链排除项和调查字段,并将严重级别从 high 调整为 medium。 (github.com)
**评审链的价值是把“为什么这样改”保存下来,但它不能替代执行测试。**项目自己也明确在评审产物顶部标注“Reviewed, not validated”,提醒用户这条规则虽然经过多个角色讨论,却没有真正计算误报和漏报。
与普通AI规则生成器相比,差别在哪里
**DOC-foundry 的竞争优势不是使用了更强的模型,而是给模型设置了一个无法靠语言说服的裁判。**当前代码可以使用 Claude 或 Gemini 负责生成,离线模式则通过固定 Fixture 完整运行测试流程;证明核心本身不依赖第三方包。
| 维度 | 普通LLM规则生成 | 传统人工检测工程 | DOC-foundry | |---|---|---|---| | 初稿速度 | 快 | 慢 | 快 | | 攻击绕过测试 | 通常没有 | 依赖工程师经验 | 自动变异+红队智能体 | | 误报测试 | 通常没有 | 手工抽样 | 固定正常样本计算FP | | 结果可复现 | 较弱 | 取决于流程 | 规则、语料和结果带哈希 | | 评审记录 | 对话文本 | 工单或代码评审 | 自动生成完整演进记录 | | 自动部署 | 可能直接执行 | 通常人工审批 | 强制经过门禁 | | 当前成熟度 | 产品差异较大 | 成熟但成本高 | 早期原型 |
项目还设计了名为 Kartikeya's Gate 的部署门禁,以“影响范围乘以新增能力”计算风险。只要涉及向外部 SIEM 推送规则,就必须由人工审批;审批令牌还会绑定规则包的内容哈希,理论上不能拿规则 A 的批准结果去部署规则 B。当前所谓的部署只是生成本地记录,Splunk、Elastic 或 Sentinel 的真实连接器仍需要用户自行实现。 (raw.githubusercontent.com)
最大的问题:“证明有效”仍然是有边界的
**DOC-foundry 提供的是针对固定语料和有限攻击集合的可重复验证,不是数学意义上的安全证明。**如果正样本没有覆盖某种攻击路径,正常样本没有覆盖企业真实业务,或者日志采集字段与生产环境不同,real-coverage 也只能说明规则通过了当前测试集。
这一点决定了项目名称里的“prove”必须带着作用域理解:它证明的是“这条规则在这些输入、这些字段和这个匹配器上得到这些结果”,而不是“这条规则能识别未来所有攻击”。
**当前实现的 Sigma 支持范围也限制了它能验证的规则复杂度。**许多真实生产规则依赖时间窗口、聚合、阈值、跨事件关联、CIDR、序列检测和后端特定语义,而内置引擎目前主要处理单事件匹配。简单的进程创建、命令行和文件事件更适合它,复杂的身份攻击或横向移动检测则可能超出范围。
**当前代码对机械变异与真实红队攻击的权重也值得继续讨论。**评估器会记录大小写、空格、路径移动等机械变异结果,但目前决定 real-coverage 的关键条件,是零漏报、零误报,以及没有经过引擎确认的红队真实绕过;部分机械变异可以作为后续加固清单保留,而不必阻止规则获得最高标签。这个取舍有利于让第一版规则尽快可用,但也意味着用户不能只看绿色标签,仍要阅读 proof.json 中的剩余绕过项。 (raw.githubusercontent.com)
**项目本身也缺少外部独立基准。**仓库给出的三轮 Gemini 轻量模型运行时间约为 20 至 40 秒,但该数字来自作者说明,并非跨模型、跨日志源或大规模规则集测试。仓库当前的提交数和社区参与度也很低,因此更适合被视为一套有启发性的参考实现,而不是已经验证过的企业级平台。
真正有用的是“证据优先”的架构
**DOC-foundry 最值得借鉴的不是某个智能体提示词,而是“Agents propose, engine proves”的职责分离。**AI 安全工具现在普遍喜欢强调智能体数量、自动化步骤和生成速度,但在检测工程里,生成从来不是最昂贵的部分;验证、调优、回归测试和审计才是。
安全团队未必需要原样采用这套项目,却可以复用它的四个原则:
- 固定攻击样本和正常样本,避免每轮测试标准变化;
- 将红队提出的绕过重新执行,而不是相信模型描述;
- 对无法解释或无法执行的规则直接失败,不做静默降级;
- 把规则、测试结果、审批记录和内容哈希作为一个整体发布。
**如果 DOC-foundry 后续接入真实 EVTX、云审计日志和主流 SIEM 后端测试,它可能成为 AI 检测工程的一块实用底座。**但在当前阶段,它最准确的定位仍然是“可运行的设计论文”:概念先进,边界清楚,代码已经能展示完整闭环,但距离生产环境仍缺真实数据规模、后端一致性验证、规则生命周期管理和社区检验。
参考来源
- DOC-foundry GitHub 仓库:项目架构、运行方式、证明循环和评审链的主要说明。
- Joomla iCagenda 规则评审案例:展示规则从初稿到红队、SOC Lead 评审后的完整演进过程。
- SigmaHQ:DOC-foundry 蓝队知识库的主要开源检测规则来源。
- Atomic Red Team:项目用于构造真实攻击命令正样本的开源测试库。
- LOLBAS:项目红队知识库使用的 Living Off The Land 攻击资料来源。
- LangGraph:DOC-foundry 多智能体状态图和循环编排使用的开源框架。