谷歌让AI组队证明韦伊猜想
Google 扩展 Antigravity Teamwork,多智能体用 180 万行 Lean 完成韦伊猜想形式化。真正的突破不是模型更会推理,而是把质疑、验证和纠错做成了系统。
谷歌让AI组队证明韦伊猜想
Google 正在把多智能体从“并行写代码”推向真正的科研基础设施。
11 月 13 日,Google Research 公布 Antigravity /teamwork 的最新进展:由 Gemini 4 Argon 等模型驱动的专业智能体团队,已经完成韦伊猜想的端到端形式化验证,并将这套多智能体工作流扩展到数学证明、分子结构识别、系统软件迁移和基础设施优化等任务。消息于 11 月 14 日在国内传播。(research.google)
这次最引人注目的数字是 180 万行 Lean 代码和 2.88 万次子智能体调用。Google 称,/teamwork-LEAP 从非形式化证明出发,在没有人工逐段编写 Lean 证明的情况下,完成了韦伊猜想的机器可检查形式化。(research.google)
180 万行代码,到底证明了什么
**韦伊猜想是一组描述有限域上代数簇点数规律的数学命题。**通俗地说,它研究的是:当多项式方程被放在一个只有有限个数字的世界里时,究竟会有多少组解,以及这些解的数量如何随有限域规模变化。
韦伊猜想并不是今天才被证明的开放问题。数学家皮埃尔·德利涅在 1974 年完成了其中最关键部分的证明,并因此获得菲尔兹奖;Google 此次完成的是形式化验证,而不是重新发现韦伊猜想的首个数学证明。
**形式化验证是把数学定义、定理和每一步推理翻译成证明助手能够逐行检查的程序。**传统论文中的“显然可得”“类似可证”或对背景知识的默认引用,在 Lean 中通常都必须被展开为明确的定义、引理和依赖关系。
Lean 则是一种交互式定理证明器及函数式编程语言。它不会因为证明“看起来合理”就接受结果,而是由一个尽可能小、可审计的内核检查每一个证明项是否满足形式规则。
因此,180 万行 Lean 代码并不意味着 AI 写出了一篇长达 180 万行的人类论文。它更像是把一座数学大楼拆成每一块砖、每一根钢筋和每一个连接件,再让机器核对整座建筑是否按照设计图搭成。
这项工作的价值也正在这里:自然语言证明依赖专家理解,而形式化证明可以重复编译、自动检查,并作为其他定理的可靠依赖。
但必须强调,**Lean 编译通过不等于数学表达一定准确。**证明助手能够确认“代码中的定理可以由给定公理和定义推出”,却无法独自保证形式化后的定理陈述与数学家原本想表达的命题完全一致。Google 自己也承认,人类数学家仍需确认形式化陈述与原始问题是否匹配。(research.google)
Teamwork 不是多开几个聊天窗口
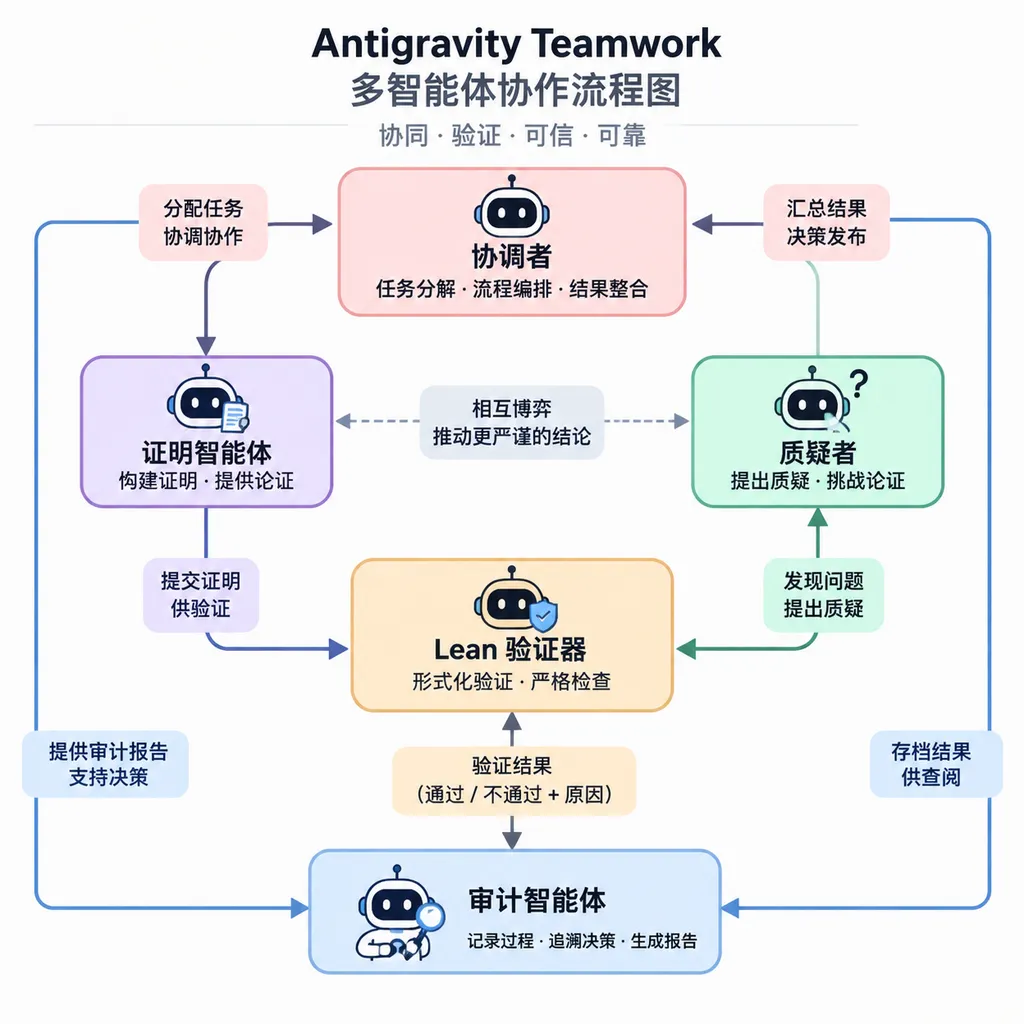
**Antigravity Teamwork 是 Google 面向长周期任务设计的多智能体编排框架。**它并不只是同时启动多个 Gemini 实例,而是把生成方案、寻找反例、执行验证、整合结果和最终审计分配给不同角色。
Google 将当前大模型的核心问题归纳为两类:一类是单次生成结果不稳定,另一类是模型在持续数小时甚至数天的任务中容易丢失细节。
Teamwork 对第一个问题的解决方案是引入专门的“证伪者”。证明任务可以交给 Lean 内核检查,代码迁移可以运行未经修改的测试套件,系统优化可以通过硬件计数器和性能基准测试验证。一个智能体说自己完成了任务没有意义,外部验证器给出可重复的通过结果才有意义。
Teamwork 对第二个问题的解决方案是主动切割上下文。每个专业智能体只能访问当前步骤需要的文件、工具和状态,任务完成后再由协调者将结果交给新的智能体,而不是让一个模型背着越来越长的对话历史工作几天。
这套结构与普通多智能体系统的差异,可以概括为下表:
| 方案 | 任务组织方式 | 验证机制 | 适合任务 | 主要风险 |
|---|---|---|---|---|
| 单智能体 | 一个模型连续完成全部步骤 | 自我检查或人工检查 | 问答、小型编码、短推理 | 长任务遗忘细节,错误持续累积 |
| 松散多智能体 | 多个角色并行输出建议 | 相互讨论、投票或汇总 | 调研、头脑风暴、可拆分任务 | 智能体容易互相附和,错误交叉传播 |
| /boost | 顺序执行“实现—质疑—修改—复验” | 测试与改进智能体反复挑战结果 | 难以拆分的 Bug、算法和重构 | 迭代次数增加计算成本 |
| /teamwork | 按里程碑拆解,动态创建专业智能体 | Critic、Challenger、Auditor 与外部工具共同验证 | 数学证明、大型迁移、科研和系统工程 | 成本高,最终目标和验收标准仍需人类定义 |
Google 的关键进步不是让智能体“讨论得更热闹”,而是把反对意见制度化。生产者无法依靠自己的推理过程说服审查者,审查者必须从相对干净的上下文出发,重新检查结果和证据。(research.google)
这种设计很像软件工程里的代码评审、测试和持续集成:开发者写出代码,测试套件并不关心开发者当时是怎么想的,只关心输入、输出和不变量是否正确。
LEAP 让通用模型接上 Lean 编译器
**LEAP 是一个让通用大模型在 Lean 环境中规划、生成和修复形式化证明的智能体框架。**它的全称是 LLM-in-Lean Environment Agentic Prover,核心并不是训练一个只会写 Lean 的专用模型,而是让通用模型不断与 Lean 编译器交互。
LEAP 会先把非形式化证明整理为高层蓝图,再将蓝图拆成带有依赖关系的证明目标。每一个目标都可以继续分解为引理,由不同智能体并行尝试;Lean 返回的类型错误、未完成目标和证明失败信息,则成为下一轮修正的输入。
这种方法改变了形式化数学的能力瓶颈。LEAP 论文显示,通用模型在 Lean-IMO-Bench 上直接生成证明时,成功率不足 10%;加入分解、规划、编译器反馈和迭代修正后,整体解题率达到 70%,超过论文引用的 48% 专用系统基准。LEAP 还形式化解决了 2025 年 Putnam 数学竞赛全部 12 道题。(arxiv.org)
| 形式化证明方式 | 核心能力 | Lean-IMO-Bench 表现 | 特点 | |---|---|---:|---| | 通用模型直接生成 | 单次输出 Lean 证明 | 不足 10% | 成本低,但复杂证明容易在后段崩溃 | | 专用形式化系统基准 | 专门训练的证明模型与搜索组件 | 48% | 形式语言能力强,但模型和训练流程高度专用 | | LEAP 多阶段框架 | 蓝图分解、并行证明、编译器反馈、自我修正 | 70% | 依赖通用模型和工程编排,不要求专门微调 |
韦伊猜想形式化把这条路线从竞赛题推进到了大规模现代数学。2.88 万次调用说明,这不是某次神奇的单轮回答,而是一次规模化搜索、修复和验证工程。
这也是为什么只比较底层模型跑分越来越不够。模型决定一个智能体单次能够提出多好的方案,但编排框架决定系统能否在数万次尝试后仍维持依赖关系、记住失败路径,并最终交付可验证结果。
比证明韦伊猜想更重要的是“验证闭环”
Google 同期公布的其他结果说明,Teamwork 并不是只针对 Lean 调优的数学演示。
**在数学与理论计算机科学领域,Teamwork 已经从“翻译证明”扩展到“参与发现证明”。**Google 与多所高校研究者使用 Long Proof 工作流解决 Courtade–Kumar 猜想的一般情形,系统将参数空间拆分,并生成分析界限和区间算术证书,最后形成约 5000 万行 Lean 代码。(research.google)
Google 还称,系统生成超过 91.9 万行 Lean,完成一般整数环上希尔伯特第十问题近期证明的首次形式化,并独立复现了带光滑外力的三维纳维—斯托克斯方程有限时间爆破证明。系统还在形式化三维 Bochner–Riesz 猜想时,发现并修复了一份近期非形式化证明中的缺口。(research.google)
**在分子化学领域,Teamwork 把客观验证器换成了物理模拟器。**30 个专业智能体结合带有物理知识的光谱模拟器,根据核磁共振数据推断分子结构,在复杂分子基准上取得 95% 的 Top-1 精确匹配率和 100% 的 Top-3 准确率,Top-1 表现接近单智能体的两倍。(research.google)
**在系统工程领域,Teamwork 把客观验证器换成了原始测试套件和性能分析器。**系统将 Google 的 libgav1 AV1 解码器从 C++ 改写为约 17 万行 Rust,并在广泛的一致性测试中实现 100% 比特级一致。
这个迁移一开始比原版 C++ 慢约 4 倍,但在获得性能分析工具和明确优化目标后,Rust 版本最终在 x86_64 和 ARM 上比原始 C++ 及手写汇编实现快 20% 至 30%。(research.google)
| 项目 | 智能体产出 | 客观验证方式 | 结果 | |---|---:|---|---:| | 韦伊猜想形式化 | 约 180 万行 Lean | Lean 内核 | 2.88 万次子智能体调用完成端到端形式化 | | 希尔伯特第十问题相关证明 | 超过 91.9 万行 Lean | Lean 内核 | 完成一般整数环版本的首次形式化 | | Courtade–Kumar 猜想 | 约 5000 万行 Lean | Lean 与区间算术证书 | 证明一般情形 | | NMR 分子结构识别 | 30 个专业智能体 | 物理光谱模拟器 | Top-1 95%,Top-3 100% | | libgav1 Rust 重写 | 约 17 万行 Rust | 原始测试套件与性能分析 | 100% 比特一致,性能快 20%—30% |
这些案例共享同一个逻辑:先找到能够自动判定结果好坏的环境,再让智能体在这个环境中持续搜索。
换句话说,多智能体真正适合的不是“答案很长”的任务,而是“反馈足够可靠”的任务。Lean 编译器、测试套件、模拟器和硬件计数器都能提供低歧义反馈;战略判断、产品审美和缺乏客观标准的开放创作,则很难获得同样的提升。
180 万行不是越多越好
Google 公布的数字足够震撼,但代码规模本身不能直接代表证明质量。
**形式化证明的长期价值取决于可复用性、可维护性和人类可审查性。**如果 180 万行代码大量重复已有定义,或者只能在特定依赖版本中编译,其科研价值就会低于结构清晰、能够进入 Mathlib 并被其他项目调用的形式化成果。
Google 目前强调的是“端到端、机器检查和完全自主”,尚未在公告中提供足够信息说明韦伊猜想形式化代码的模块结构、编译资源消耗、依赖版本、人工审查范围,以及其中多少代码能够回馈公共 Lean 生态。
2.88 万次子智能体调用也意味着显著的推理成本。Google 没有公布这次任务的 Token 消耗、运行时间和实际费用,因此外界目前无法判断这种规模的形式化是否具备普遍经济性。
这并不削弱结果的意义,却决定了它现阶段更像一项基础设施能力展示,而不是普通数学团队明天就能直接复制的工作流。
多智能体竞争从“角色扮演”进入“组织设计”
这次更新给 Agent 行业最清晰的信号是:模型能力正在逐渐变成组件,智能体组织结构正在成为产品差异。
过去不少多智能体产品停留在角色提示词层面:一个扮演产品经理,一个扮演程序员,一个扮演测试工程师,最后由“负责人”汇总答案。这种设计看起来像团队,却没有真实组织最关键的责任边界、权限隔离、交付标准和否决机制。
Teamwork 的做法更接近工程组织:
- 每个智能体只获得完成任务需要的文件和工具;
- 多个智能体不会同时修改同一个文件;
- 生产者、质疑者和审计者使用不同上下文;
- 阶段性结果必须通过测试、证明内核或模拟器;
- 失败路径不会被简单删除,而会作为后续搜索的避坑记录;
- 人类负责提出问题、设定约束和最终验收,而不是逐步遥控每个智能体。
这套机制的核心不是“更多 Agent”,而是“更严格的协作协议”。如果没有独立验证器,智能体数量增加只会让错误以更高速度复制;如果验证器足够可靠,较便宜、较快的模型也可能通过大规模搜索完成此前只有旗舰模型才能尝试的任务。
Google 正在把 Teamwork 开放给外部用户
Google 表示,外部研究者和开发者目前已经可以在 Antigravity 中使用 Gemini 4 模型、/teamwork、/boost 和 Deep Review,部分形式化证明模式及专业工作流将在后续更新中继续开放。(research.google)
/teamwork 主要面向持续数小时到数天、包含多个里程碑的项目;/boost 则更适合难以拆分、需要连续实现和反复验证的编程问题。按照目前文档,Teamwork 面向付费方案开放,运行前会进行需求澄清,并为项目创建独立工作目录和审计节点。(antigravity.google)
Google 还计划向 1 万名学术研究人员提供 6 个月最高用量等级的免费访问权限。Deep Review 则向用户提供每周两次免费调用;在 STOC 2027 投稿前的测试中,578 篇投稿的作者使用了该功能,调查中的 70 名作者里,90% 认为反馈基本或几乎全部符合事实,超过 30% 表示工具发现了实质性证明错误或重要数学笔误。(research.google)
OpenAI Hub 观点:Harness 开始比模型名字更重要
韦伊猜想形式化不是一个“大模型终于会做数学了”的简单故事。
它更准确地说明,前沿模型只有被放进正确的工具环境、任务结构和验证闭环,才可能把概率性的文本生成转化为可审计的科研产物。
Google 此次最有竞争力的部分不是 Gemini 4 Argon 单次回答了什么,而是 Teamwork 能够组织 2.88 万次子任务,让不同智能体在受限上下文中生成、质疑、修正和验证,最后形成一份 Lean 内核能够接受的巨大证明工程。
这条路线也会提高多智能体产品的门槛。未来真正有价值的 Agent 平台,不能只提供并发调用和角色模板,还需要解决权限隔离、状态持久化、任务依赖、失败恢复、客观评测和完整审计链。
当然,Google 仍需公开更多可复现材料。韦伊猜想形式化是否能够被独立编译、数学家需要投入多少时间确认定理陈述、代码是否具有可维护性,以及完成任务的真实成本,都会影响这项成果最终是一次漂亮演示,还是形式化数学的基础设施转折点。
但方向已经相当明确:大模型竞争正在从“谁能一次答对”,转向“谁能组织大量不可靠的智能体,持续产出可以被可靠工具验证的结果”。
当 AI 开始进入数学、化学和系统工程,最稀缺的能力可能不再是生成,而是构建一套不轻易相信生成结果的系统。
参考来源
- IT之家:谷歌利用多个专业 AI 智能体打造 Teamwork 系统——国内报道,整理了韦伊猜想形式化、分子结构识别和 libgav1 Rust 重写等核心数据。
- GitHub:Google DeepMind LEAP 相关代码——LEAP 形式化数学智能体框架的公开证明结果与工程资源。
- GitHub:Google DeepMind Formal Conjectures——Google DeepMind 维护的 Lean 4 数学猜想形式化项目,可用于了解形式化命题和 Mathlib 生态。