TimeCues Studio开源:音乐标注终于一体化
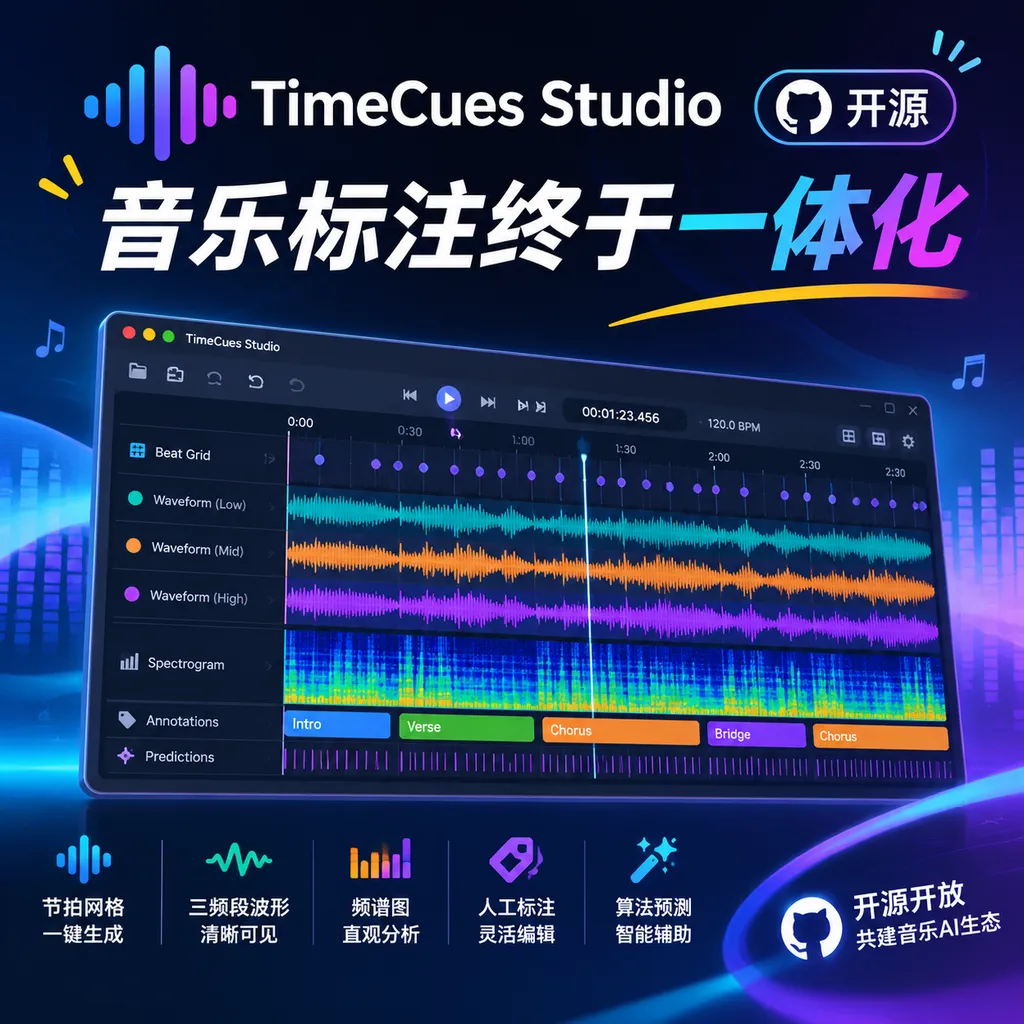
TimeCues Studio 将音乐结构标注、团队协作、算法运行与量化评测整合进同一条时间轴,试图解决音乐 AI 数据生产工具长期割裂的问题。
音乐 AI 终于有了一套标注与评测工作台
TimeCues Studio 在 ACM Multimedia 2026 会议结束后正式公开,是一款面向音乐结构标注、算法开发与模型评测的开源 Web 工具。项目作者 Sapir Caduri 于 11 月 14 日在 Reddit 的 r/MachineLearning 社区介绍了这项博士研究,代码采用 MIT 许可证开放,用户可以通过 Docker Compose 在本地或服务器部署。(reddit.com)
**TimeCues Studio 是一个把音乐语料管理、人工标注、算法预测和量化评测放在同一条时间轴上的可视化工作区。**它不是简单地给音频波形增加几个标签按钮,而是试图覆盖音乐分析模型从制作数据集、检查标签,到比较算法、修正预测结果的完整闭环。
这套工具最值得关注的地方,不是又多了一个音频编辑界面,而是它把音乐信息检索领域长期分散的工具链接了起来。过去,研究者可能在 Audacity 或 Sonic Visualiser 里标注时间点,用 Python 脚本运行 MSAF 或其他分段算法,再把结果导出到另一个脚本中调用 mir_eval,最后自行制作表格比较模型。任何一处文件命名、时间单位或标签格式不一致,都可能让实验结果失真。
TimeCues Studio 的思路更像是给音乐 AI 团队做了一个轻量版 Label Studio 加模型竞技场:人类标签和算法输出出现在同一视图中,算法跑完就能叠加到时间轴上,并直接对照人工参考标签计算指标。
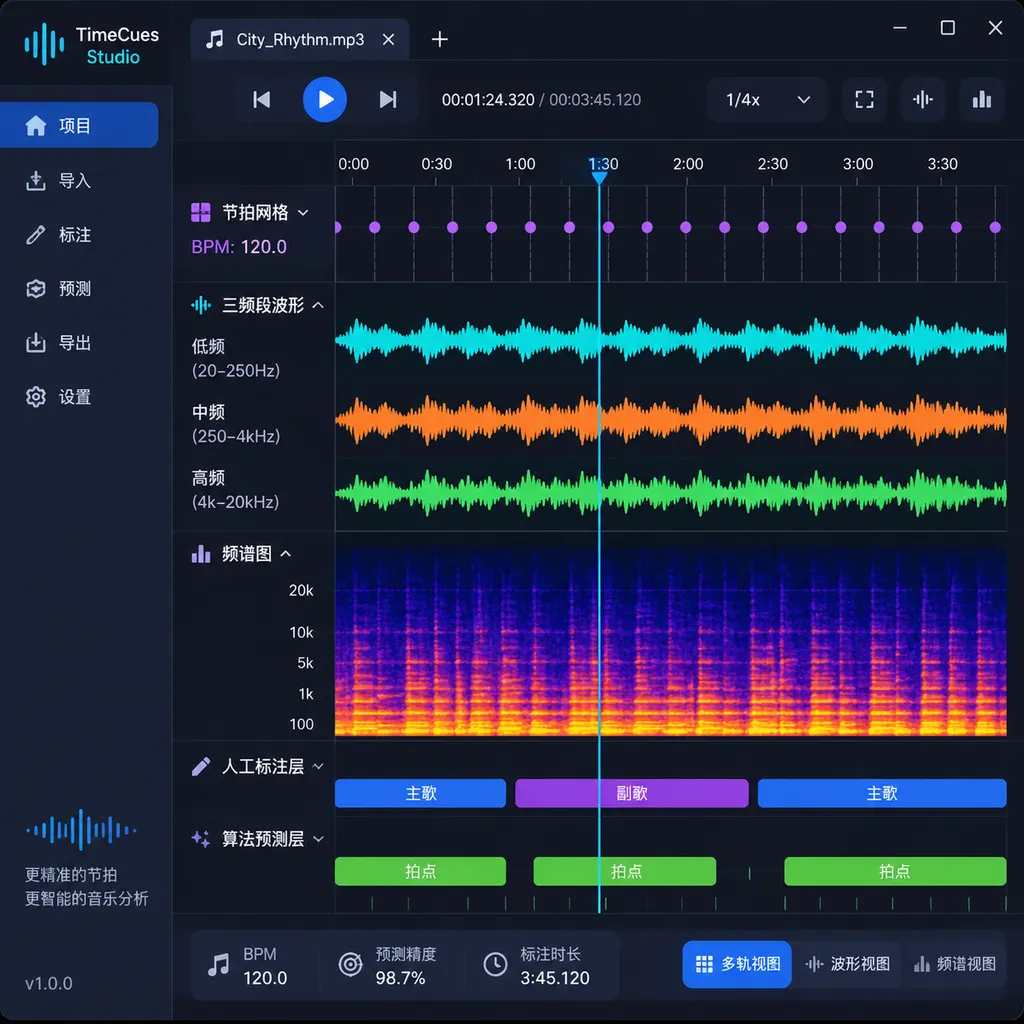
三频段波形是它最直观的创新
**三频段波形是把低频、中频和高频能量用不同颜色绘制在同一轮廓中的音频可视化方式。**传统波形只能告诉用户某一时刻声音大不大,却很难说明变化来自底鼓、主唱、合成器还是镲片;TimeCues Studio 默认将 bass、mids 和 treble 分色,让不同频段的结构变化直接显形。
这个设计对电子音乐、舞曲和短视频卡点尤其有用。一次 Drop 到来时,低频底鼓可能突然进入;一次段落切换时,高频镲片可能先退出,中频旋律随后变化。在普通波形中,这些事件经常挤成一团,但在三频段视图中,标注者可以先用眼睛找到候选位置,再通过循环播放完成确认。
TimeCues Studio 还可以把频谱图、MFCC、Chroma、Tempogram、自相似矩阵、Onset、Novelty Curve 等音乐分析信号堆叠在同一条同步时间轴上。项目同时集成 Demucs 分轨能力,因此同一类特征不仅能针对完整混音计算,也能单独观察 Vocals、Drums、Bass 或 Other 分轨。GitHub 项目说明显示,这些信号与算法结果都围绕同一时间轴组织,避免研究者在多个窗口之间反复对齐。(github.com)
这种设计解决的是音乐标注中一个常被低估的问题:标注者并不是只靠听觉工作。对长达数分钟的歌曲反复试听,既慢又容易疲劳;如果能用频谱、和声、节奏与分轨信息先缩小范围,人工任务就会从寻找事件变成确认事件。
它能标的不只是主歌和副歌
**音乐结构标注是为音频中的时间点、时间区间、重复结构或语义段落添加机器可读标签的过程。**TimeCues Studio 支持 Boundaries、Cues、Spans、Loops、Riff Patterns 和 Lyrics 等多种结构,而不是把所有任务都压缩成单一的歌曲分段问题。
- Boundaries 用于标记 Intro、Verse、Chorus、Bridge、Drop 等不重叠段落的边界。
- Cues 用于标记鼓点进入、灯光触发、镜头切换或某句歌词开始等单个时间点。
- Spans 用于标记人声出现、乐器活动或情绪持续区间,并允许多个区间重叠。
- Loops 用于定义可重复播放的片段及循环长度。
- Riff Patterns 用于标注重复出现但位置不同的动机、节奏型或乐句。
- Lyrics 用于处理歌词行、单词及其时间对齐。
这些标签全部可以吸附到节拍网格上。节拍网格提供固定 BPM、动态速度曲线和手工定位等模式,适合从严格量化的电子音乐到存在速度漂移的现场演奏。对于音乐到舞蹈、音乐到视频、自动灯光和节奏驱动动画来说,节拍对齐通常比毫秒级自由标点更重要,因为下游系统关心的不是事件发生在第 42.317 秒,而是它落在第几小节、第几拍。
TimeCues Studio 还允许同一个事件保存多个合理时间点。现实中的段落边界并不总有唯一答案:新段落可以从过门开始算,也可以从主旋律真正进入时开始算;一句歌词可以从吸气、辅音或元音起点开始算。项目为这种歧义提供 multi-candidate 标记,并允许将事件分为 critical 与 optional,从而避免评测系统把所有合理差异都粗暴判定为错误。
算法预测不再只是导出一份 JSON
**算法辅助标注是先由模型生成候选标签,再由人类接受、拒绝或调整结果的数据生产方式。**TimeCues Studio 内置 allin1、MSAF、ruptures 和变化点检测等基线,可以把每种算法的预测绘制成独立图层,并使用 mir_eval 对照人工标签计算 F-measure、Hit Rate 等指标。(github.com)
AutoGuess 功能会聚合多个算法的预测,将相近候选点聚成一组,再交给标注者逐个检查。这个流程比完全手工标注更现实:模型不需要一次就给出绝对正确的答案,只要能把候选范围从整首歌曲缩小到少量位置,就可能显著减少试听和点击次数。
TimeCues Studio 也提供自定义检测器入口。研究者可以把自己的 Python 检测逻辑接入工作区,让新算法与内置基线共享音频、特征缓存、参考标签和评测流程。昂贵的频谱、Chroma、MFCC 或 Demucs 分轨结果可以被多个实验复用,修改检测策略后不必每次从头计算全部特征。
这项能力让 TimeCues Studio 更接近一个实验环境,而不是纯标注软件。开发者可以查看模型在哪些段落漏检、哪些预测系统性偏移半拍,以及某种特征对特定音乐类型是否有效;这种可视化诊断通常比一张只有平均 F1 的排行榜更能指导算法迭代。
与现有工具相比,它赢在闭环
**TimeCues Studio 的核心竞争力是工作流整合,而不是取代专业音频编辑器。**Audacity 更适合录音和波形编辑,Sonic Visualiser 擅长音乐信号观察,通用标注平台适合跨模态任务,但这些工具通常不会同时管理音乐节拍网格、算法图层、团队语料与结构评测。
| 工具 | 主要定位 | 节拍锁定标注 | 多种音乐特征 | 算法预测叠加 | 内置量化评测 | 团队语料管理 | |---|---|---:|---:|---:|---:|---:| | TimeCues Studio | 音乐结构标注与算法开发 | 支持 | 支持 | 支持 | 支持 | 支持 | | Sonic Visualiser | 音乐信号分析与可视化 | 部分支持 | 支持 | 依赖插件或外部流程 | 通常依赖外部脚本 | 较弱 | | Audacity 标签轨 | 音频编辑与基础时间标注 | 较弱 | 较少 | 不支持完整实验闭环 | 不支持 | 不支持 | | 通用标注平台 | 图像、文本、音视频数据标注 | 通常不针对音乐 | 取决于配置 | 可定制 | 需自行集成 | 支持 |
TimeCues Studio 的代价同样明显。它不是数字音频工作站,不能代替 Ableton Live、Logic Pro 或 REAPER 完成复杂制作;它也不是一套训练平台,不负责大规模 GPU 训练、实验追踪和模型部署。它最合适的位置,是数据标注与算法实验之间那块长期缺工具的区域。
团队协作采用文件优先设计
**文件优先设计是把人工标签和元数据保存为普通文件,而不是锁进专有数据库中的架构选择。**TimeCues Studio 将歌曲、标注、算法输出和缓存按照清晰目录存放,人工标注主要使用 JSON,音频和可重新生成的分析缓存则分开管理。
每位标注者拥有独立目录,避免多人工作时相互覆盖。协作歌曲可以使用编辑租约控制当前操作者,交接记录则通过 Git 历史保存;人工标签属于需要备份的源数据,算法结果、BPM 检测和音乐特征属于可以重新生成的缓存。这样的数据边界对科研团队很重要,因为实验结束后最值钱的往往不是某次模型输出,而是花费数百小时制作的人工标签。(github.com)
项目提供 JSON、Audacity 标签、MIDI 等导出路径,便于将结果送往音频编辑器、音乐制作软件或下游训练管线。作者没有强迫用户采用某个封闭格式,这对需要长期维护数据集的研究团队是加分项。
TimeCues Studio 的核心部署方式也比较直接:
git clone https://github.com/sapirca/timecues-studio.git
cd timecues-studio
cp .env.example .env
docker compose up --build
首次启动后,完整服务默认运行在本地 Web 地址。项目将前端、Python 分析服务、算法工具和数据目录放进同一仓库,并提供 CPU、GPU 与实验检测器的不同部署方式。GitHub README 显示,其前端采用 React、TypeScript 与 Vite,分析侧则整合 mir_eval、MSAF、ruptures、Demucs 等现有音乐信息检索组件。(github.com)
实验功能很丰富,但别把所有检测器都当成成熟产品
**TimeCues Studio 的实验检测器是按功能族启用的可选组件,不代表所有模型都已达到稳定生产标准。**项目当前还提供 BeatNet 节拍与拍号追踪、Basic Pitch 多音符转录、Silero VAD、JDCNet 歌声检测、PANNs 音频事件分类、Whisper 歌词转录和 LoCoMotif 动机发现等扩展能力。
官方文档明确提醒,实验功能可能产生错误结果、加载失败、改变 JSON 结构,甚至在后续版本中被移除。完整实验环境首次安装还可能拉取约 3GB Python 依赖,部分模型会额外下载权重,因此它虽然可以一条 Docker 命令启动核心服务,但真正把全部检测器跑起来,仍然需要一定的机器资源和运维能力。(github.com)
这个限制并不是坏事,反而说明项目没有把算法预测包装成绝对可靠的自动标注。音乐结构本身存在主观性,跨流派泛化也很困难;在电子舞曲上有效的 Drop 检测方法,换到古典音乐、爵士即兴或无固定节拍的现场录音中,表现可能迅速下降。
真正的价值是缩短数据闭环
**TimeCues Studio 最有价值的用户不是普通听歌用户,而是需要反复生产、检查和利用音乐时间标签的开发团队。**音乐理解模型研究者可以用它制作结构分段数据集,生成式视频团队可以标记镜头切换和节奏事件,舞蹈生成团队可以建立动作与拍点对齐数据,舞台系统开发者也可以把灯光、字幕和视觉效果绑定到歌曲结构上。
这类任务过去最大的问题往往不是缺模型,而是缺少稳定的数据闭环。一个模型即使能在公开数据集上获得不错分数,也不代表它适合团队自己的音乐类型;团队必须标注一批真实歌曲、运行模型、检查误差、修正标签,再决定是否继续训练或替换算法。TimeCues Studio 把这条链路压缩进一个界面,价值比单独增加一个分段模型更实际。
TimeCues Studio 当前仍是一个早期项目,其代码仓库和社区规模尚小,界面、权限管理、任务分配和大规模部署能力也需要更多真实团队验证。它现在更像一套研究原型与可用工具之间的产品,而不是已经打磨成熟的企业标注平台。
但这次开源仍然值得音乐 AI 开发者关注。它证明音乐标注工具不必停留在波形上画线,也可以把节拍、分轨、特征、多人协作、算法建议和评测指标组成一个持续迭代的工作台。对于正在做音乐理解、音画同步或节奏驱动生成的团队,TimeCues Studio 至少提供了一套可以直接修改的起点,而不是再从几个零散脚本开始搭流水线。
参考来源
- TimeCues Studio GitHub 仓库:项目代码、MIT 许可证、部署方式、目录结构与功能说明。
- 作者在 Reddit r/MachineLearning 的发布帖:作者对项目应用场景、核心功能和 ACM Multimedia 2026 研究背景的介绍。