BiRefNet-lite真跑进手机NPU了
开发者重写BiRefNet-lite计算图,用双分辨率架构和INT8量化绕开手机NPU限制,在Galaxy S26上实现1024px抠图仅需23.7毫秒。
BiRefNet-lite真跑进手机NPU了:1024px抠图只要23.7毫秒
一名独立开发者把原本无法在手机NPU上编译的BiRefNet-lite,改造成了一个全INT8、全程不回退CPU的端侧抠图模型:在搭载骁龙8 Elite Gen 5的Galaxy S26上,生成一张1024×1024主体蒙版只需23.7毫秒。
这项工作于2026年11月15日公开,项目名为Lumen Cutout,代码、模型权重以及面向42款骁龙芯片预编译的文件均已开放。按照作者公布的数据,整个模型包含2060个计算层,所有层都运行在NPU上,没有常见的CPU兜底,也没有把后处理藏到GPU里。(reddit.com)
BiRefNet是一个面向高分辨率二值图像分割的开源模型,目标是把图像中的主体与背景精确分开。 它尤其擅长头发、树枝、车轮辐条和半透明边缘等传统分割模型容易处理失误的区域,官方仓库还提供了通用分割、抠图、显著目标检测和2K输入等不同权重。(github.com)
但高精度并不等于容易部署。BiRefNet-lite虽然已经是轻量版本,直接塞进手机NPU仍会撞上一连串硬件和编译器限制:不支持的算子、维度过高的张量、片上内存不够,以及量化后精度下降。
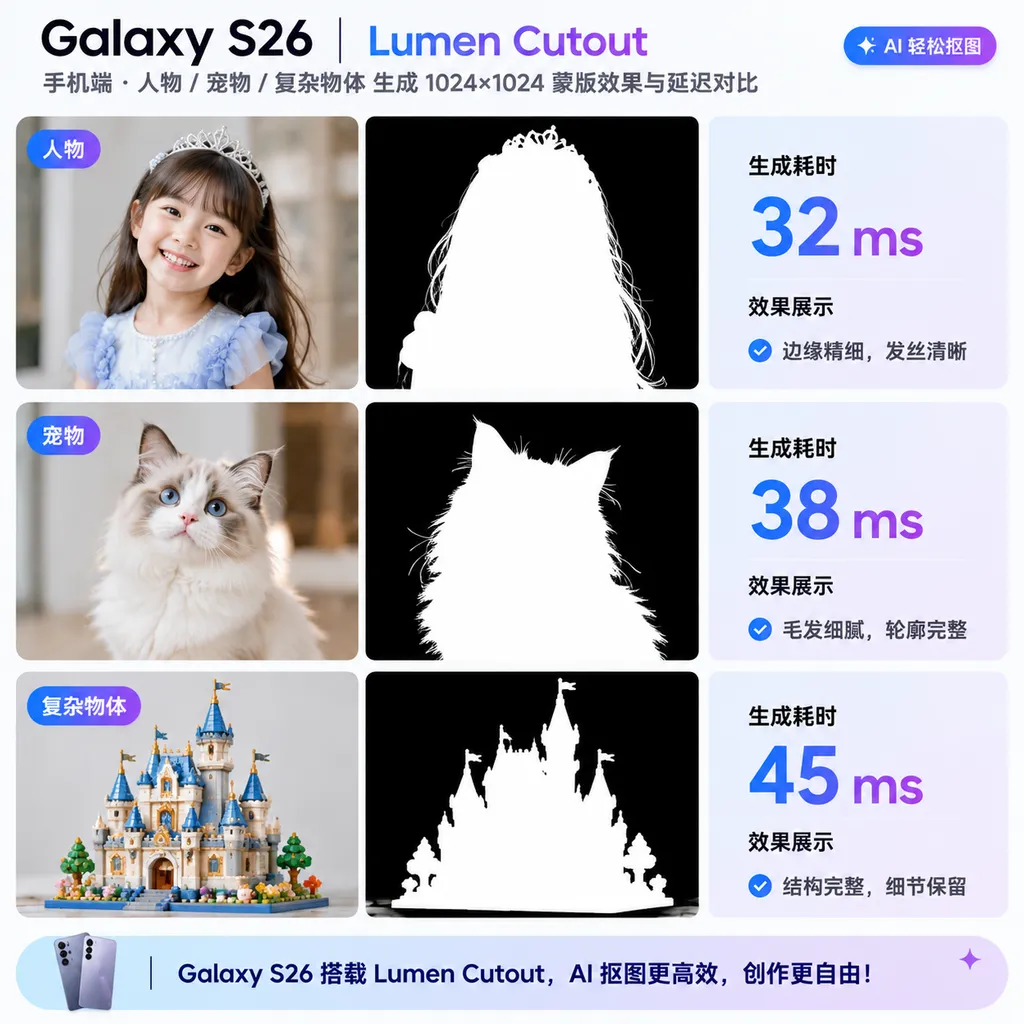
23.7毫秒意味着什么
NPU是专门加速神经网络矩阵运算和卷积运算的处理器单元,优势是功耗更低,但支持的计算图通常比GPU严格得多。 桌面GPU遇到陌生算子时还能依靠通用计算能力强行执行,手机NPU更像一条高度自动化的工厂流水线:只要零件尺寸、搬运顺序或加工动作不在设备支持范围内,整条生产线就无法启动。
Lumen Cutout公布的端侧成绩如下:
| 设备 | 芯片 | 1024×1024蒙版延迟 | 理论吞吐量 | 峰值内存 | |---|---|---:|---:|---:| | Samsung Galaxy S26 | Snapdragon 8 Elite Gen 5 | 23.7 ms | 约42.2 FPS | 299 MB | | Samsung Galaxy S25 | Snapdragon 8 Elite | 31.1 ms | 约32.2 FPS | 293 MB | | Snapdragon 7 Gen 4 QRD | Snapdragon 7 Gen 4 | 73.8 ms | 约13.6 FPS | 286 MB | | Samsung Galaxy S21 | Snapdragon 888 | 106.8 ms | 约9.4 FPS | 286 MB | | Motorola Edge 50 | Snapdragon 7 Gen 1 | 182 ms | 约5.5 FPS | 未披露 | | Samsung Galaxy A73 5G | Snapdragon 778G | 188.7 ms | 约5.3 FPS | 474 MB |
数据来自项目模型卡,测试方式为LiteRT调用NPU;Motorola Edge 50在实际Lumen应用中的延迟约为190毫秒。(huggingface.co)
23.7毫秒已经不是“用户愿意等待”的速度,而是接近交互界面即时响应的速度。用户在相册中长按人物或物体时,模型可以在手指抬起前完成主体蒙版生成,随后直接进入复制、分享、贴纸生成或背景替换流程。
骁龙8 Elite Gen 5相较上一代平台,把同一任务的延迟从31.1毫秒降至23.7毫秒,降幅约23.8%。更值得注意的是中端芯片的结果:骁龙7 Gen 1虽然需要182毫秒,但仍然足以支持单张照片的离线抠图,而且所有图像数据不必离开设备。
原版为什么无法直接部署
算子限制是指模型使用的数学操作没有对应的NPU实现,因此编译器无法把它转换为设备可执行指令。 原版BiRefNet-lite的问题不是某一个算子不兼容,而是编码器、解码器和注意力模块同时踩中了移动端部署的多个雷区。
第一个问题是20个可变形卷积。
可变形卷积是一种允许卷积采样点根据图像内容动态偏移的卷积结构。 普通卷积像拿着固定九宫格扫描图像,可变形卷积则会让九宫格发生弯曲,主动贴合人物轮廓、树枝和衣物边缘,因此更适合处理不规则目标。
问题在于,这种动态采样通常依赖偏移量计算和grid_sample一类操作,而很多手机NPU只擅长规则卷积。即使框架可以导出模型,编译器也可能把这些层扔回CPU,最终出现“看似调用NPU,实际大半时间耗在CPU”的情况。
第二个问题是Swin Transformer中的高维张量。
Swin Transformer是一种把图像切成局部窗口进行注意力计算的视觉骨干网络。 PyTorch实现为了方便表达批次、窗口、宽度、高度、注意力头和通道,可能产生五维或六维张量,但目标NPU只接受最高四维张量。
第三个问题是移位窗口中的循环滚动。
Swin会在相邻层移动窗口位置,让不同窗口之间交换信息,常见实现直接使用torch.roll做循环位移。这个操作对GPU并不复杂,但对部分NPU编译器来说既不自然,也很难与前后算子融合。
第四个问题是1024px特征图塞不进片上内存。
分辨率从512×512提升到1024×1024,像素数量不是增加一倍,而是增加到四倍。中间激活值、残差连接和多尺度特征也会同步膨胀。项目作者测试发现,原版BiRefNet-lite在同一批手机上以1024px运行会直接内存不足;即使降到512px,也会回退CPU,在Galaxy S26上需要677毫秒。(reddit.com)
这个对比不能简单理解为23.7毫秒比677毫秒快28.6倍,因为两者输入分辨率和执行路径不同,但它揭示了端侧部署最现实的问题:模型在论文里有多快并不重要,只有编译器真正接受整张计算图,性能才有意义。
第一层改造:只换写法,不换数学结果
计算图重写是指在保持数学结果不变的前提下,用硬件支持的算子组合替换原有表达方式。 这一步相当于把同一道数学题改写成NPU编译器能看懂的格式,而不是重新设计模型。
Lumen Cutout首先把Swin的窗口划分改成全程四维张量,避免五维和六维中间表示。窗口仍然包含相同像素,注意力的数学含义没有变化,但张量形状不再突破NPU限制。
移位窗口则不再使用循环滚动,而是通过填充、对齐窗口和固定掩码实现。固定掩码会阻止原本不该相互注意的区域交换信息,从结果上复现torch.roll之后的窗口关系。
大卷积被拆成沿通道分组执行的小卷积,注意力也改为一次处理一个头。这样做不会减少总计算量,却能显著降低单个算子的峰值内存,类似于不再一次把整张餐桌搬进门,而是拆掉桌腿后分批搬运。
这些重写最大的价值是可验证。项目代码会对比重写前后的输出,确认差异在可接受的数值误差范围内,然后再进入LiteRT转换和芯片编译流程。(github.com)
第二层改造:承认硬件限制,重新分配分辨率
双分辨率架构是指让模型的语义理解部分处理较低分辨率图像,同时让最终蒙版分支保持高分辨率。 Lumen Cutout没有坚持让整个骨干网络吃下1024×1024图像,而是给模型同时输入1024×1024和640×640两个版本。
640px输入交给Swin骨干网络,负责回答“主体在哪里、它大致是什么形状”;1024px输入则进入精简后的全分辨率尾部,负责恢复边缘和输出最终蒙版。
这种设计抓住了抠图任务的计算特点。主体识别并不需要每个语义层都保留1024px细节,一只猫缩小到640px后仍然是猫;但胡须、毛发和耳朵边缘需要在输出阶段回到1024px,否则放大蒙版时会出现锯齿和粘连。
作者还用普通卷积替换了可变形卷积,将全分辨率尾部压瘦,并在Swin第四阶段只使用一个全局窗口。这些修改会改变原始模型的函数,不再属于“等价改写”,因此不能靠输出对齐直接继承精度,而必须重新训练。
最终模型包含两个INT8输入和一个INT8输出:一个1024×1024 RGB图像、一个640×640 RGB图像,以及一个1024×1024单通道蒙版。模型文件约61 MB,权重和激活值均为8位整数。(huggingface.co)
第三层改造:让量化误差参与训练
INT8量化是把通常使用16位或32位浮点数表示的权重与激活值,压缩为8位整数。 它能减少内存、带宽和乘加成本,但也会把连续数值压进有限的256个整数档位,细微边缘最容易因此损失。
知识蒸馏是让较小或受限的学生模型模仿高精度教师模型输出的训练方法。 Lumen Cutout以原始FP32 BiRefNet-lite作为教师模型,先进行浮点蒸馏,再让学生模型穿过与真实NPU计算方式一致的伪量化计算图继续训练。
量化感知训练,简称QAT,是在训练过程中模拟量化舍入和截断误差的方法。 与训练结束后再进行量化相比,QAT让模型提前适应“只能使用256个数值档位”的现实,并主动调整权重分布来减少误差。
这个项目最有价值的经验并不是QAT本身,而是作者发现了一次几乎无法从最终损失中观察到的失败:最深层解码分支的Sigmoid门控值饱和到约10⁻¹¹,等于整条分支被关闭。
学生模型的最终蒙版损失并没有明显恶化,因为其他解码分支补偿了输出;但教师模型对应门控约为0.46,说明这条分支原本承担了有效的信息传递。作者最终从教师模型恢复该分支,并加入特征损失,强制它在蒸馏过程中保持工作状态。(reddit.com)
这也是一个值得端侧开发者记住的结论:模型输出看起来正常,不代表内部结构仍在按预期工作。蒸馏、剪枝和量化可能制造“僵尸分支”,最终指标暂时不掉,但模型的泛化能力和复杂场景表现已经被掏空。
精度没有明显掉,但边缘确实更软
S-measure是一种同时衡量分割结果区域结构和目标结构一致性的指标,数值越接近1通常越好。 在教师模型和学生模型都没有训练过的ECSSD与DUT-OMRON测试集上,INT8模型的S-measure分别为0.939和0.830,FP32教师模型分别为0.938和0.826。
| 模型 | ECSSD S-measure | DUT-OMRON S-measure | 运行方式 | |---|---:|---:|---| | Lumen Cutout INT8 | 0.939 | 0.830 | 手机NPU,全INT8 | | 原版BiRefNet-lite教师模型 | 0.938 | 0.826 | FP32 | | Apple Vision前景蒙版 | 0.940 | 0.842 | 平台能力 | | ML Kit主体分割 | 0.928 | 0.789 | 平台能力 | | U²-Net | 0.928 | 0.848 | 公开模型 |
这些数字说明量化后的学生模型基本保住了教师模型的区域分割能力,但不能据此宣布它全面超过原版。作者明确指出,INT8输出的边缘略软,在DIS-VD的电线、围栏和细树枝等精细结构上,S-measure比教师模型低0.017;在DUT-OMRON上也有六个公开模型的得分更高。(huggingface.co)
另一个限制是测试集图像大多只有约400px宽,无法充分证明1024px蒙版的价值。高分辨率输出真正应该解决的是手机原图中的发丝、商品透明边缘和复杂孔洞,但这些场景还需要更针对性的高分辨率测试集和主观评测。
真正值得关注的是“全图上NPU”
AOT编译是指在应用运行前,提前把模型转换成某款芯片专用的可执行图。 Lumen Cutout使用GitHub Actions为42款骁龙芯片分别执行编译,每个芯片得到独立文件,整个模型被编译成一个NPU分区。
一个NPU分区意味着推理期间不需要频繁在CPU、GPU和NPU之间搬运张量。异构处理器切换不仅有调度开销,还会引入内存复制、缓存失效和额外功耗;模型里只要有几个不支持的算子,就可能让理论上的NPU优势被数据搬运抵消。
这套方案的代价是部署包管理更复杂。编译后的文件只能运行在对应芯片上,应用必须识别SoC型号,再加载正确的模型文件。项目目前也不支持MediaTek和Google Tensor,部分旧骁龙芯片只能走CPU。
但对有明确Android设备范围的产品来说,这种交换通常值得。相册、桌面贴纸、电商拍摄、证件照、社交应用和离线文档扫描,都可以把高质量主体分割变成不依赖网络的基础能力。
这不是新模型,而是一份端侧工程答案
Lumen Cutout最重要的意义不是把BiRefNet-lite的榜单成绩再提高一点,而是展示了如何把一个“算法上轻量、硬件上不友好”的视觉模型,真正压进消费级手机NPU。
它没有押注某个神奇算子,也没有依赖尚未普及的新运行时,而是使用了四种很朴素的工程手段:等价计算图重写、语义与细节分辨率拆分、面向真实NPU数值行为的QAT蒸馏,以及逐芯片AOT编译。
这套方法比单纯做通道剪枝更有参考价值。移动端部署的瓶颈经常不是FLOPs总量,而是单层峰值内存、张量维度、算子覆盖率和计算图能否形成连续分区。一个计算量更低但频繁回退CPU的模型,实际速度可能远慢于一个计算量稍高、却能完整驻留NPU的模型。
当然,目前23.7毫秒仍是项目作者公布的结果,而不是经过大规模第三方设备复测的行业基准。项目刚刚公开,GitHub仓库的社区验证、不同系统版本兼容性、连续运行功耗和温升数据都还不充分;作者也明确表示尚未测量功耗。
但从已公开的代码、模型文件、编译工作流和测试限制来看,这不是一次只展示数字、不交付实现的演示。对于正在做Android端侧视觉应用的开发者,它更像是一份可拆解的工程样板:当模型无法部署时,答案不一定是换掉模型,也可能是把模型的数学表达、分辨率预算和训练过程一起改造成硬件真正能执行的形状。
参考来源
- Reddit:BiRefNet-lite在手机NPU实现1024px、23.7毫秒推理:作者发布的项目说明、测试结果、精度限制及蒸馏经验。
- GitHub:Lumen Cutout项目仓库:包含计算图重写、量化、训练与42款骁龙芯片的编译工作流。
- Hugging Face:Lumen Cutout模型卡:提供模型权重、INT8文件、设备性能数据、评测结果与输入输出格式。
- GitHub:BiRefNet官方仓库:BiRefNet原始代码、模型架构、模型动物园和ONNX资源。
- Hugging Face:BiRefNet官方模型:BiRefNet权重、模型说明及高分辨率图像分割背景资料。