华为云开源机器人的“脑内沙盘”
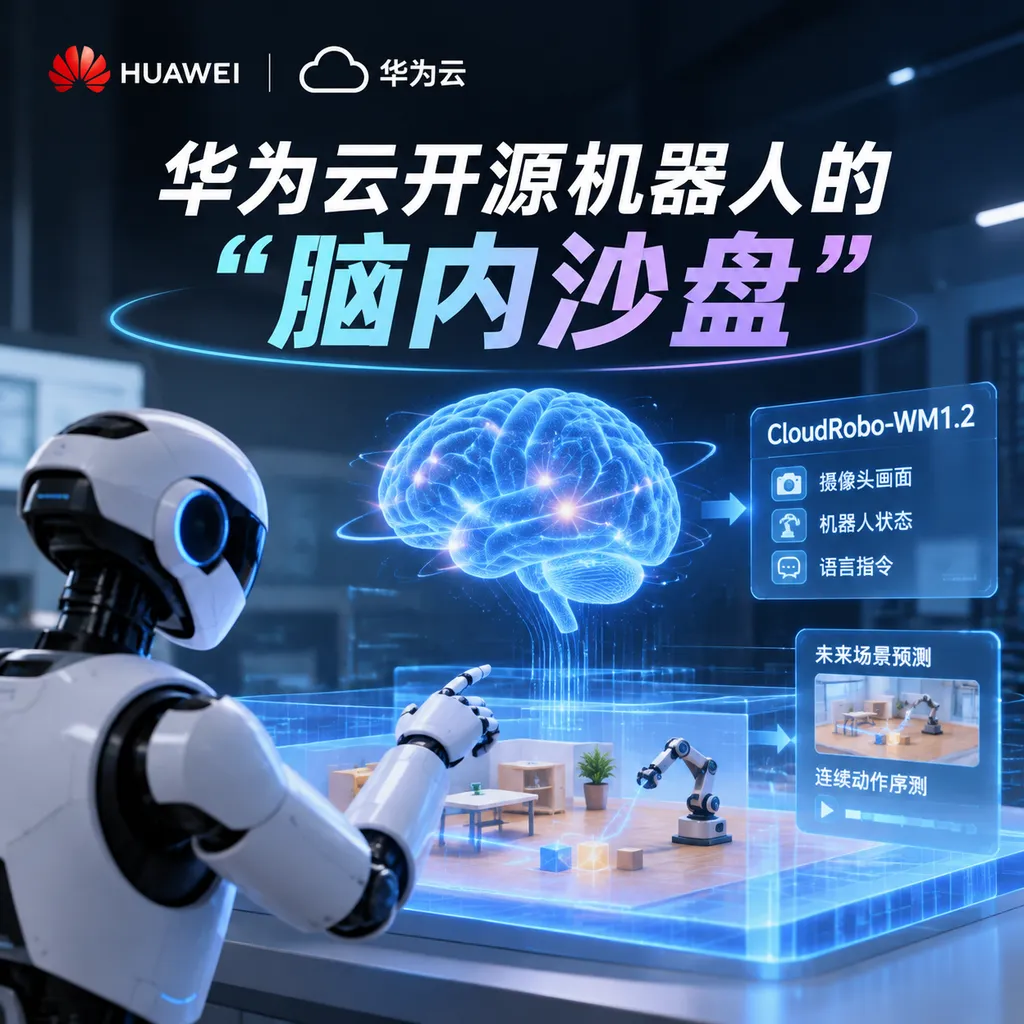
华为云正式发布并开源昇腾原生具身世界模型 CloudRobo-WM1.2,将环境预测、世界表征和动作生成放进同一套模型,并开放训练框架与昇腾适配实践。
华为云开源机器人的“脑内沙盘”:CloudRobo-WM1.2 把预测与动作生成合为一体
华为云在 11 月 16 日正式发布并开源 CloudRobo-WM1.2,这是一款面向机器人操作任务、基于昇腾算力训练的具身世界模型。它试图解决具身智能当前最棘手的工程问题:机器人不仅要看懂眼前发生了什么,还要预测下一刻会发生什么,并把预测结果直接转化为可执行的动作。
具身世界模型是让机器人在内部模拟物理世界变化,并据此规划动作的模型。 如果把视觉语言模型理解为机器人的“观察和理解系统”,世界模型更像一座实时运行的“脑内沙盘”:机械臂准备抓取玻璃杯时,模型会先推演杯子是否会滑动、夹爪应该从哪个角度接近,以及动作执行后画面和物体状态如何变化。
华为云表示,CloudRobo-WM1.2 在 RoboTwin 2.0 和 LiberoPro 2.0 两个评测基准中均排名第一,但发布信息暂未披露具体成功率、推理延迟和不同机器人本体上的分项成绩。对开发者而言,“第一”是一个值得关注的信号,却还不是足够完整的采购或技术选型依据。(ithome.com)
这次发布的重点不是更大的机器人模型
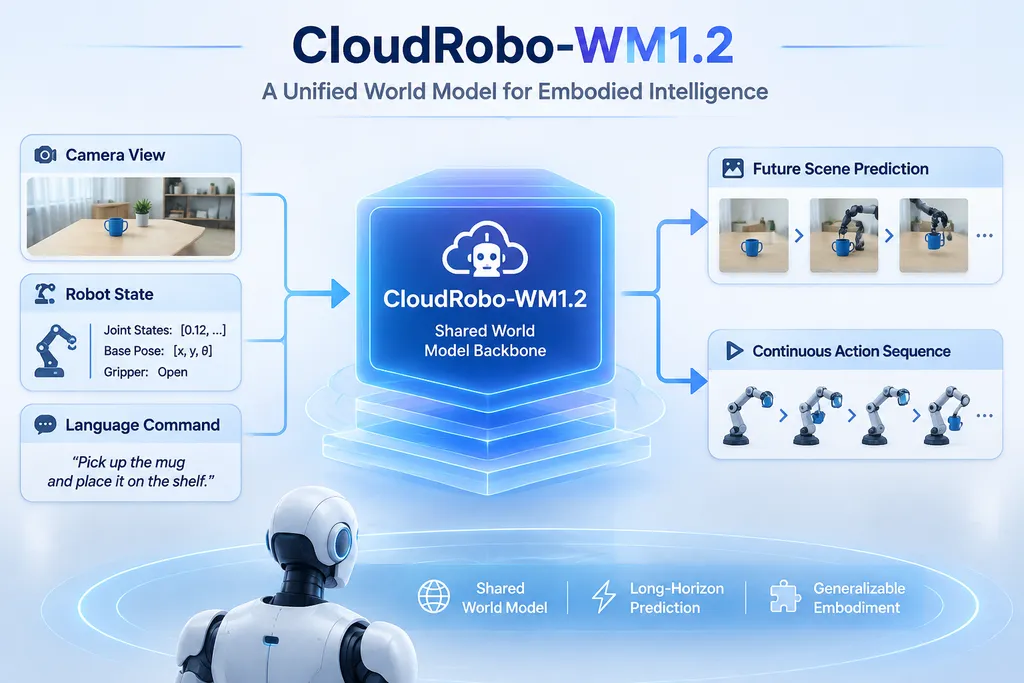
CloudRobo-WM1.2 的核心变化,是把预测、表征和动作生成从相互独立的模块,收进一套共享世界模型骨干网络。 传统机器人系统通常采用流水线结构:视觉模型识别物体,语言模型理解任务,规划模块决定路径,控制策略生成关节动作。每个模块单独看都能工作,但信息在模块间传递时容易损失,错误也会逐级放大。
例如,视觉模块可能正确识别出桌上有一个杯子,却没有编码杯子的重心、材质和滑动趋势;动作模型收到的只是“抓杯子”以及若干视觉特征,很难判断应该使用多大力度。世界模型的价值就在这里:它不只提取画面特征,还要学习动作与未来状态之间的因果关系。
世界动作模型(World-Action Model,WAM)是同时建模未来世界状态与机器人动作序列的模型。 CloudRobo-WM1.2 不再把视频预测当作一个独立的辅助任务,而是让环境预测直接参与动作生成。模型既要回答“这个动作执行后会看到什么”,也要回答“为了得到目标结果应该执行什么动作”。
这种统一架构并不意味着机器人的伺服控制器、安全系统和底层驱动可以被大模型取代。世界模型主要负责较高层的感知、预测和动作策略,碰撞保护、急停、实时力控等安全关键环节仍需运行在确定性的控制系统中。真正能够进入工厂的具身模型,必须学会与现有控制栈协同,而不是把所有问题都塞进 Transformer。
五项技术,分别对应五个落地难题
CloudRobo-WM1.2 的五项创新,基本覆盖了世界模型从数据训练到跨本体部署的完整链条。 华为云公布的技术包括 PPA 多模态世界表征架构、DualAct 动作架构、多粒度监督预训练、跨具身运动建模,以及四种弹性推理模式。(ithome.com)
| 技术 | 主要解决的问题 | 对开发者的实际价值 | |---|---|---| | PPA 多模态世界表征架构 | 视觉、语义、空间与物理状态难以统一 | 减少多个感知模型之间的信息损失 | | 世界模型原生 DualAct 架构 | 世界预测与动作生成相互割裂 | 让预测结果直接参与连续动作生成 | | 多粒度监督数据自适应预训练 | 机器人数据质量、标注粒度不一致 | 同时利用视频、状态、轨迹和动作数据 | | 本体语义保真跨具身运动建模 | 不同机械臂关节数和运动空间不同 | 降低模型迁移到新机器人本体的成本 | | 四种弹性推理模式 | 精度、延迟和算力需求无法兼顾 | 按任务复杂度选择完整或精简推理链路 |
PPA 多模态世界表征架构是 CloudRobo-WM1.2 用于统一感知、预测和动作信息的表征机制。 它的目标不是简单地把 RGB 图像、深度信息、语言指令和关节状态拼接在一起,而是在共享骨干网络中学习能够预测未来变化的特征。只有当表征包含物体位置、几何结构和运动趋势时,动作生成才不会退化成对训练轨迹的机械模仿。
DualAct 是华为云提出的世界模型原生动作生成架构。 从发布信息看,这套架构强调动作分支不是后期外挂的策略头,而是世界模型本身的一部分。它更接近“边想象边行动”:模型预测未来画面的同时生成动作,并利用两类输出之间的一致性约束训练过程。
多粒度监督数据自适应预训练,是让不同来源和不同标注完整度的数据进入同一训练体系。 具身智能数据通常包含视频、语言描述、机器人状态、末端位姿、关节角和动作轨迹,但现实中很少有数据集同时拥有全部字段。如果模型只能使用完整标注数据,训练规模会被昂贵的真机采集成本锁死。
本体语义保真跨具身运动建模,是让模型在迁移机器人本体时保留动作的任务语义。 两台机械臂可能拥有不同关节数量、不同工作空间和不同控制频率,但“拿起杯子并放到托盘里”的任务语义并没有变化。跨本体建模要做的,是把高层动作意图与具体关节控制分开,再针对目标硬件完成映射。
弹性推理模式是 CloudRobo-WM1.2 面向真实部署成本作出的工程取舍。 华为云公布了 World、Expert Action、Joint 和 Action-only 等可组合方式,意味着开发者可以在完整世界预测与更直接的动作生成之间选择。精细操作可以使用联合推理,简单且高频的重复任务则可减少预测分支计算,以降低延迟和算力占用。
它和常见 VLA 模型有什么不同
视觉语言动作模型(Vision-Language-Action,VLA)是把视觉观察和语言指令映射为机器人动作的模型。 VLA 的优点是链路直接,输入画面和任务描述后即可输出动作;缺点是许多 VLA 更擅长学习“看到这种场景时应该怎么做”,却不一定显式预测“做完以后世界会怎样变化”。
| 路线 | 主要输入 | 主要输出 | 优势 | 局限 | |---|---|---|---|---| | 传统模块化策略 | 感知结果、规则和状态 | 规划路径或控制指令 | 可解释、容易设置安全边界 | 泛化能力弱,模块误差会累积 | | VLA 模型 | 图像、语言、机器人状态 | 动作序列 | 端到端、训练和推理链路较短 | 对物理后果的显式预测通常较弱 | | 纯世界模型 | 当前状态和动作假设 | 未来画面或未来状态 | 适合仿真、规划和数据生成 | 仍需额外策略模块生成动作 | | CloudRobo-WM1.2 类 WAM | 图像、语言、状态与历史动作 | 未来世界状态和动作序列 | 预测与行动统一,可共享世界知识 | 训练复杂,对数据与算力要求更高 |
CloudRobo-WM1.2 的竞争力不在于完全取代 VLA,而在于把世界预测变成动作策略的内生能力。 对于拿取、搬运和放置等短时任务,成熟 VLA 已经能够取得较高成功率;但在遮挡、接触、物体滑动和连续多步骤操作中,机器人需要不断根据动作后果重新规划,世界模型的价值会更明显。
这种差异可以类比自动驾驶。只根据当前摄像头画面输出方向盘角度,相当于端到端动作策略;同时预测其他车辆未来轨迹、道路占用变化和自身动作后果,则更接近世界模型。后者计算量更大,却更适合复杂环境和长任务链。
公开结果不错,但不能直接等同于 WM1.2 成绩
目前公开生态中已经出现 CloudRobo-WM 的代码适配、评测记录和模型权重,但版本信息仍然比较分散。 XPolicyLab 的 CloudRobo-WM 适配页面显示,该模型面向 RoboTwin 2.0、arx_x5 双臂机器人和 Joint14 状态,使用三路 RGB 摄像头输入,并提供推理与昇腾后训练实现。(github.com)
该页面公布的历史评测覆盖 50 个任务,每个配置执行 100 次测试:Clean/seen 设置成功率为 95.28%,Random/unseen 设置成功率为 82.68%,两类配置等权平均为 88.98%。评测使用 BF16 权重、4 步去噪和每 32 个动作重新规划一次。(github.com)
这些数字不能直接当作 CloudRobo-WM1.2 的正式成绩。 公开权重在 Hugging Face 上标记为 CloudRobo-WM-1.0-RoboTwin-20261111,主权重文件约为 14.1GB;华为云平台此前披露的 CloudRobo-WM-7B-Preview 则是 70 亿参数版本。版本名称、后训练数据和评测配置存在差异,发布会所说的 RoboTwin 2.0 与 LiberoPro 2.0 双榜第一,仍需配套技术报告给出完整分数和对照组。(huggingface.co)
“开源”已经宣布,完整度还需要观察
华为云此次开放的不只是模型,还包括训练框架和 WAM 昇腾算力最佳实践。 这比只放出推理权重更有价值,因为具身模型的困难往往不在模型下载,而在数据预处理、视频解码、多模态对齐、分布式训练、仿真评测和真机部署的整条工具链。(ithome.com)
截至 11 月 16 日发稿时,公开资产仍处于逐步落地状态。 CloudRobo-WM 的 GitHub 原始仓库已经提供技术报告,但 README 仍写着代码、数据和模型将陆续开放;另一方面,XPolicyLab 适配代码和 Hugging Face 权重已经可以访问。换句话说,华为云完成了发布与开放入口的搭建,但开发者能否低成本复现 WM1.2 的完整训练和双基准成绩,还要看后续代码、数据清单与环境文档的完善速度。(github.com)
这也是判断一次具身模型开源是否有含金量的关键:模型权重只是起点,数据格式、训练脚本、评测环境、硬件算子和机器人接口必须能够闭环。对于需要接入真实机械臂的团队,缺少任何一环,都可能意味着数周甚至数月的额外工程工作。
昇腾原生,比跑在昇腾上更重要
昇腾原生意味着模型从训练、算子优化到推理部署都围绕昇腾软硬件栈设计,而不是训练完成后再进行平台迁移。 对华为云而言,这款模型同时承担产品和生态任务:它既要证明昇腾可以支撑视频生成式世界模型的大规模训练,也要给机器人厂商提供一套可复制的开发路径。
华为云披露,已有 80% 的中国具身智能企业选择昇腾云,重点高校基本实现覆盖。这个数字来自华为云自身,缺少第三方市场报告的口径说明,但它反映出华为并不打算亲自制造所有机器人,而是希望成为模型训练、数据生产、仿真验证和云边协同部署的基础设施供应商。(ithome.com)
华为云不做机器人本体的策略,让 CloudRobo-WM1.2 必须具备更强的跨本体能力。 如果模型只能服务某一种双臂机器人,它更像一个垂直项目;如果它能以较低成本迁移到工业机械臂、轮式机器人、巡检设备和人形机器人,它才可能成为平台级基础模型。
真正的考验是从榜单走向工位
CloudRobo-WM1.2 是国内具身智能从 VLA 竞赛转向世界动作模型的一次明确信号。 模型团队开始意识到,机器人不能只学习动作与画面的相关性,还必须学习物理世界的变化规律,以及动作对未来状态产生的影响。
这款模型目前最值得肯定的地方,是它没有把世界预测停留在视频生成演示上。 DualAct、跨本体建模和弹性推理都指向真实机器人操作,而训练框架与昇腾实践的同步开放,也比单纯发布一组跑分更有长期价值。
这款模型目前最大的未知数,是缺少可交叉验证的 WM1.2 详细成绩。 RoboTwin 2.0 和 LiberoPro 2.0 排名第一需要完整评测表支撑,跨本体能力需要在不同硬件上测试,弹性推理也需要公开延迟、显存占用和成功率之间的权衡曲线。
如果华为云后续能够补齐完整代码、数据配方、评测日志和多本体部署案例,CloudRobo-WM1.2 有机会成为昇腾生态中一个真正可用的具身模型底座;如果开放内容长期停留在权重和技术报告层面,它的影响力仍会主要局限在发布会和榜单。
参考来源
- IT之家:华为云发布并开源昇腾原生具身世界模型 CloudRobo-WM1.2 — 发布信息、五项技术创新、评测排名与生态数据。
- GitHub:CloudRobo-WM 技术报告与项目入口 — CloudRobo-WM 架构说明及技术报告,目前标注代码与数据将陆续开放。
- GitHub:XPolicyLab 的 CloudRobo-WM 适配实现 — RoboTwin 2.0 适配、训练评测流程及公开成功率。
- Hugging Face:CloudRobo-WM-1.0-RoboTwin-20261111 — 已公开模型资产与 BF16 权重文件。