十三年前的PS4跑起9B大模型
开源项目 Garlic LLM 让越狱 PS4 离线运行 Qwen3.5-9B,文本生成速度达 31—39 Token/s,代码场景最高 43 Token/s。真正值得关注的不是“游戏机跑 AI”的噱头,而是开发者对旧 GPU、量化和推测解码的极限压榨。
十三年前的 PS4,跑起了 9B 大模型
一台 2013 年发布的 PlayStation 4,如今可以在不连接电脑、不访问互联网的情况下,本地运行一个 90 亿参数的大语言模型。
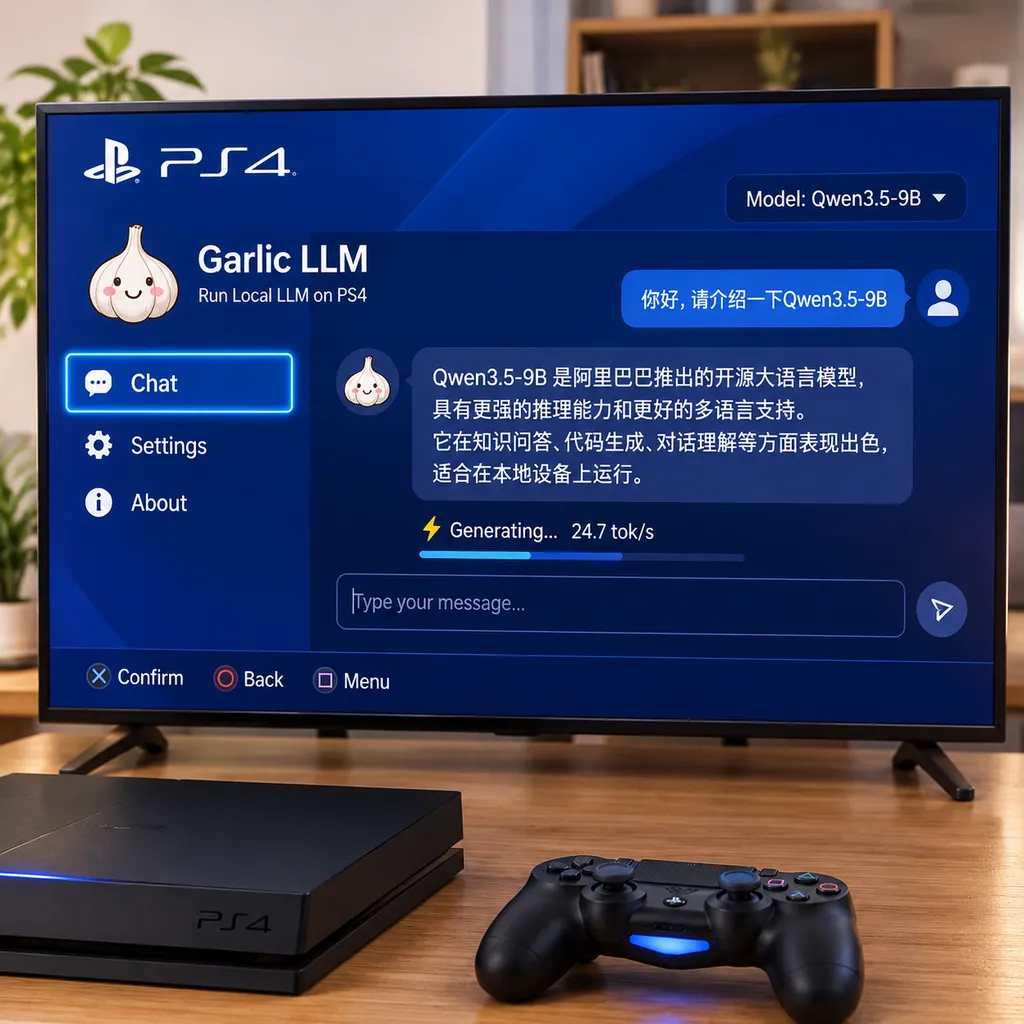
11 月 17 日,开发者 Leonardo Alegría 的开源项目 Garlic LLM 引发关注。这个项目让安装 GoldHEN 的 PS4 直接在主机 GPU 上运行阿里巴巴的 Qwen3.5-9B:普通文本生成速度为每秒 31—39 个 Token,生成代码时最高达到每秒 43 个 Token,并提供 16K 上下文、语音识别、语音合成、思考模式和 MicroPython 代码执行能力。(github.com)
**Garlic LLM 是一个面向 PS4 自制软件环境的本地大模型推理应用。**它不是把 PS4 当作显示终端,也不是让另一台电脑在后台运行模型,而是把模型权重、注意力缓存和计算内核真正塞进 PS4 的统一内存,并由主机自己的 AMD GCN GPU 完成推理。
43 Token/s,已经不是“能运行”那么简单
**Garlic LLM 的实际价值在于,它把一次硬件极客实验做到了接近可交互产品的速度。**根据项目公布的数据,基础版和 Slim 版 PS4 的文本生成速度为 31—39 Token/s,代码生成峰值为 43 Token/s;按 35 Token/s 计算,一段 300 Token 左右的回答不到 9 秒即可生成完毕。
Token 是大语言模型读取和生成文本时使用的基本单位,一个 Token 可能是一个汉字、一个单词,也可能只是单词的一部分。对于本地聊天而言,10 Token/s 已经可以使用,20 Token/s 通常能够获得比较连贯的阅读体验,而 30 Token/s 以上基本不会让用户产生明显的“等字”感。
这意味着 Garlic LLM 并不是一个只能截图展示的技术样品。它的生成速度已经足以支撑日常问答、短文本处理和代码补全,甚至比不少使用 CPU 或低功耗核显运行 7B—9B 模型的普通电脑更快。
| 项目 | Garlic LLM 实测表现 | |---|---:| | 运行模型 | Qwen3.5-9B | | 模型参数量 | 90 亿 | | 普通文本速度 | 31—39 Token/s | | 代码生成峰值 | 43 Token/s | | 语音模式文本速度 | 约 22 Token/s | | 上下文窗口 | 16K Token | | 模型权重量化 | 自定义 Q4、Q3 | | Qwen3.5-9B 权重文件 | 4.32 GiB | | 完整安装包 | 5.66 GB | | 联网要求 | 运行时无需联网 |
**这里需要区分稳定测试成绩和额外硬件报告。**31—39 Token/s 和代码峰值 43 Token/s 是基础版或 Slim 版 PS4 上测得的主要数据;GitHub 页面同时记录了 PS4 Pro 用户在部分固件环境下取得 25—45 Token/s 的反馈,但开发者并未把它作为统一、可复现的官方基准。(github.com)
真正困难的不是模型,而是没有驱动
**Garlic LLM 最核心的技术工作,是绕过传统 GPU 计算软件栈,直接控制 PS4 的 GCN GPU。**PS4 使用 AMD Jaguar CPU 和 GCN 架构 GPU,但索尼没有为自制软件开放类似 CUDA、ROCm 或通用 OpenCL Runtime 的机器学习计算环境。
正常情况下,开发者调用 PyTorch、llama.cpp 或 vLLM,框架会把矩阵乘法等操作交给驱动,再由驱动生成 GPU 能够执行的命令。PS4 自制软件没有这条现成通道,因此 Garlic LLM 必须自己承担一部分驱动工作。
项目使用 OpenCL C 编写矩阵乘法、注意力和归一化等计算内核,再通过 LLVM 将其编译为适配 PS4 GCN 架构的程序。应用还会自行构建 PM4 Command Buffer,直接向 GPU 提交底层命令。
**PM4 Command Buffer 是 AMD GPU 用来描述计算任务和资源调度的一组底层命令。**通俗地说,普通 AI 框架像是把目的地告诉司机,Garlic LLM 则需要自己研究发动机、绘制路线,并逐条告诉汽车什么时候点火、转向和换挡。
CPU 侧的工作相对传统:分词器、用户界面、文字渲染和音频管线由 C 代码处理;矩阵运算等重负载任务则交给 GPU。模型生成的程序通过内嵌 MicroPython 执行,避免在主机上再部署一套重量级 Python 环境。(github.com)
8GB 内存里,塞下模型、缓存和语音
**Garlic LLM 能跑起来的第二个关键,是对每一百兆字节内存都进行了精打细算。**PS4 拥有 8GB GDDR5 统一内存,但系统和应用本身会占用一部分空间,开发者无法把全部容量交给模型。
未经压缩的 9B 模型如果使用 FP16 权重,仅参数就需要约 18GB 内存,远远超过 PS4 的可用空间。Garlic LLM 因此没有直接采用常见的 GGUF 文件,而是针对自己的 GCN Kernel 设计了 Q4 和 Q3 两种权重格式。
**量化是用更低位数保存模型参数,从而降低内存占用和计算成本的技术。**Garlic LLM 对大部分矩阵和输出头使用 4 位权重,对每层 MLP 中体积最大的 gate、up projection 矩阵使用 3 位权重;算上缩放参数后,Q3 部分平均约为每个权重 3.5 位。
这种混合设计把 Qwen3.5-9B 的主权重文件控制在 4.32 GiB。项目文档显示,如果全部使用 Q4,模型还会额外占用约 384 MiB,而 PS4 已经没有足够的空闲内存。
**16K 上下文能够保留下来,则依赖 4 位注意力缓存。**上下文越长,KV Cache 的内存占用越高,很多显存紧张的本地模型即使能加载权重,也会在长对话中迅速耗尽空间。Garlic LLM 将注意力缓存同样量化至 4 位,才让 16K Token 的上下文窗口进入 PS4 的内存预算。
| 组件 | 文件大小 | 作用 | |---|---:|---| | Qwen3.5-9B Q4/Q3 权重 | 4.32 GiB | 文本生成与推理 | | MTP Head | 0.20 GiB | 推测解码加速 | | Parakeet TDT 0.6B v3 | 0.33 GiB | 语音转文字 | | Chatterbox 第一阶段 | 0.29 GiB | 语音合成 | | Chatterbox 第二阶段 | 0.09 GiB | 语音合成 |
这些组件最终被打包进一个 5.66GB 的 PKG 安装包。用户需要准备约 6GB 可用空间;如果先把安装包复制到 PS4 内部硬盘再安装,则需要预留约 12GB。(github.com)
MTP 把旧 GPU 的利用率榨了出来
**Garlic LLM 达到 31—39 Token/s 的直接加速器,是 Qwen3.5 自带的多 Token 预测头。**多 Token 预测(Multi-Token Prediction,MTP)是一种让模型提前草拟多个后续 Token,再由完整模型批量验证的生成技术。
传统自回归生成每次通常只预测一个 Token。GPU 完成一次计算后,必须等待该 Token 被确认,才能继续计算下一个 Token;这种串行依赖会让拥有大量并行计算单元的 GPU 吃不饱。
Garlic LLM 会通过 MTP Head 向前草拟最多两个 Token,然后让完整模型在一次前向计算中进行验证。如果草稿正确,系统就能一次接受多个 Token;如果草稿错误,则退回正常生成结果。
**推测解码的意义不是减少模型能力,而是减少生成相同文本所需的完整前向次数。**这套方法尤其适合代码等可预测性较强的内容,因为变量名、括号和常见语法结构往往更容易被提前猜中,这也是代码生成速度能够冲到 43 Token/s 的一个合理解释。
项目数据还提供了一个很直观的对照:启用语音模式后,文本模型速度下降至约 22 Token/s。原因不是语音播放拖慢了文字输出,而是 Chatterbox 语音模型占用了原本留给 MTP 加速的数据和内存空间,推测解码无法维持相同配置。(github.com)
它不仅能聊天,还能听、说和执行代码
**Garlic LLM 已经具备一个离线语音助手的基本闭环。**用户可以通过 PS4 识别的普通麦克风输入语音,Parakeet TDT 0.6B v3 负责将语音转换成文字;模型生成回答后,Chatterbox 再将文本合成为语音。
语音识别支持 25 种欧洲语言,语音回答支持英语、西班牙语、葡萄牙语、俄语、意大利语、法语和德语等 7 种语言。全部模型都在主机本地运行,音频和对话内容不会为了推理而上传到远程服务器。
**Python 模式让这台游戏机从聊天终端变成了一个封闭的计算环境。**Qwen3.5-9B 可以生成 MicroPython 程序,并在 PS4 上直接执行;演示场景中,模型能够编写绘图程序并在主机端运行结果。
思考模式则允许模型在回答前先进行推理。该功能默认关闭,因为普通问答没有必要额外消耗约半分钟的思考时间,但对于数学题、逻辑题和分步骤任务,它提供了比直接回答更完整的推理空间。
这不是最便宜的 AI 设备,但很有启发
**Garlic LLM 并不会让 PS4 立刻成为最值得购买的本地 AI 主机。**二手 PS4 的价格确实不高,但它功耗较大、破解和安装存在门槛,模型目前也不是任意替换的通用运行环境。
用户不能像使用 llama.cpp 那样,随手下载一个 GGUF 文件就切换到其他模型。Garlic LLM 的权重格式、GPU Kernel 和内存布局都是围绕 Qwen3.5-9B 定制的,模型转换和部署需要专门工具链。
**43 Token/s 也不能直接代表模型回答质量。**速度只说明系统能够快速生成 Token,最终效果仍由 Qwen3.5-9B 本身、量化损失、提示词和上下文决定。一个 9B 模型可以胜任聊天、摘要和轻量编程,但不能与更大的云端前沿模型在复杂推理、长链路工具调用和专业知识覆盖上等量齐观。
此外,项目依赖 GoldHEN 和特定固件环境,安装相关工具需要用户自行承担风险。Garlic LLM 本身不包含破解漏洞,但它只能在已经具备自制软件运行条件的 PS4 上使用。
旧硬件的真正机会,是专用推理栈
**Garlic LLM 最值得行业关注的结论,是旧 GPU 并没有想象中那么快失去 AI 价值。**大量旧设备的问题并不是浮点算力完全不足,而是缺少适合现代模型的驱动、低位 Kernel、内存管理和推理框架。
当开发者不再追求一个框架兼容所有模型,而是围绕固定模型、固定硬件和固定场景做纵向优化,十多年前的 GPU 也能给出可用结果。Garlic LLM 实际上走了一条与游戏主机优化相同的路线:硬件配置不变,但开发者可以通过更低层的控制,把理论性能尽可能转化为实际帧率——或者在这里,转化为 Token/s。
**这种方案的代价是通用性降低,收益则是单位硬件性能显著提高。**它更像一台专门运行 Qwen3.5-9B 的 AI 游戏机,而不是一台能够自由部署各种模型的 Linux 服务器。
未来值得观察的方向包括 PS4 Pro 原生模式、更高效的 3 位矩阵计算、更多模型转换支持,以及局域网调用能力。GitHub 当前文档显示,项目代码已加入兼容常见聊天接口的服务模式,但 1.19 安装包尚未包含该功能,需要等待后续版本发布。对于开发者来说,一旦这部分稳定,PS4 才可能从独立聊天应用进一步变成可被其他设备调用的局域网推理节点。(github.com)
**Garlic LLM 不是本地 AI 硬件的标准答案,但它证明了一件事:推理效率仍有大量空间藏在框架以下。**当行业习惯用更大的显存、更贵的 GPU 解决问题时,一个个人开发者通过量化、手写命令和模型原生 MTP,把 9B 模型塞进十三年前的游戏机,并跑到 43 Token/s——这比“PS4 也能聊天”的猎奇标题更有价值。
参考来源
- Garlic LLM GitHub 项目:项目源代码、安装要求、GPU Kernel、量化格式、MTP 和性能数据说明。
- Garlic LLM for PS4 - Hugging Face:1.19 版本安装包、文件大小、模型组件与 SHA-256 校验信息。
- IT之家:Garlic LLM 可让越狱 PS4 运行 9B 参数本地 AI 模型:11 月 17 日中文报道及主要性能信息。