米哈游 Gamer:只看画面也能玩游戏
米哈游公布通用游戏智能体 Gamer,仅通过屏幕画面生成原生键鼠操作,并借助持续预训练、长时程强化学习和 Streaming-vLLM 完成 2D、3D 游戏任务。
11 月 17 日,米哈游《崩坏》系列 AI 研发团队公布通用视觉语言动作基础模型 Gamer,目标是让一个模型仅通过观察屏幕画面、读取任务指令和操作键鼠,自主完成 2D 与 3D 游戏中的长时程任务。
Gamer 最值得关注的地方,不是它又在某个游戏里刷出了高分,而是它把游戏智能体从“为单个环境定制的机器人”,向“使用人类通用交互界面的视觉控制模型”推进了一步。模型不需要读取角色坐标、敌人血量、任务状态等游戏内部数据,也不依赖专用控制 API;从推理侧看,它拿到的主要是屏幕图像、任务描述、近期操作和压缩后的长期记忆,输出的则是普通键盘与鼠标指令。(github.com)
视觉语言动作模型(Vision-Language-Action,VLA)是把视觉感知、语言理解和动作控制统一到同一模型中的智能体模型。 如果说普通视觉语言模型的终点是回答“画面里发生了什么”,那么 VLA 的终点是决定“下一步应该按哪个键、鼠标往哪里移动”。
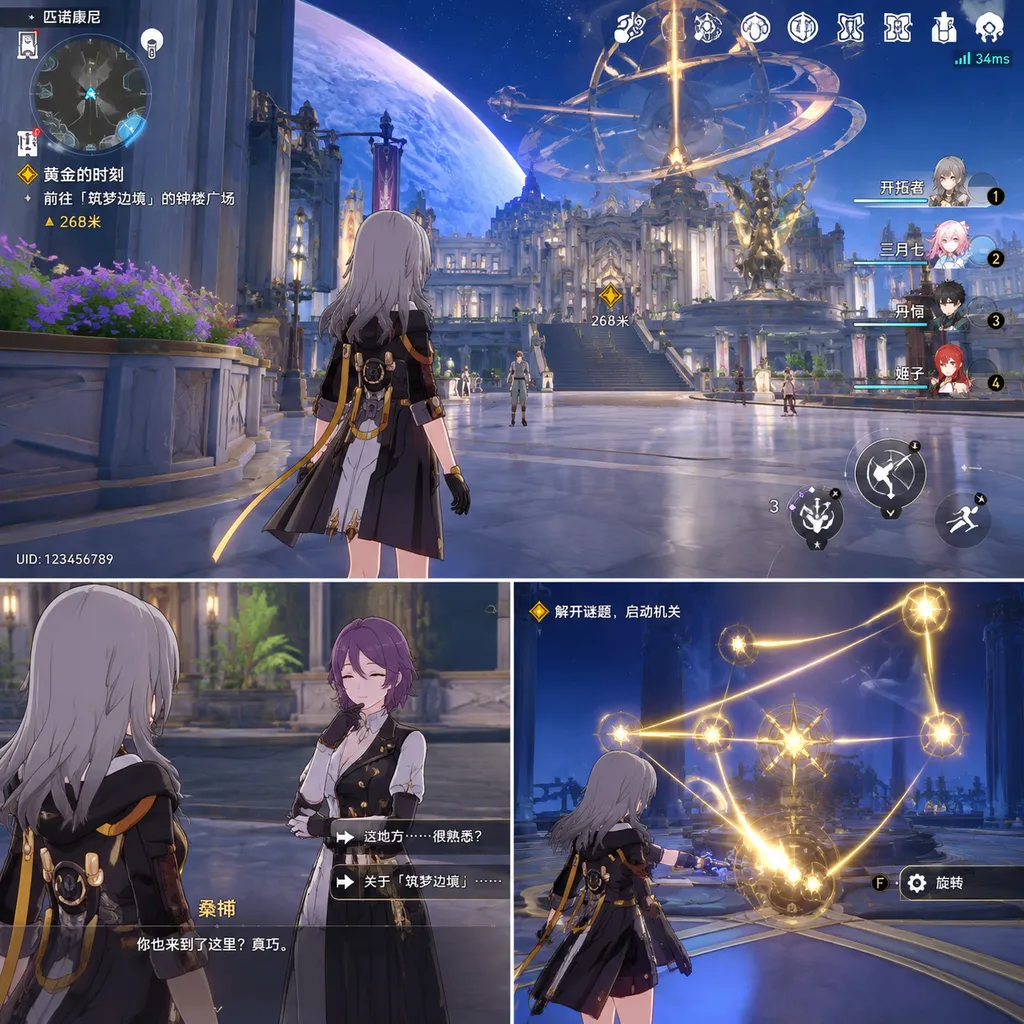
它不是在看攻略,而是在直接操作游戏
Gamer 的运行方式更接近一个坐在电脑前的真人玩家,而不是调用游戏后台接口的自动化程序。系统以约 5 Hz 的频率获取游戏画面,即每秒观察大约 5 次;模型每次生成覆盖约 200 毫秒的动作块,其中包含 6 组间隔约 33 毫秒的键盘状态,并附带鼠标位移、滚轮和按键操作,最终形成约 30 Hz 的原生动作频率。(ithome.com)
这种“低频观察、高频动作”的设计解决了一个现实问题:大模型不可能像传统游戏引擎那样,每一帧都重新完成一次视觉编码和长文本推理。Gamer 的做法是每看一次画面,就提前规划接下来约 200 毫秒的连续动作,相当于真人看清方向后,会持续按住 W 键向前走,而不是每隔 33 毫秒重新思考一次是否还要前进。
Gamer 的动作空间也被刻意设计成跨游戏通用格式。公开文档列出了 74 个大小写敏感的动作标记,覆盖字母键、数字键、F1 至 F12、方向键、鼠标左右键、Shift、Ctrl、Space、Enter 等常见输入;鼠标位移则用相对于屏幕宽高的千分比表示,从而减少不同分辨率带来的差异。(github.com)
这套接口的价值在于,它不要求每款游戏重新定义一套机器可读动作。只要游戏仍然使用键鼠交互,模型理论上就能沿用同一套输出协议,把“向前移动”“旋转视角”“点击对话选项”和“释放技能”统一成可执行动作。
不过,“仅凭画面”并不意味着整套训练系统完全接触不到游戏内部状态。Gamer 的策略模型在实际操作时不读取特权状态,但训练环境仍可使用引擎侧信息初始化任务、判断任务是否完成并计算强化学习奖励;换句话说,考试时模型只能看屏幕,出题和判卷系统仍然可以查看标准答案。(github.com)
真正困难的是连续玩一个小时
长时程游戏智能体是能够跨越大量连续观察和操作,持续记住任务进度并纠正错误的交互模型。 与识别一张截图相比,完成一条游戏任务链要困难得多:模型可能先接取任务,经过对话和传送,再进行战斗、寻找道具、解谜,最后回到指定地点提交任务。
长时程任务的第一个敌人是上下文窗口。游戏每秒产生多张画面和几十个动作,如果把所有历史记录原样塞进模型,上下文很快就会被用完,推理成本也会持续上升;如果简单删除旧记录,模型又可能忘记已经拿到什么物品、在哪条路失败过,以及当前任务进行到哪一步。
Gamer 引入了持久化记忆摘要,把“已完成目标、失败尝试、剩余计划”等信息压缩后跨上下文保留。模型不需要永久保存每一张截图,而是像玩家写任务笔记一样,记住真正影响后续决策的状态。
稀疏思维则用于控制模型什么时候需要推理。普通移动、持续攻击等场景可以直接输出动作;只有画面发生明显变化、旧策略失效或出现新目标时,模型才生成推理内容,再决定下一组操作。这个机制本质上是在减少“边走直线边写小作文”的无效计算。(github.com)
三阶段训练:先学会用手,再学会做任务
Gamer 的训练管线分为持续预训练、稀疏思维指令微调和在线强化学习三个阶段,而不是直接把通用视觉模型扔进游戏里反复试错。
| 训练阶段 | 使用的信号 | 主要解决的问题 | |---|---|---| | 持续预训练(CPT) | 跨游戏画面与设备级键鼠轨迹 | 建立画面、环境变化和动作之间的基础映射 | | 稀疏思维指令微调(SFT) | 操作级、子目标级和任务级指令,以及推理与记忆标注 | 学会理解目标、选择推理时机并维护长期记忆 | | 时序感知强化学习(TA-GRPO) | 在线交互轨迹和可验证环境反馈 | 改进长任务执行、错误恢复与跨阶段信用分配 |
持续预训练阶段使用了超过 1 万小时的设备级键鼠交互轨迹,数据横跨游戏和模拟具身环境。这里学习的不是某一款游戏的攻略,而是更底层的控制先验,例如画面向左旋转通常对应鼠标横向移动、角色靠近障碍物时继续前进可能导致碰撞,以及菜单高亮变化意味着当前选项已经切换。(github.com)
稀疏思维指令微调阶段负责把“会动”升级成“知道为什么动”。官方披露的自动化标注管线生成了约 120 万条推理标注和约 22.3 万条记忆标注,用于训练模型识别关键决策点,并在上下文压缩前提炼任务状态。(huggingface.co)
TA-GRPO 是面向长时程交互设计的时序感知强化学习方法。传统强化学习容易把最终成功或失败平均归因给整段轨迹,但一小时任务中的关键失误可能只发生在某个解谜步骤;TA-GRPO 将由记忆摘要连接的多个轨迹片段纳入训练,让奖励更准确地回传到影响结果的阶段。
强化学习把小游戏成功率推到 49.7%
Gamer 的公开结果显示,持续预训练让模型具备基础操作能力,但任务级监督和在线强化学习才是长任务性能的主要来源。
| 测试项目 | Gamer-CPT | Gamer-SFT | Gamer-RL | |---|---:|---:|---:| | Opportunity Makes the Thief(第一部分) | 34.4% | 72.2% | 80.0% | | Bestial Ferocity | 47.9% | 69.1% | 83.6% | | 40 个未见小游戏实例,七类宏平均 | 15.0% | 39.2% | 49.7% |
在线强化学习相较 SFT,将两项支线任务的里程碑执行率分别提高了 7.8 个和 14.5 个百分点,并把七类小游戏的宏平均成功率从 39.2% 提升至 49.7%,增加 10.5 个百分点。(github.com)
这些数字需要正确解读。两项支线任务统计的是任务里程碑执行率,并不等于模型能以 80% 以上概率从头到尾零失误通关;49.7% 也是七类小游戏成功率的等权宏平均,而不是全部实例合并后的整体通关率。
结果也没有证明强化学习会让每一种玩法同步进步。公开数据表明,部分小游戏在 RL 阶段提升明显,但也存在个别类型相较 SFT 出现退步;这说明 Gamer 已经能从环境反馈中学习,但距离稳定处理所有陌生规则仍有明显差距。
65.12 毫秒延迟,比单卡基线快约 20 倍
Streaming-vLLM 是 Gamer 为连续实时交互设计的流式推理引擎。 游戏不会因为模型正在思考而暂停,一次超过 1 秒的推理足以让角色撞墙、错过交互窗口,甚至在战斗中直接被击败。
Streaming-vLLM 主要通过持久化 KV Cache、经过验证的有限状态机投机解码、动作块提前发送和多环境并发调度降低等待时间。系统不必每轮重新计算全部历史上下文,也不必等完整回复生成结束;只要第一段动作通过格式验证,客户端就可以先开始执行,后续动作继续生成。(github.com)
在 NVIDIA H200、Qwen3.5-35B-A3B MoE 的测试配置中,端到端单请求延迟从 1306.00 毫秒降至 65.12 毫秒,速度提升约 20.1 倍。
| 推理配置 | 张量并行 | 请求延迟 | |---|---:|---:| | 基线配置 | TP1 | 1306.00 ms | | 完整优化配置 | TP4 | 65.12 ms | | 延迟降幅 | — | 95.0% |
这个结果很亮眼,但不能简单理解为某个软件优化让同一台机器凭空快了 20 倍。完整配置同时使用了 TP4 张量并行和多项累计优化,而基线为 TP1,因此 20.1 倍是整套系统配置的综合提升,不是单一技术的独立收益。(github.com)
实时推理在 Gamer 中也不仅是部署体验问题,而是训练质量问题。动作延迟越大,模型根据旧画面输出的操作越容易与当前环境错位,强化学习收集到的失败轨迹也会混入大量系统延迟造成的噪声;把延迟压到约 65 毫秒,等于同时改善玩家体验、训练数据质量和奖励归因。
Gamer 与 GameScaling 有什么不同
Gamer 不是米哈游团队第一次发布通用游戏操作研究。2026 年 10 月,团队与多所高校研究者已经开源 GameScaling,提供 0.8B、2B、9B 和 27B 四种参数规模、共 8 个模型检查点,用于研究模型规模、数据量和游戏多样性对跨游戏迁移能力的影响。(ithome.com)
Gamer 可以理解为在 GameScaling 的“通用控制预训练”之上,进一步补齐任务理解、长期记忆、在线强化学习和实时推理基础设施。
| 对比维度 | GameScaling | Gamer | 传统游戏脚本 | |---|---|---|---| | 核心目标 | 研究跨游戏持续预训练与 Scaling Law | 完成长时程、实时、多阶段游戏任务 | 自动执行预先编写的固定流程 | | 主要输入 | 游戏画面、近期历史和任务提示 | 游戏画面、任务指令、近期历史和持久记忆 | 坐标、图像模板或预设触发条件 | | 主要输出 | 约 200 ms 的键鼠动作 | 键鼠动作、稀疏推理和记忆更新 | 固定按键、点击或路径 | | 学习方法 | 持续预训练 | CPT、SFT、TA-GRPO | 通常不进行模型训练 | | 长任务能力 | 重点验证基础控制迁移 | 面向对话、探索、解谜和任务链 | 环境稍有变化就可能失效 | | 当前开放程度 | 多个模型权重和评测代码已公开 | 基础研究文件公开,完整权重与引擎尚未全部发布 | 取决于具体脚本 |
GameScaling 的实验还给出了一个重要提醒:在单款游戏上训练更久,不等于模型在所有游戏上都会更强。团队此前发现,使用单一《我的世界》数据继续训练可以提升模型在《我的世界》中的表现,却可能损害其在陌生 3D、2D 和 2.5D 游戏中的迁移能力;相比之下,多游戏混合数据更有利于相似操作机制之间的经验复用。
Gamer 因此更像一套“通用控制基础能力加任务级后训练”的完整方案。持续预训练负责让模型掌握鼠标和键盘这双“手”,SFT 负责教它理解目标并做笔记,强化学习则让它在真实反馈中学会如何把一件事做完。
现在还不能下载一个完整版 Gamer
Gamer 当前的开放状态比“模型正式开源”更克制。官方 GitHub 已公开系统提示词、动作格式、方法说明、演示和 Apache 2.0 许可下的通用代码文档,但 Streaming-vLLM 实现仍标记为 Coming soon。(github.com)
米哈游也没有公开《崩坏:星穹铁道》相关训练数据,以及使用这些数据训练或微调后的完整模型权重。官方给出的理由是数据安全,因此开发者目前可以研究 Gamer 的接口和训练思路,也可以使用此前开放的 GameScaling 模型,但无法在本地完整复现演示中的《崩坏:星穹铁道》版本。(ithome.com)
这种开放边界是合理的。游戏轨迹可能包含尚未公开的任务内容、内部测试环境和可被滥用的自动操作数据;同时,Apache 2.0 只覆盖仓库中的代码与文档,并不自动授予游戏画面、角色素材、商标和第三方游戏资产的使用权。(github.com)
它更像游戏测试员,而不是“万能外挂”
Gamer 最直接的产业价值可能是自动化游戏测试。传统自动化脚本擅长检查确定性的按钮、菜单和数值流程,却很难处理自由移动、镜头变化、战斗、对话分支和动态解谜;视觉智能体可以像真人测试员一样从最终画面操作游戏,用同一套接口反复执行任务,并记录卡死、寻路失败和界面异常。
无障碍辅助是另一个合理方向。模型可以把复杂的键鼠组合压缩为自然语言目标,为行动不便的玩家执行持续移动、镜头控制或重复性操作,但这一方向必须由游戏厂商明确授权,并限制在不破坏公平性的场景中。
“通用游戏智能”则是更长期的研究价值。游戏同时包含视觉感知、因果推断、记忆、规划、快速控制和稀疏奖励,是训练数字世界智能体的高密度环境;一个能在不同游戏中通过统一键鼠接口工作的模型,也更容易迁移到桌面软件、网页、远程设备和模拟机器人环境。
作弊风险同样真实存在。一个能读取画面并自动生成操作的模型,在技术形态上与高级自动化工具存在重叠,因此研究团队明确反对将 Gamer 用于游戏作弊、未经授权访问、安全漏洞利用或破坏游戏公平性的行为。(ithome.com)
OpenAI Hub 观点:它比“AI 会玩游戏”更重要
Gamer 的真正意义,是证明了普通键盘、鼠标和屏幕画面可以成为通用智能体的一套基础接口。相比为每个环境单独开发工具协议,这条路线更笨重、推理成本更高,却也更接近人类面对数字世界的方式。
Gamer 目前还不是可以稳定通关任意游戏的“电子玩家”。49.7% 的未见小游戏宏平均成功率说明它已经跨过随机操作阶段,但面对陌生规则、长时间错误累积和高精度战斗时,可靠性仍不足以替代真人;完整权重和推理引擎尚未发布,也使外部团队暂时难以独立验证官方演示。
但 Gamer 已经把竞争焦点从“模型能不能识别游戏画面”,推进到“模型能否在实时环境中持续行动并完成目标”。如果这条路线继续扩展,游戏厂商未来拥有的可能不只是自动测试工具,而是一套能操作所有数字界面的通用动作模型。
参考来源
- Gamer 官方 GitHub 仓库:包含模型方法、动作协议、评测结果、开放状态及 Streaming-vLLM 技术说明。
- Gamer 论文页面(Hugging Face):收录论文摘要、作者信息及团队公开的训练数据和标注规模。
- IT之家:米哈游公布通用视觉语言动作基础模型 Gamer:报道发布时间、5 Hz 观察与 30 Hz 动作、延迟和开放范围。
- GameScaling 官方 GitHub 仓库:米哈游团队此前发布的跨游戏持续预训练项目及评测代码。
- GameScaling 模型页面(Hugging Face):提供已公开的 GameScaling 模型权重与版本信息。
- IT之家:米哈游团队开源 GameScaling:介绍 0.8B 至 27B 参数版本、训练数据和部署要求。