Gemini让Agent按需找工具
Gemini API 推出 Tool Retrieval,让 Agent 从数百个工具中按需加载参数结构。官方示例中,输入 Token 从 16.4 万降至约 2.37 万,但它并非在所有场景都更省。
Google 今天在 Gemini API 中推出 Tool Retrieval 预览功能,目标是解决 Agent 接入大量工具后,工具定义挤占上下文、拖慢响应并降低选择准确率的问题。
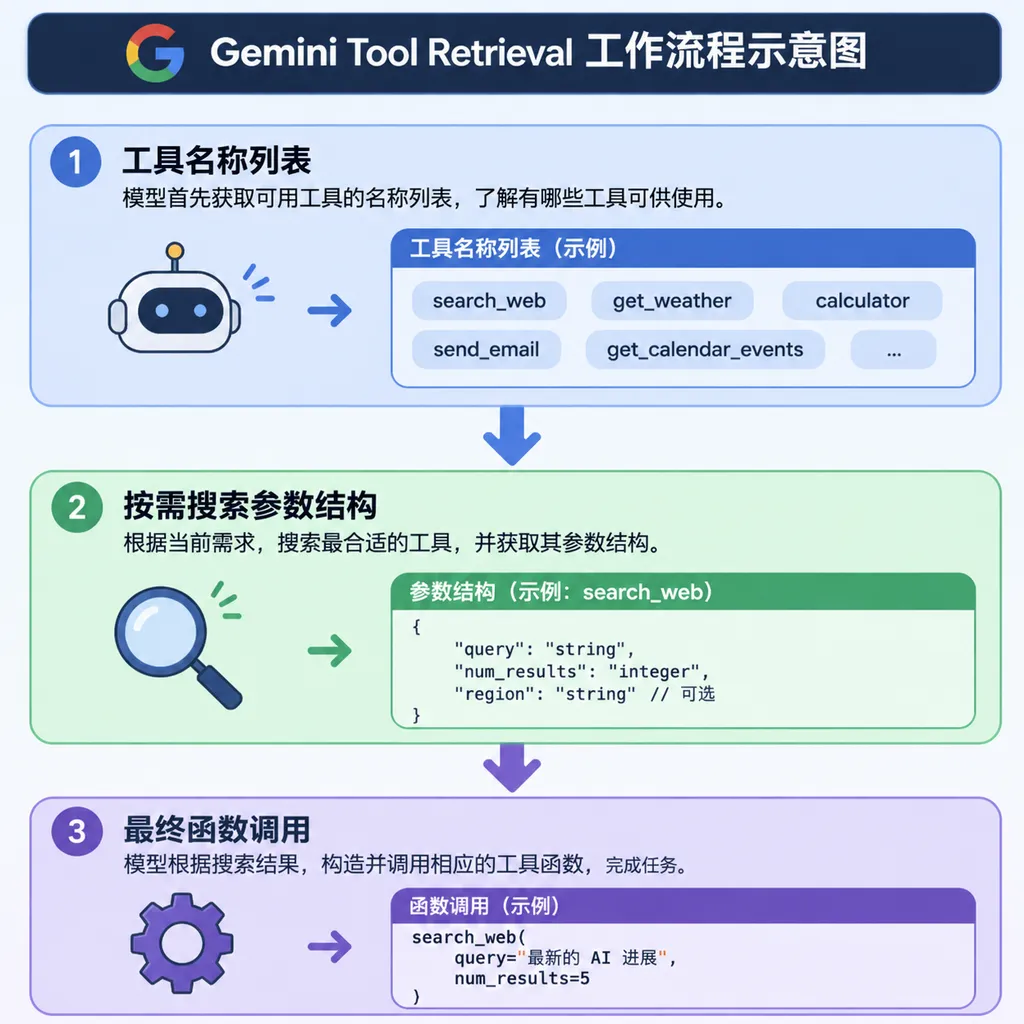
**Tool Retrieval 是一种按需加载工具参数结构的机制。**Agent 不再需要在每次请求中携带全部工具的完整 JSON Schema,而是先看到工具名称和简短描述,真正需要调用某个工具时,再由 Gemini API 加载对应的参数结构。该功能已于 2026 年 11 月 19 日进入预览,目前仅支持 Gemini Interactions API。(blog.google)
这项更新看起来只是少传了一些 JSON,实际解决的却是当前 Agent 工程中一个越来越昂贵的问题:当工具数量从十几个增长到数百个,模型还没开始处理用户任务,输入上下文就已经被工具说明书塞满了。
工具越多,Agent 不一定越聪明
**工具 Schema 是模型调用外部能力时需要阅读的接口说明书。**一个完整 Schema 通常包含工具名称、用途描述、参数字段、字段类型、必填项、枚举值和嵌套对象;复杂企业接口的单个工具定义可能达到数百甚至上千 Token。
传统 Function Calling 的做法,是在每次模型请求中把所有可用工具的 Schema 一次性发给模型。工具只有 5 个或 10 个时,这种方式足够直接;但当 Agent 同时连接 CRM、邮件、日历、数据库、支付、客服和多个 MCP Server 后,工具数量很容易突破 100 个。
Google 在官方文档中指出,几十个函数声明就可能在每次请求中消耗数万 Token,而且候选工具越多,模型的工具选择准确率也会下降。官方给出的经验分界线是:少于约 20 个稳定工具时,静态加载依然简单有效;工具库较大且相对固定时,才更适合使用服务端 Tool Retrieval。(aistudio.google.com)
这也是 Tool Retrieval 最值得关注的地方:它不只是优化账单,还在缩小模型每一步真正需要做出的选择范围。
过去的模型像是每次接到任务,都要先翻完一整本企业通讯录;现在它先看部门和人员简介,确认要找财务后,再打开财务人员的详细联系方式。
Tool Retrieval 到底怎么工作
**服务端 Tool Retrieval 是由 Gemini 在一次 API 请求内部完成工具检索和 Schema 加载的模式。**开发者需要添加一个 tool_search 工具,并为希望延迟加载的函数或 MCP Server 设置 defer_loading: true。
模型初始上下文仍然会包含每个延迟工具的名称和描述,因此它知道系统具备哪些能力,但看不到完整参数结构。当模型判断某项任务需要特定工具时,请求内部会依次产生三个步骤:
tool_search_call:模型提出需要查找的工具名称。tool_search_result:Gemini API 返回匹配工具的完整 Schema。function_call:模型根据 Schema 生成正式调用参数。
服务端检索的关键优势,是前两个步骤发生在同一次 API 请求中,应用程序不需要额外运行向量数据库,也不需要处理一次新的网络往返。开发者仍然只需要执行最终的函数调用,并把执行结果作为 function_result 返回。(blog.google)
**客户端 Tool Retrieval 是由开发者自己的应用负责搜索和筛选工具的模式。**它允许工具不在初始请求中声明,应用可以根据用户身份、权限、租户或新接入的服务,动态返回一组工具定义。
两种模式的差异可以概括为:
| 方案 | 工具如何进入上下文 | 是否需要自建检索 | 每次搜索额外往返 | 适合场景 | |---|---|---:|---:|---| | 静态加载 | 每次发送全部 Schema | 否 | 0 | 少于约 20 个稳定工具 | | 服务端 Tool Retrieval | Gemini 按需加载 Schema | 否 | 0 | 大型、固定的工具库和 MCP Server | | 客户端 Tool Retrieval | 应用返回匹配 Schema | 是 | 1 次 | 权限过滤、多租户、动态工具注册表 |
客户端模式更灵活,但代价也很明确:每次检索都需要应用执行搜索,并通过后续请求把结果交还给模型。对于低延迟助手,服务端模式明显更省事;对于企业内部 Agent,客户端模式则更容易落实权限隔离和审计。
官方示例:16.4万Token降至2.37万
**Tool Retrieval 的 Token 收益取决于工具库规模、Schema 长度、上下文长度和搜索次数。**Google 没有给出一个适用于所有应用的节省比例,而是提供了两组说明性计算,结果正好展示了这项功能的收益边界。
第一组场景包含 200 个工具,每个工具 Schema 为 400 Token,对话上下文为 2000 Token,并需要两次请求完成一次工具调用流程。
| 指标 | 静态加载 | Tool Retrieval | |---|---:|---:| | 工具数量 | 200 | 200 | | 完整工具 Schema | 80000 Token | 按需加载 2 个,共 800 Token | | 两次请求总消耗 | 164000 Token | 约 23650 Token | | 相对降幅 | — | 约 85.6% |
在这个理想的大工具库场景中,Tool Retrieval 将输入及工具使用 Token 从 16.4 万降到约 2.365 万,只剩静态加载方案的 14.4%。(aistudio.google.com)
这个数字足够有吸引力,但不能简单理解为 Agent 成本统一下降 85%。官方计算假设每次任务只需要加载 2 个工具,而现实中的复杂 Agent 可能连续检索多个能力;每进行一次服务端搜索,Gemini 都会在请求内部再次执行一次模型调用,并重新处理完整上下文和已经加载的 Schema。
第二组场景只有 10 个工具,每个工具仍为 400 Token,但对话上下文扩大到 30000 Token。
| 指标 | 静态加载 | Tool Retrieval | |---|---:|---:| | 工具数量 | 10 | 10 | | 对话上下文 | 30000 Token | 30000 Token | | 两次请求总消耗 | 68000 Token | 约 92830 Token | | 成本变化 | — | 增加约 36.5% |
这个反例更重要:当工具库很小、上下文很长,而且请求几乎每次都需要搜索时,Tool Retrieval 反而会多消耗约 2.48 万 Token。(aistudio.google.com)
Google 实际上给出了一个相当诚实的结论:Tool Retrieval 不是默认应该打开的压缩开关,而是一种需要根据流量结构选择的 Agent 架构。
它省掉的是Schema,不是整个上下文
**延迟工具列表仍然会占用输入 Token。**即使参数 Schema 没有进入初始上下文,每个延迟工具的名称和简短描述仍然会作为一行摘要发送给模型。
Google 表示,早期测试中,每个延迟工具的摘要平均约为 26 Token。200 个工具因此仍会产生约 5200 Token 的初始列表,只是远低于官方示例中 80000 Token 的完整 Schema。开发者还可以使用 short_description 单独提供更短的检索描述,避免冗长的函数说明继续挤占上下文。(aistudio.google.com)
**一次服务端工具搜索大致相当于再次处理一遍当前提示词。**搜索产生的额外模型调用会计入 total_tool_use_tokens,其中包括完整上下文、工具搜索说明以及新加载的 Schema;如果同一轮搜索三次,就可能产生三次额外处理成本。
这意味着真正决定收益的不是工具总数,而是下面这个关系:
被省略的 Schema Token,是否大于工具摘要、检索指令和额外搜索调用产生的 Token。
如果一个 Agent 有 300 个长尾工具,但 90% 的任务只使用 3 个高频工具,收益会非常明显。如果一个 Agent 只有 12 个工具,每轮都要从中搜索,而且历史上下文已经达到数万 Token,开启检索可能是在给延迟和账单同时加码。
MCP终于不用一次塞进全部工具
**MCP 是一种让模型以统一方式连接外部工具和数据源的开放协议。**Tool Retrieval 对 MCP 的支持,是这次更新中比函数调用本身更有实际价值的部分。
一个远程 MCP Server 往往会暴露几十个工具,而企业 Agent 可能同时连接多个 Server。此前,这些工具定义需要整体进入模型上下文;现在开发者可以直接在 mcp_server 上设置延迟加载,Gemini 会在需要时检索该 Server 暴露的具体工具,不再要求应用逐个展开并维护工具列表。(blog.google)
这让 MCP 从一个适合演示互操作性的协议,更接近可规模化部署的工具基础设施。过去 Agent 接入更多 MCP Server,通常意味着上下文更臃肿;现在新增一个包含 50 个工具的 Server,初始成本主要来自工具摘要,而不是 50 份完整参数说明。
不过,MCP 工具仍然不是完全免费的。工具被检索并加载后,会留在该对话后续上下文中,后续调用继续按照输入 Token 计费。目前也没有把已加载工具从对话中卸载的机制。
对上下文缓存也更友好
**上下文缓存是复用请求前缀、降低重复输入处理成本的机制。**Tool Retrieval 会把新加载的 Schema 添加在对话后部,而不是改写提示词开头,因此系统指令、工具摘要列表和早期对话仍能保持稳定前缀。
稳定前缀更容易命中 Gemini 的隐式缓存,后续请求以及服务端搜索产生的额外模型调用,都可能以缓存费率处理部分 Token。官方响应中的 total_cached_tokens 字段可以用于观察实际命中情况。(aistudio.google.com)
但这里同样存在反直觉情况:延迟加载让初始提示词变短后,提示词可能低于模型的最低缓存长度,反而无法触发缓存。成本评估不能只看 total_input_tokens,还要同时观察 total_tool_use_tokens 和 total_cached_tokens。
预览版仍有几处明显限制
**Tool Retrieval 目前还是需要针对错误路径进行专门处理的预览功能。**它要求使用 v1beta API,且只在 Interactions API 中可用,传统 generateContent 接口并不支持。
截至 2026 年 11 月 19 日,官方列出的支持模型包括:
gemini-4-hydrogengemini-4-argongemini-3.8-flashgemini-3.6-flash
在不支持的模型上启用 defer_loading 会直接返回 400 错误。(aistudio.google.com)
**已加载的工具会在剩余对话中持续存在。**Agent 不能在完成某个阶段后卸载工具,因此长任务仍可能逐渐积累 Schema,Tool Retrieval 只是放缓上下文膨胀,而不是彻底消除它。
**工具声明仍然需要在每个请求中完整发送。**即使通过 previous_interaction_id 延续对话,Gemini API 也不会自动保存工具声明;开发者需要继续发送完整 tools 数组,只是延迟工具的完整 Schema 不会立即计入模型上下文。
**检索失败没有独立的结构化错误。**如果查询没有匹配任何延迟工具,模型可能直接返回文本,而不是稳定地产生一个表示零结果的 tool_search_result,应用不能把是否出现检索步骤作为唯一判断依据。(aistudio.google.com)
此外,Google 建议不要延迟加载那些在系统提示词中被明确点名的工具。模型可能因为已经看到工具名而绕过搜索直接调用,导致后续请求缺少必要的检索上下文和签名,最终出现 Server side tool call context must be circulated 错误。(aistudio.google.com)
真正的变化是工具选择开始变成检索问题
**Tool Retrieval 把 Agent 的工具调用从全量分类问题变成了检索加执行问题。**以前模型需要在数百个完整 Schema 中直接选择一个函数;现在它先根据短描述缩小候选范围,再读取少数工具的详细结构。
这和 RAG 的演进路径很像:模型不需要把整个知识库放进上下文,只需要检索与当前问题相关的片段。Tool Retrieval 相当于把同样的思路应用到了工具层——检索的不是文档,而是可以执行的能力。
Google 这次更新的方向是对的,而且比单纯扩大上下文窗口更务实。更大的窗口可以容纳更多工具,却不能解决每一轮重复发送、重复计费和候选数量过多的问题;Tool Retrieval 则直接改变工具进入上下文的时机。
但开发者不应该看到 85.6% 的官方示例就立即全量开启。更合理的做法是保留支付、搜索、文件读取等高频工具的静态 Schema,把低频、垂直、参数复杂的长尾工具设置为延迟加载,然后通过真实流量比较三项数据:输入 Token、工具使用 Token和端到端延迟。
如果工具规模已经达到数十甚至数百个,Tool Retrieval 很可能会成为 Gemini Agent 的默认工程选项;如果工具数量不到 20 个,继续静态加载通常更稳定,也更便宜。
参考来源
- GitHub:Gemini Agent 场景中的 Token 消耗案例:社区用户记录长上下文和重复提示词导致 Token 快速累积的实际情况,仅作为成本问题背景。
- 知乎:AI Token 消耗与上下文工程分析:介绍 Agent 循环、上下文重复传输和工具结果对 Token 消耗的乘数效应。