Gemini决策API来了
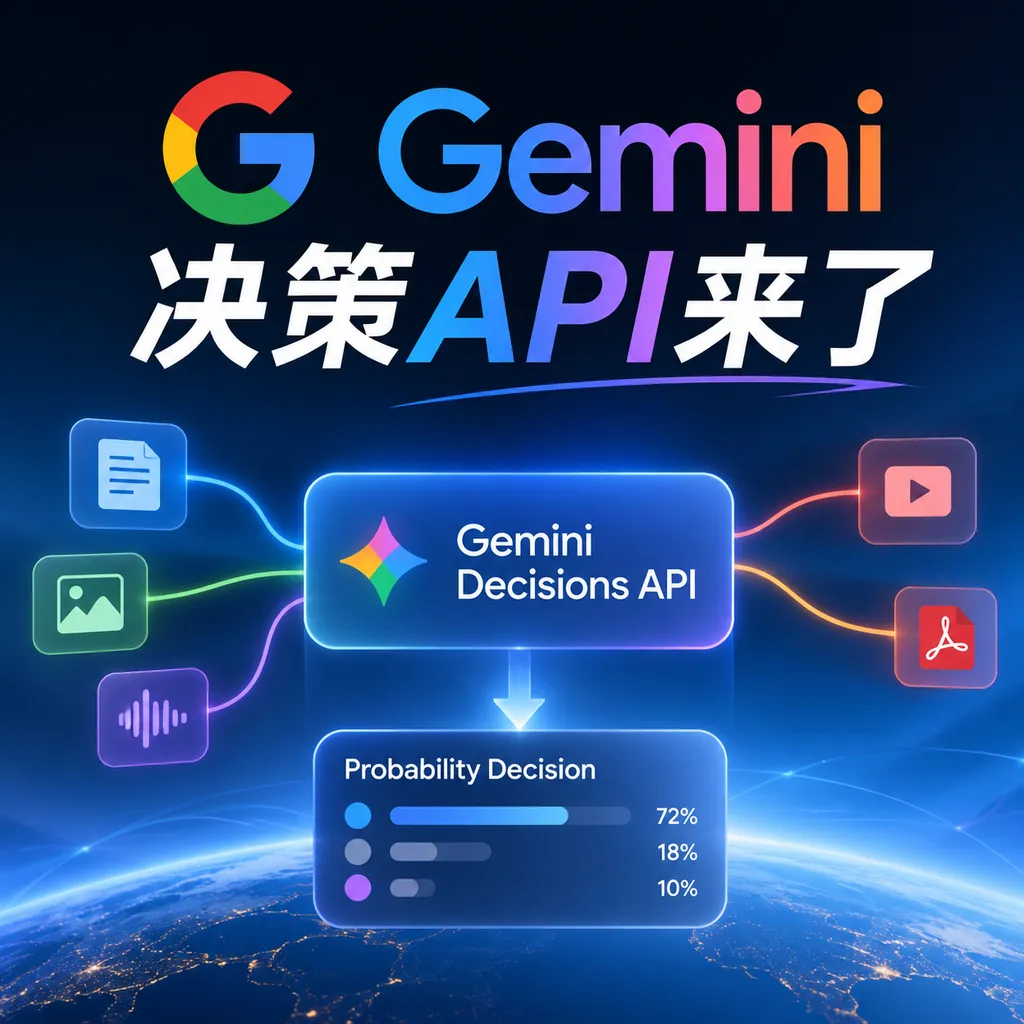
Google推出Gemini Decisions API,用单次前向计算完成多模态分类、评分与路由,端到端延迟150—250毫秒,输入价格为每百万Token 0.10美元。
Google今天正式上线Gemini Decisions API,把过去需要调用通用大模型完成的分类、审核、路由和评分任务,拆成了一个专门追求低延迟、低成本与概率可信度的接口。
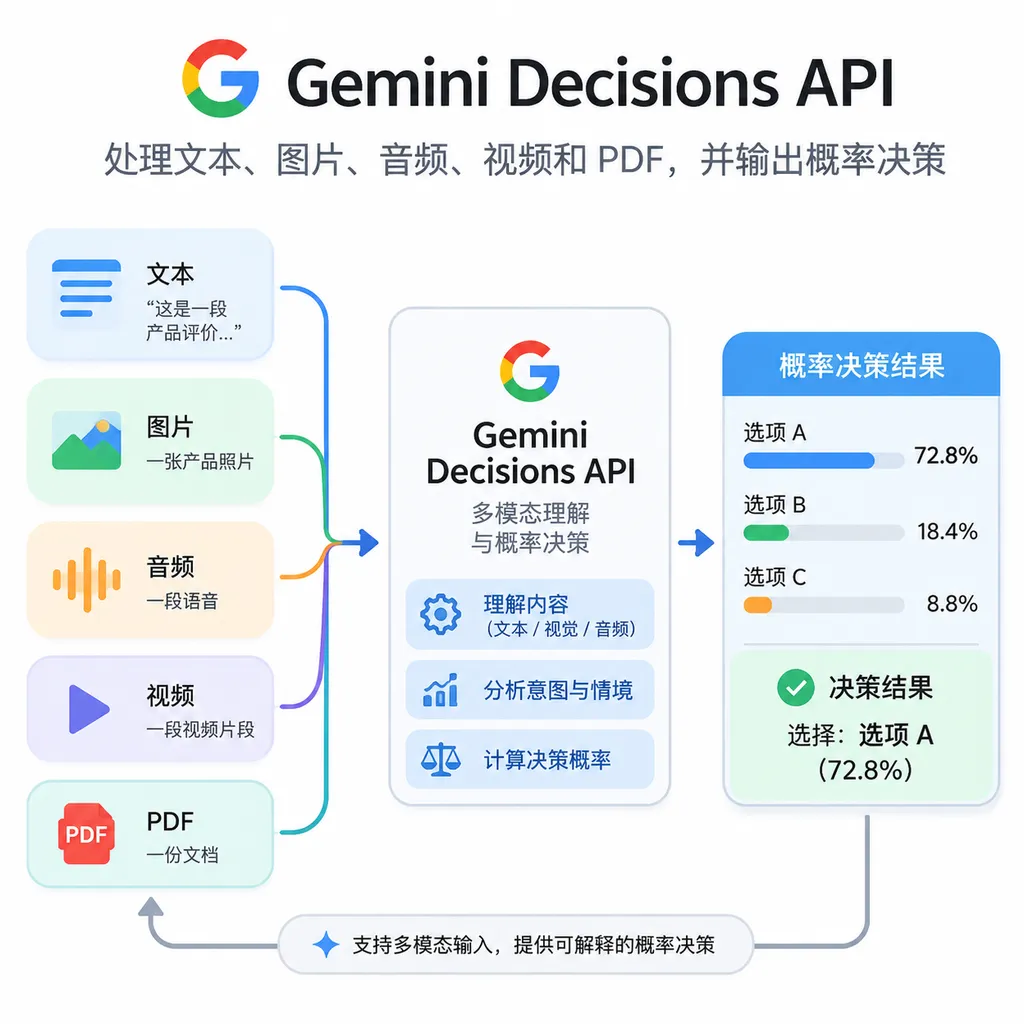
**Gemini Decisions API 是一个面向封闭选项判断的多模态决策接口。**它不负责写文章、解释原因或生成长答案,而是读取文字、图片、音频、视频和PDF,然后从开发者预先定义的选项中给出判断、概率与置信度。
底层模型名为 gemini-decision-1。Google公布的核心指标包括:最多接收256K Token上下文、单次处理最多1000个独立问题、端到端延迟150—250毫秒、输入价格每百万Token 0.10美元,输出Token不收费。Google还称,它在共享基准上的综合成本接近Gemini 3.5 Flash-Lite的五分之一。(reddit.com)
它不是一个“更快的聊天模型”
**Gemini Decision 1 是一个不进行逐Token解码的决策模型。**普通生成模型需要先理解输入,再一个Token接一个Token地组织答案;Gemini Decision 1则直接对候选选项打分,在一次前向计算中输出概率分布。
所谓单次前向计算,是指模型从输入直接计算到结果,不再循环生成几十或几百个输出Token。这个差异类似于让一名质检员直接在检查表上勾选,而不是要求他每检查一个包裹都写一篇情况说明。
这也是150—250毫秒延迟能够成立的关键。Google给出的模型计算中位延迟为50—100毫秒,剩余时间主要来自请求传输、输入处理和服务调度。在不超过16K Token的测试范围内,请求中的问题数量从1个增加到100个,延迟基本保持平稳。
模型:gemini-decision-1
接口状态:Preview
API版本:v1beta
最大上下文:256K Token
单次问题数:最多1000个
端到端延迟:150—250毫秒
模型计算延迟:中位数50—100毫秒
输入价格:0.10美元 / 100万Token
输出价格:0美元
**这种架构解决的不是模型“会不会回答”,而是系统“能不能迅速采取行动”。**在Agent系统中,最常发生的操作往往不是复杂推理,而是判断应该调用哪个工具、是否需要升级到更强模型、输入是否违反规则、检索结果是否相关,以及当前任务是否已经完成。
过去很多团队会让通用大模型输出JSON,再解析其中的标签。这个方案原型开发很快,但规模扩大后会暴露三个问题:生成文字浪费延迟和输出Token;模型偶尔不遵守格式;一个看似确定的标签没有告诉系统这次判断到底有多可靠。
Gemini Decisions API就是针对这三个问题设计的。
三种决策,可以放进同一次请求
**noul 是返回“条件成立概率”的二元判断类型。**它适合检查图片中是否存在损坏、对话是否包含退款意图、工具调用是否违反策略等问题。结果不是简单的true或false,而是一个0到1之间的概率。
**choice 是从2到255个候选项中选择一个结果的多分类类型。**它会返回获胜选项,以及每个候选项归一化后的概率,适合工具选择、模型路由、工单分类和商品识别。
**score 是按照有序标准进行连续评分的量表类型。**开发者可以定义从0开始的多个等级,例如“正常、轻微损坏、严重损坏”,接口会返回各等级概率和加权后的连续分数。
三种问题可以针对同一份输入同时执行。例如,一张快递照片只需上传和计费一次,系统就可以同时判断包装是否破损、包裹放置位置、配送质量等级,以及是否需要转交人工复核。共享输入只计算一次,每个新增问题主要增加问题描述和候选标准所占用的Token。
Google展示的配送质检案例一次处理100张照片,每张照片完成16项检查,总耗时4.5秒,速度接近Gemini 3.5 Flash-Lite方案的4倍。换算下来,这套流程平均每张图片约45毫秒,但这一数字来自批量任务,不代表单次公网请求能够达到相同延迟。(reddit.com)
真正重要的是“可校准”
**概率校准是指模型给出的置信概率与真实正确率相匹配。**如果一个模型对100次判断都给出约80%的概率,那么理想情况下,其中应该有约80次判断正确,而不是只有50次正确。
这比单纯提高准确率更适合生产系统。一个准确率90%、但总是声称自己有99.9%把握的模型,很难建立可靠的人工复核机制;另一个准确率略低、但知道自己什么时候不确定的模型,反而更容易被安全地部署。
开发者可以据此建立分层策略:置信度高于0.95时自动执行,0.70到0.95之间交给更强的推理模型,低于0.70则进入人工队列。阈值并非越高越好,而应该按照误判成本设置。例如,表情选择可以容忍偶尔选错,支付风控和医疗分流则不能采用同一套阈值。
Google称Gemini Decision 1在Agent路由、推理、排序和多模态理解基准上取得了测试套件中的最低校准误差,但目前公开材料没有给出足够完整的逐项原始数据。因此,“可校准”应被理解为一个值得验证的产品能力,而不是开发者可以跳过自有数据评测的保证。
**置信度也不等于事实正确率。**模型遇到训练分布之外的数据、模糊图片、口音较重的录音或设计不清晰的评分标准时,仍可能非常自信地做出错误判断。上线前至少需要检查各类别召回率、误报率、概率可靠性曲线,以及不同输入模态下的性能漂移。
价格足够低,可能改变Agent架构
**每百万输入Token 0.10美元意味着决策层可以从偶尔调用变成默认调用。**如果一次路由请求消耗1000个输入Token,模型成本约为0.0001美元;即使每天执行100万次,理论输入成本也约为100美元,尚未考虑免费额度、问题描述Token和实际上下文差异。
| 方案 | Gemini Decisions API | Gemini 3.5 Flash-Lite + Interactions | 传统分类器 | |---|---|---|---| | 核心用途 | 封闭选项判断 | 通用生成与轻量推理 | 固定类别分类 | | 输入模态 | 文本、图片、音频、视频、PDF | 多模态 | 取决于单独训练的模型 | | 输出形式 | 概率、选项、连续评分 | 生成文本或结构化内容 | 标签或概率 | | 单次问题数量 | 最多1000个 | 通常需要在提示词中组织 | 取决于模型结构 | | 端到端延迟 | 150—250毫秒 | 配送案例中接近慢4倍 | 通常更低 | | 公开成本对比 | 0.10美元/百万输入Token | 共享基准成本接近5倍 | 训练和维护成本不固定 | | 新类别扩展 | 修改候选项和描述 | 修改提示词 | 通常需要重新训练 | | 适合场景 | 路由、审核、排序、质检 | 需要解释和生成内容的任务 | 规则长期稳定的大规模任务 |
Gemini Decisions API并不会取代传统分类器。对于类别稳定、数据充足且调用量极大的任务,一个经过专项训练的小模型仍可能更快、更便宜,也更容易在本地部署。
它真正压缩的是传统分类器的开发周期。过去增加一个新的图像质检标准,可能需要采集数据、标注、训练、部署和持续监控;现在开发者可以先通过自然语言定义候选标准,把数周工作缩短为数小时,再根据业务规模决定是否训练专用模型。
Google把它定位成Agent的控制平面
**Agent控制平面是负责路由、权限检查和执行决策的系统层。**它不直接完成用户任务,而是决定下一步由谁完成、是否允许执行,以及失败后应该走哪条路径。
Google已经在自家产品中使用这套接口。Gemini Notebook使用它判断查询复杂度,再选择模型等级和思考强度,Google称普通查询的延迟最高降低40%;Stitch用它处理语音和点击编辑,让可交互线框图快速响应;Google Labs的CC则从超过200个候选表情中即时选择反应。搜索团队还把它用于MCP工具的对抗行为检测。(reddit.com)
这些案例说明,Decisions API最有价值的位置不是聊天窗口,而是用户看不见的后台。它可以在一次复杂模型调用之前判断是否真的需要推理,也可以在工具执行之后判断结果是否符合要求。
一个合理的Agent链路可能是:先用Decision 1进行意图分类,再把简单任务交给低成本模型,把复杂任务交给推理模型;工具执行前进行权限和策略检查,执行后再检查结果完整性。真正昂贵的生成模型只处理无法用封闭选项解决的问题。
与OpenAI Decisions接口正面相遇
**Decisions API正在从单一厂商功能变成独立的模型接口类别。**OpenAI的官方Python SDK已经提供 POST /decisions 和 client.decisions.create 资源,说明头部厂商都在尝试把“生成答案”和“做出判断”拆成不同产品。(github.com)
Google的差异化优势首先是原生多模态。Gemini Decision 1直接接收视频、音频、图片和PDF,无需分别接入转写、OCR与视觉分类流程;其次是一次输入对应最多1000个问题,这对内容审核、保险理赔和工业质检尤其有用。
但Google目前也有明显限制。该接口仍处于Preview阶段,正式稳定性、区域覆盖、并发限制和企业级服务承诺尚未完全明确;Google Cloud支持也还在推进中。生产环境如果立刻将它放到核心交易链路,需要准备降级模型、规则引擎或人工复核方案。
这次更新值不值得关注
**Gemini Decisions API是一个比“再快一点的Flash模型”更有架构意义的更新。**它承认了一个长期被忽视的事实:大量AI任务根本不需要生成自然语言,它们只需要一个快速、便宜、可度量的不确定性判断。
150—250毫秒延迟、每百万输入Token 0.10美元和零输出Token费用,使它足以进入实时交互路径;多模态输入和最多1000个问题,则让它能覆盖从Agent路由到视频质检的一大批场景。
真正决定成败的仍是校准质量。如果开发者在自己的数据上验证后,发现0.9的置信度确实接近90%的正确率,那么Decision 1会成为非常实用的系统组件;如果概率只是看起来精确,实际却随场景漂移,它就只是一个速度更快的分类提示词。
Google这次至少选对了产品方向:不要让大模型为了回答“是或不是”,先写完一段没有人需要阅读的话。
参考来源
- Google官方NewsFromGoogle账号:Gemini Decisions API发布信息:包含延迟、价格、问题数量、配送质检案例与Google内部应用数据。
- Google Gen AI Python SDK:Google官方Python SDK仓库,可用于核对SDK版本、接口结构与Gemini开发生态变化。
- OpenAI Python SDK Decisions资源:用于确认OpenAI SDK已将Decisions作为独立接口资源提供。