华为开源MACaQ:本地量化提速3倍
华为计算系统实验室开源内部量化工具 MACaQ,可用较低显存量化百亿至千亿参数模型,并覆盖文本、图像、视频和音频推理。
华为开源 MACaQ:本地量化提速 3 倍
华为计算系统实验室(Huawei Computing Systems Lab,CSL)近日开源了 MACaQ,一套面向本地 AI 推理的模型量化工具。论文已于 11 月 7 日公开,项目代码则在 11 月 11 日进入开发者社区视野;团队成员明确表示,MACaQ 是他们过去数月内部使用的量化器,现在以 Apache 2.0 许可证对外开放。
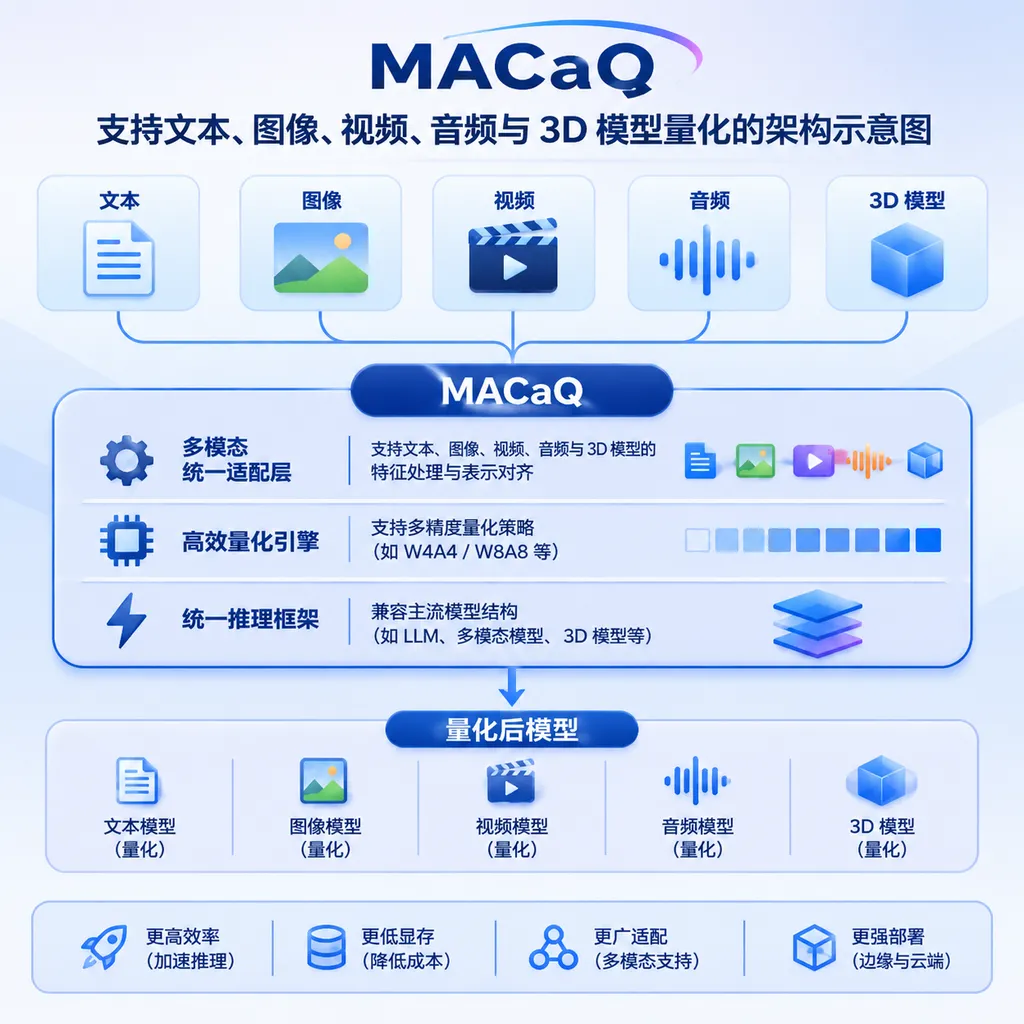
**MACaQ 是一种模型无关、逐线性层处理的后训练量化方法,全称为 Model Agnostic Calibrated Quantization。**它的核心卖点不是又多支持了一种 4-bit 格式,而是试图把量化从“针对每种模型结构单独做工程适配”,变成一套可以跨架构、跨模态复用的流程。
项目目前已经接入 llama.cpp、vLLM、Diffusers 和 PyTorch,覆盖文本生成、图像生成、视频生成、音频生成与语音合成。根据官方披露的数据,MACaQ 可以在约 32.5GB 设备显存下,用 64 分钟完成一个 122B 参数模型的量化;在 Qwen3-32B 的 vLLM 测试中,其解码速度达到 FP16 的 3.06 倍。(arxiv.org)
量化不是单纯把模型“压小”
**模型量化是把模型权重和计算过程从较高精度数值格式转换为较低精度格式,以减少显存占用、内存带宽和计算成本。**例如,将 BF16 权重转换为 4-bit,理论上的权重存储量可以压缩到原来的约四分之一,但模型是否还能正常回答问题,取决于量化算法能否控制误差。
本地推理尤其依赖量化,因为消费级显卡最先遇到的限制通常不是算力,而是显存容量和显存带宽。一个 32B 参数模型仅保存 BF16 权重就需要约 64GB 空间,普通单卡很难完整加载;换成 4-bit 后,权重主体可以下降到约 16GB,但低精度计算也会放大离群值和舍入误差。
**W4A4 是权重和激活值都使用 4-bit 精度的量化模式。**相比只压缩权重的 W4A16,W4A4 不仅减少模型权重的读取量,也能降低矩阵乘法中的激活数据量,因此拥有更高的理论性能上限,但精度控制和内核实现明显更难。
**MXFP4 是一种采用微缩放机制的 4-bit 浮点格式。**MACaQ 使用的 OCP MXFP4 会把数据划分为每组 32 个元素,每组共享一个 E8M0 指数缩放因子,每个元素则使用 E2M1 格式表示。它比传统整数 INT4 更接近浮点数的动态范围,但如何为每一组选择缩放尺度,直接决定了模型会损失多少信息。
MACaQ 真正解决的是跨层耦合
**MACaQ 的关键设计是让每一个线性层独立完成校准、变换和量化。**目前不少高质量量化方法会旋转或缩放激活值,再把逆变换吸收到前一层、归一化层或残差分支中,以避免推理时执行额外操作。
这种做法的效果不错,但工程代价很高。一旦模型使用特殊注意力结构、混合专家路由、并行残差或多模态模块,开发者就必须重新寻找变换可以被吸收的位置。量化算法与模型拓扑深度绑定,换一个架构往往意味着重新适配。
MACaQ 选择了相反的路线:不再努力把所有变换藏到相邻层,而是在当前线性层内部保留一个轻量的在线缩放和块级 Hadamard 旋转。输入进入线性层后先完成变换,再执行 MXFP4 矩阵乘法;对应的逆变换提前吸收到权重中,因此线性层对外的输入输出基底不变。
**Hadamard 旋转是一种用加减法重新分散通道能量的正交变换。**它可以把集中在少数通道中的异常大数值摊开,避免某个离群值迫使整组数据使用过大的缩放尺度。MACaQ 将旋转限制在 32 个元素的块内,正好对应 MXFP4 的微缩放分组,避免离群值被扩散到多个独立量化块。
这个思路可以理解为:传统方案会为了隐藏一根水管,改造相邻房间的墙体;MACaQ 则接受在本房间内增加一个很短的接口,从而不再触碰其他房间。它牺牲了一点运行时开销,换来了模型适配、显存占用和量化速度上的简化。
论文测得,这部分在线缩放和旋转在 Qwen3-32B 上只增加约 2.3% 的端到端开销。在线变换的计算量随输入维度增长,而后续矩阵乘法还会随输出维度增长,因此模型和线性层越大,这部分成本占比越低。(arxiv.org)
Flip-Refinement:不重算,只改最值得改的 4-bit 数值
**Flip-Refinement 是 MACaQ 提出的一种 Hessian 感知坐标下降优化方法。**初始量化完成后,它不会重新优化整组权重,而是判断每一个 FP4 编码向相邻可表示数值移动后,能让线性层输出误差减少多少。
MACaQ 首先通过校准数据统计线性层输入的 Hessian 信息,用于估计不同权重误差对输出的影响。随后,每一轮只为每个输出行选择收益最高的一次数值调整;如果某一行不存在能够继续降低误差的调整,该行就提前退出优化。
这是一种相当务实的工程取舍。它不追求在庞大的低精度组合空间里寻找全局最优解,而是从廉价的就近舍入结果出发,连续修正最不合理的编码。每次修改后的梯度还可以增量更新,不需要重新执行完整矩阵运算。
在 Llama-3-8B 的消融实验中,普通就近舍入的 WikiText-2 困惑度为 8.28;加入 Hessian 指数搜索后降到 8.09,加入微旋转后降到 7.65,加入通道缩放后降到 7.08,最终叠加 Flip-Refinement 后降到 6.87。作为参照,FP16 模型的困惑度是 6.14。
精度比速度数据更有说服力
**MACaQ 的价值不只是量化快,而是在相同 W4A4 格式下取得了更低的困惑度。**困惑度越低,通常意味着语言模型对测试文本的预测分布越接近原始模型,但它并不等于真实对话、代码或推理能力。
论文在统一的 OCP MXFP4 W4A4 条件下,对 Llama 与 Qwen 系列进行了测试:
| 方法 | Llama-3-8B WikiText-2 ↓ | Llama-3-8B C4 ↓ | Qwen3-32B WikiText-2 ↓ | Qwen3-32B C4 ↓ | 主要取舍 | |---|---:|---:|---:|---:|---| | FP16 | 6.14 | 9.46 | 7.62 | 12.45 | 精度基准,显存和带宽成本最高 | | QuaRot + GPTQ | 7.65 | 12.62 | 8.46 | 13.42 | 使用旋转与 GPTQ 补偿 | | MR-GPTQ | 7.13 | 11.37 | 8.15 | 13.27 | 面向微缩放格式优化 | | DuQuant++ + GPTQ | 7.17 | 11.66 | 8.07 | 13.15 | 跨层处理较复杂 | | MACaQ | 6.90 | 11.01 | 7.94 | 12.93 | 保持逐层独立,推理时保留轻量变换 |
MACaQ 在这四项指标中均优于论文选择的其他量化基线,但仍未完全追平 FP16。这个结果比较可信的地方在于,它没有把“精度无损”当作宣传口号,而是明确展示了不同模型和数据集上的退化幅度。(arxiv.org)
生成任务上的差距同样不大。Qwen3-32B 在 IFEval 上的 FP16 成绩为 83.60%,MACaQ 为 83.20%;MATH-500 从 97.78% 降至 97.26%。对于 Qwen3.5-35B-A3B,MACaQ 的 IFEval 为 85.42%,与 FP16 的 85.29% 基本处于同一区间,MATH-500 则从 99.38% 降至 98.90%。(arxiv.org)
122B 模型可以在一张 96GB 卡上完成量化
**MACaQ 的流式量化机制让模型不必以完整精度一次性装入 GPU。**它可以从主机内存逐层加载权重,只把当前正在处理的线性层和必要的校准数据放到设备中。
在 Qwen3.5-122B-A10B 上,完整 FP16 权重约占 244GB,显然无法放入一张 96GB GPU。MACaQ 的量化过程峰值仅使用 32.5GB GPU 显存,耗时 64 分钟,使用 51.2 万个校准 Token 和 32 轮 Flip-Refinement。
量化后的模型占用约 74GB GPU 显存,可以直接在同一张 96GB GPU 上运行。其 WikiText-2 困惑度从全精度模型的 5.06 上升到 5.14,绝对变化为 0.08。(arxiv.org)
这组数据对本地推理团队比单纯的 Token/s 更重要。许多量化工具默认原始模型能够完整进入 GPU,导致“量化一个大模型”本身需要比“运行量化后模型”更昂贵的机器。MACaQ 把峰值显存压到 32.5GB,意味着开发者可能用一张高显存工作站卡完成原本需要多卡服务器的预处理工作。
推理最快达到 FP16 的 3.06 倍
**MACaQ 在 Qwen3-32B、batch 1 场景中的解码速度从 FP16 的 22.8 Token/s 提升至 69.8 Token/s。**这一结果对应 3.06 倍加速,并已经包含在线缩放和旋转的成本。
在 batch 256 下,Qwen3-32B 的聚合解码吞吐从 FP16 的 3061.5 Token/s 提升到 5252.8 Token/s,提升约 71.6%。Llama-3-8B 在 batch 1 下则从 93.2 Token/s 提升到 227.9 Token/s,约为原来的 2.45 倍。
| 模型与场景 | FP16 | MACaQ W4A4 | 加速比 | |---|---:|---:|---:| | Qwen3-32B,batch 1 解码 | 22.8 Token/s | 69.8 Token/s | 3.06× | | Qwen3-32B,batch 256 解码 | 3061.5 Token/s | 5252.8 Token/s | 1.72× | | Llama-3-8B,batch 1 解码 | 93.2 Token/s | 227.9 Token/s | 2.45× | | Llama-3-8B,batch 128 解码 | 7566.8 Token/s | 11158.3 Token/s | 1.47× |
这些数字也说明,量化加速并不是固定倍数。低并发解码通常受显存带宽限制,压缩权重后的收益最明显;随着 batch 增大,计算单元利用率上升,不同内核、调度和硬件格式的差异会逐渐成为瓶颈。(arxiv.org)
不只是语言模型,Diffusers 才是亮点
**MACaQ 的差异化能力是同一套逐层量化逻辑可以迁移到图像、视频和音频模型。**仓库目前为 Diffusers 提供了 FLUX.2-klein-4B、Wan2.2-TI2V-5B 和 Stable Audio DiT 的适配,也通过 PyTorch 支持 Qwen3-TTS 与 Chatterbox Turbo。
在 FLUX.2-klein-4B 上,MACaQ MXFP4 与官方 NVFP4 量化版本进行了同提示词、同随机种子的配对比较。MACaQ 的 LPIPS 为 0.218,低于 NVFP4 的 0.235;SSIM 为 0.697,高于后者的 0.676;DINO 全局特征相似度为 0.882,也略高于 NVFP4 的 0.878。
两种方案的峰值显存分别为 13.1GB 和 13.3GB,而原始 BF16 模型为 18.5GB。MACaQ 每个权重的实际存储成本约为 4.25 bit,NVFP4 约为 4.5 bit。至少在论文给出的 800 组 GenEval2 提示词中,MACaQ 用更少的位数取得了更接近 BF16 的结果。(arxiv.org)
现在还不能把它当成通用量化工厂
**MACaQ 当前更像一套质量很高的研究型工具,而不是已经完成所有生态适配的通用产品。**项目要求 Linux 和 Python 3.12,不同后端需要分别创建环境;llama.cpp 量化模型需要使用仓库附带的分支,不能保证直接交给任意上游版本运行。
vLLM 路径当前重点支持 Qwen3、Qwen3.5 及部分 Qwen、OLMoE 混合专家模型。对于 MoE,MACaQ 主要量化路由专家的投影层,注意力、共享专家、路由器、归一化层、Embedding 和输出头仍保留原始精度。
昇腾支持也处于早期阶段。仓库已经给出 W4A4 稠密矩阵和分组矩阵乘法对应的 CANN 算子实现,但官方说明仍然写得很清楚:完整模型执行还需要与昇腾推理运行时进一步集成。换句话说,这次开源首先交付的是量化方法、CUDA 路径与多个上层框架的可运行工作流,而不是一套已经打磨完成的昇腾端到端方案。(github.com)
MACaQ 对小模型也未必占优。论文显示,在 0.6B 参数模型上,在线缩放与旋转的额外开销会上升到约 8%。层越小,矩阵乘法本身的计算量越少,固定的预处理成本就越难被摊薄,因此 MACaQ 更适合数十亿参数以上、线性层较大的模型。(arxiv.org)
华为开源的不是又一种 GGUF,而是一种降低适配成本的思路
**MACaQ 最值得关注的部分,是它把“模型无关”放在了极致性能之前。**它主动接受约 2% 的大型模型推理开销,换取每个线性层完全独立、逐层流式处理,以及文本与生成式多模态模型之间的代码复用。
对于只想下载现成 GGUF 文件的个人用户,MACaQ 短期内不会直接改变使用体验;对于需要量化自有微调模型、私有模型或新架构的团队,它可能明显减少工程工作。尤其当模型大到无法以 BF16 装进单卡时,32.5GB 峰值显存量化 122B 模型的能力,比又一个理论上的 4-bit 精度指标更有现实意义。
MACaQ 也反映出本地推理工具链的新竞争方向:模型效果差距缩小后,量化速度、校准成本、硬件兼容性和新架构适配周期正在成为真正的门槛。谁能让一个刚发布的模型在几小时内完成高质量量化,并同时进入 llama.cpp、vLLM 和 Diffusers,谁就更有机会掌握开源模型落地的入口。
截至 2026 年 11 月 11 日,MACaQ 仓库仍处于发布初期,提交数量和社区验证样本都不算多。它给出的论文数据足够漂亮,但能否处理更广泛的 Llama、Qwen、DeepSeek、Mistral 及自定义多模态架构,仍要看后续适配速度和第三方复现。
参考来源
- MACaQ GitHub 仓库:项目代码、后端支持范围、安装要求、性能数据与 Apache 2.0 许可证说明。
- MACaQ 论文页面:论文摘要、发布时间、作者信息,以及华为 CSL 团队关于内部使用和开源计划的说明。
- MACaQ llama.cpp 使用文档:GGUF、CPU 与 CUDA 量化及本地运行支持情况。
- MACaQ vLLM 使用文档:W4A4、权重量化、MoE 模型和推理服务支持范围。
- MACaQ Diffusers 使用文档:图像、视频和音频生成模型的量化适配列表。