Gemma 3脑内有地图,却不会看
一项最新预注册研究发现,Gemma 3能从纯文本构建可解码的二维空间地图,但回答问题时绕过了这张地图,反而依赖更脆弱的句子级编码。
Gemma 3把地图画出来了,但回答时走了另一条路
Gemma 3被发现能够在内部构建准确的空间地图,但它生成答案时未必会读取这张地图。11月13日,一项针对Gemma 3 12B和27B的独立预注册研究公开:研究者用纯文本描述物体之间的位置关系,发现模型隐藏状态中存在可线性解码的二维坐标;然而,无论复制、移动还是擦除这些坐标,模型答案几乎都不受影响。(reddit.com)
这个结论听起来有些反直觉。模型明明已经算出了正确位置,为什么回答时还会出错?
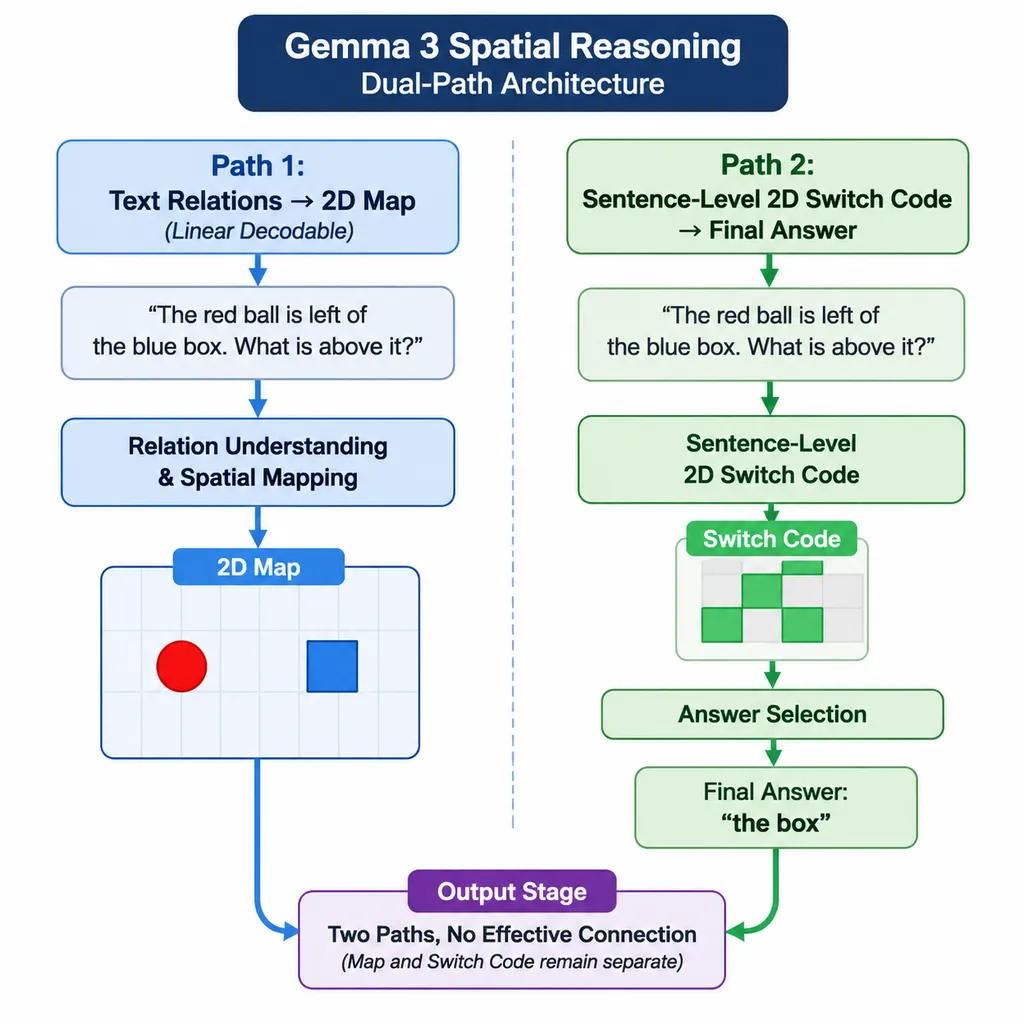
研究给出的答案是:Gemma 3内部可能同时运行着两套空间信息处理路径。一条路径把多个句子组合成接近坐标系的全局地图,另一条路径则把每个位置陈述压缩成一个类似“选择开关”的二维代码。真正控制输出的是后者,而不是更完整、更准确的地图。
线性可解码空间地图是指,研究者可以用简单的线性模型,从大模型的隐藏激活中还原物体的二维坐标。 它不意味着模型真的像人一样“看见”了一幅图,但意味着位置关系已经以结构化形式存在于神经网络内部。
这项研究最值得关注的地方,不是证明Gemma 3空间推理不够强,而是再次击中了大模型可解释性研究中的一个核心问题:能从模型内部读出某种信息,不等于模型真的使用了这种信息。
实验不是让模型看图,而是让它读“文字地图”
这项实验使用的是纯文本空间布局,而不是Gemma 3的视觉能力。典型输入类似于:“Ana在Bo以北3个单位,Cy在Ana以东2个单位”,随后询问“Cy是否比Bo更靠北”“哪个物体离Bo最远”等问题。
文本空间布局是用自然语言定义物体坐标关系的测试任务。 它可以排除图像编码器和视觉特征的影响,直接观察语言模型能否把离散句子组合成统一的几何表示。
问题的难点在于,部分答案不能从单个句子直接获得。要确定Cy相对Bo的位置,模型必须先理解Ana相对Bo的位置,再叠加Cy相对Ana的偏移,这相当于完成一次两步坐标变换。
研究者首先筛选了8个开放权重模型,包括Qwen3 1.7B至14B、Llama 3.2 3B,以及Gemma 3 4B至27B。Gemma 3 12B是其中最小的、能够在不输出书面推理过程的情况下稳定完成三物体任务的模型,整体准确率约为76%;Gemma 3 27B则被用于复现实验结论。(github.com)
Gemma 3是Google推出的一组开放权重多模态模型,提供1B、4B、12B和27B等规模。其中4B、12B和27B版本支持图像输入、128K上下文和超过140种语言;本次研究测试的是12B与27B指令模型。(huggingface.co)
探针确实读出了一张准确地图
线性探针是一种用简单回归或分类器读取神经网络隐藏信息的方法。 如果线性探针能够从某层激活中预测物体坐标,说明坐标信息至少以相对规整、容易读取的形式存在于该层表示中。
实验显示,Gemma 3 12B在前11层几乎没有可读取的统一坐标;到了第12至13层,坐标信号迅速出现,并在第21层达到峰值,坐标预测的决定系数R²为0.74,置信区间为0.72至0.75。随机标签、初始层和随机模型等对照实验的R²均为0。(github.com)
更关键的是,探针不仅能读取直接陈述的位置,也能读取需要组合两个句子才能得到的位置。两步关系物体的坐标读取成绩为0.74,与一步关系物体的0.76几乎相同;如果只根据描述该物体的单个句子猜测,两步物体的基线R²只有0.22。
距离信息也不是简单复制句子中的数字。研究者尝试从隐藏状态预测物体到根节点的距离,两步物体的R²达到0.62;而把两个句子中的偏移量机械相加,基线R²为-0.05。这意味着Gemma 3至少在某个内部位置完成了跨句组合,并形成了比原始文本更完整的几何状态。
从这一结果单独看,很容易得出一个诱人的结论:Gemma 3拥有“内部世界模型”,它先在脑内画图,再根据地图回答问题。
但后续因果实验几乎把这个解释完全推翻了。
地图可以被擦掉,答案却基本不变
因果使用是指,修改某个内部表示会以可预测的方式改变模型输出。 如果模型真的依赖空间地图回答问题,那么移动地图中的某个物体,相关答案应该同步改变;擦除地图,则应该显著降低正确率。
研究者先进行了激活替换:把一个场景中某个物体的隐藏状态,替换为另一个场景里该物体的状态。结果在390组测试中,答案跟随地图变化的比例为0%。替换问题中的物体名称激活,同样没有效果。
研究者随后沿着探针识别出的X轴和Y轴方向移动隐藏状态,移动幅度覆盖正负5个单位。在268组按照几何关系必然应该改变答案的测试中,只有2%的答案真的发生了翻转。
最有说服力的实验是擦除。研究者使用迭代零空间投影,把线性探针能够读取的坐标方向从模型激活中移除,使地图的R²从最高约0.69下降到不超过0.09。结果是,擦除空间地图造成的性能损失,并不比擦除相同维度的随机方向更大。
这一现象在更复杂的四至五物体场景中仍然成立。此时问题最多需要串联四层位置关系,Gemma 3 12B在深层链式问题上的原始准确率约为65%,随机猜测约为36%,说明任务仍有明显的下降空间。但擦除地图带来的最大额外损失只有2.3个百分点,远低于研究预先设定的10个百分点有效阈值。(github.com)
换句话说,这张地图不是模型回答问题的“工作内存”。它更像后台悄悄生成的一份高质量中间文件,内容正确,却没有接入最终业务流程。
真正控制答案的是一个二维“开关”
分布式对齐搜索(DAS)是一种寻找低维因果子空间的方法。 它不是只问“能不能读出信息”,而是寻找一组隐藏方向,测试交换这些方向的数值能否控制模型行为。
研究发现,在物体列表中寻找地图控制子空间几乎失败,DAS干预成功率只有7%。但在直接描述物体位置的句子中,研究者找到了一个二维子空间:交换这两个维度,Gemma 3 12B有72%的相关答案随之改变,Gemma 3 27B达到83%,随机二维子空间则为0%。
| 干预或读取方式 | Gemma 3 12B | Gemma 3 27B | 说明 | |---|---:|---:|---| | 坐标线性探针峰值R² | 0.74 | 未作为主要复现实验报告 | 地图可被准确读取 | | 复制物体列表中的地图表示 | 0% | — | 答案不跟随地图变化 | | 沿坐标方向移动激活 | 2% | — | 坐标方向几乎不控制输出 | | 物体列表位置的DAS | 7% | — | 全局地图因果作用很弱 | | 句子位置的二维DAS | 72% | 83% | 句子级代码能控制答案 | | 随机二维子空间 | 0% | 0% | 排除普通扰动效应 | | 从地图解码回答链式问题 | 80% | — | 高于模型自身的73% |
这个二维代码并不像连续坐标,更像在两个候选布局之间切换的开关。当研究者把代码设置在两个场景的中间值时,模型很少给出几何上位于中间的答案:12B只有8.5%,27B只有5.5%,甚至低于14.1%的随机机会水平。
模型更常见的行为是突然跳向场景A或场景B,而不是让物体平滑移动到两者之间。研究者进一步发现,该代码与句子中距离数值的线性关系R²只有0.31,没有超过随机方向的95%分位数0.35。
这解释了为什么二维代码虽然能控制答案,却不能被直接称为坐标。它保留了“使用哪条位置陈述”的决策信息,但没有稳定表达“物体具体位于哪里”。
模型更相信眼前句子,而不是自己算出的全局状态
Gemma 3的答案路径明显偏向局部句子,而不是全局地图。注意力阻断实验显示,禁止问题部分读取存放地图的物体列表,准确率变化最多只有1.8个百分点;禁止读取物体自己的位置句子,相关问题的准确率则下降35至41个百分点。
这一差异主要出现在第16至31层,说明模型在生成答案前,会回头读取问题涉及物体的原始句子,但很少访问已经整合好的坐标表示。
模型对关系链的使用也不完整。假设存在“根节点R→中间物体M→目标物体C”的链条,回答C相对R的位置需要同时使用M和C的偏移。研究发现,阻止问题读取M的句子,只让涉及C和R的问题下降2.7个百分点。
另一个对照更直观:当C自身的句子发生变化时,模型有39%的答案正确更新;当C的最终位置发生相同变化、但变化来自父节点M的移动时,正确更新比例只有21%。在后一种情况下,72%的答案完全没有改变。
这说明模型给“物体自己的句子”分配了更高权重,却只部分吸收上游关系。局部捷径通常足以应付简单问题,但链条一长,误差就会逐层暴露。
没被使用的地图,反而答得更好
研究者直接从第21层隐藏状态解码每个物体的坐标,再用确定性的几何规则计算答案。这个外部读取器没有让模型重新推理,只是把模型内部已经存在的地图转换成最终结果。
在300个新场景、5350个问题上,地图读取器在需要链式组合的C对R问题中取得80%的准确率,高于Gemma 3自身的73%,提升7个百分点。对于不需要链式组合的问题,地图读取器与模型自身基本打平,分别约为91%对89%、90%对90%。
这7个百分点并不算巨大,却揭示了一个比跑分更重要的问题:模型内部最准确的表示,不一定是最终输出所依赖的表示。
研究者还尝试强行增加问题对地图位置的注意力权重,但没有提高链式问题准确率。较强的注意力偏置反而全面伤害性能,因为它打断了模型原本读取句子级代码的路径,却没有建立从地图到答案的新计算接口。
注意力在这里更像网线,而不是翻译器。即使让问题“看见”地图,如果后续网络不知道如何解释坐标,这张地图依旧无法直接变成答案。
这项研究真正挑战的是“探针即理解”
这项工作的价值在于,它用因果实验给线性探针降了温。过去几年,研究者已经从大模型中读出地理坐标、时间周期、棋盘状态、真假命题和用户信念等结构化信息,这些结果经常被概括为模型形成了“世界模型”。
但“世界模型”至少应该满足两个条件:内部状态能够忠实描述外部环境,并且该状态实际参与预测或决策。Gemma 3在这项实验中满足前半句,却没有满足后半句。
研究因此给出了一套更严格的判断标准:
- 先证明信息可读。 探针需要超过随机标签、随机模型和简单复制基线。
- 再证明信息可控。 修改表示后,输出应按照目标变量发生一致变化。
- 最后证明信息必要。 擦除表示应比擦除随机方向造成更明显的性能损失。
- 对照局部捷径。 必须检查模型是否在依赖单个句子、关键词或模板规律。
按照这个标准,Gemma 3确实构建了空间地图,但这张地图更接近“伴随计算产生的内部副产品”,而不是回答任务的核心推理介质。
对开发者来说,这不是纯学术问题
这项发现对Agent、机器人、游戏NPC和界面操作模型都有直接警示。一个模型可能在隐藏状态中保留了环境位置、任务进度或对象关系,但这不能保证它会在执行下一步动作时使用这些信息。
在仓库导航场景中,模型可能准确编码货架、障碍物和目标点的位置,却继续根据最近一句指令决定转向;在浏览器Agent中,模型可能知道按钮层级和页面结构,却仍然被局部文本提示诱导点击错误元素;在长流程任务中,模型可能保存了正确的全局状态,却在输出阶段走向更短、更熟悉的模式匹配路径。
因此,应用评测不能只检查模型“有没有表示”,还要检查表示是否进入动作链。对于高可靠任务,更现实的方案可能是把隐藏信息显式解码成结构化状态,再交给确定性规划器、规则系统或专门训练的读取模块。
这也给模型训练提供了一个清晰方向:下一步不是继续逼模型“画出更准确的地图”,而是建立从地图到输出的可用接口。轻量微调、辅助损失、状态读取头或几何工具调用,都可能比单纯扩大参数量更有效。
结论仍需谨慎,但问题已经成立
这项研究目前是一份独立预印本,而不是经过同行评审的最终论文。实验范围也有限:只深入测试了Gemma 3 12B和27B,场景主要由三至五个物体、固定语言模板、整数网格和五类问题构成;擦除方法针对的是线性子空间,不能排除模型在其他位置保存了非线性空间信息。(github.com)
研究的可信度主要来自预注册设计和完整公开材料。作者在收集对应实验数据前,将假设、指标和判断阈值提交到Git历史中,并公开了实验代码、结果文件和偏差记录;但项目刚刚发布,GitHub仓库目前关注度很低,仍需要其他团队复现。(github.com)
最稳妥的结论不是“Gemma 3没有空间推理能力”,而是“Gemma 3的空间能力存在表示与读取之间的断层”。它能组合关系、建立坐标,甚至内部地图比最终答案更准确;但生成答案时,模型选择了一条更短、更局部,也更容易出错的路线。
这可能也是理解当前大模型的一个更普遍视角:模型不是不知道,而是知道的信息没有被正确接入输出。