tamserve让SAM 2追踪成本砍半
开源项目 tamserve 把 SAM 2 类模型改造成可长期运行的多摄像头追踪服务,单路成本降低约一半,但“最高提速3.8倍”仍需结合测试条件看待。
tamserve让SAM 2追踪成本砍半
11月13日,开源项目 tamserve 发布了一套面向实时视频流的 SAM 2 类模型服务引擎,试图解决这类模型“短视频演示很惊艳,一接多路摄像头就显存吃紧”的部署难题。项目作者给出的结果是:在一张 RTX 4090 上,tamserve 可让多个摄像头共享同一份 EdgeTAM 或 SAM 2.1 模型,并把单路摄像头的日均计算成本降低约一半。(reddit.com)
**tamserve 是一个为 SAM 2、SAM 2.1 和 EdgeTAM 提供实时、多摄像头推理调度的开源服务引擎。**它不修改模型权重,也不训练新的追踪器,而是重新组织帧、对象记忆和 GPU 计算任务,让原本以“单段录制视频”为中心的研究代码,能够像线上服务一样持续处理摄像头画面。
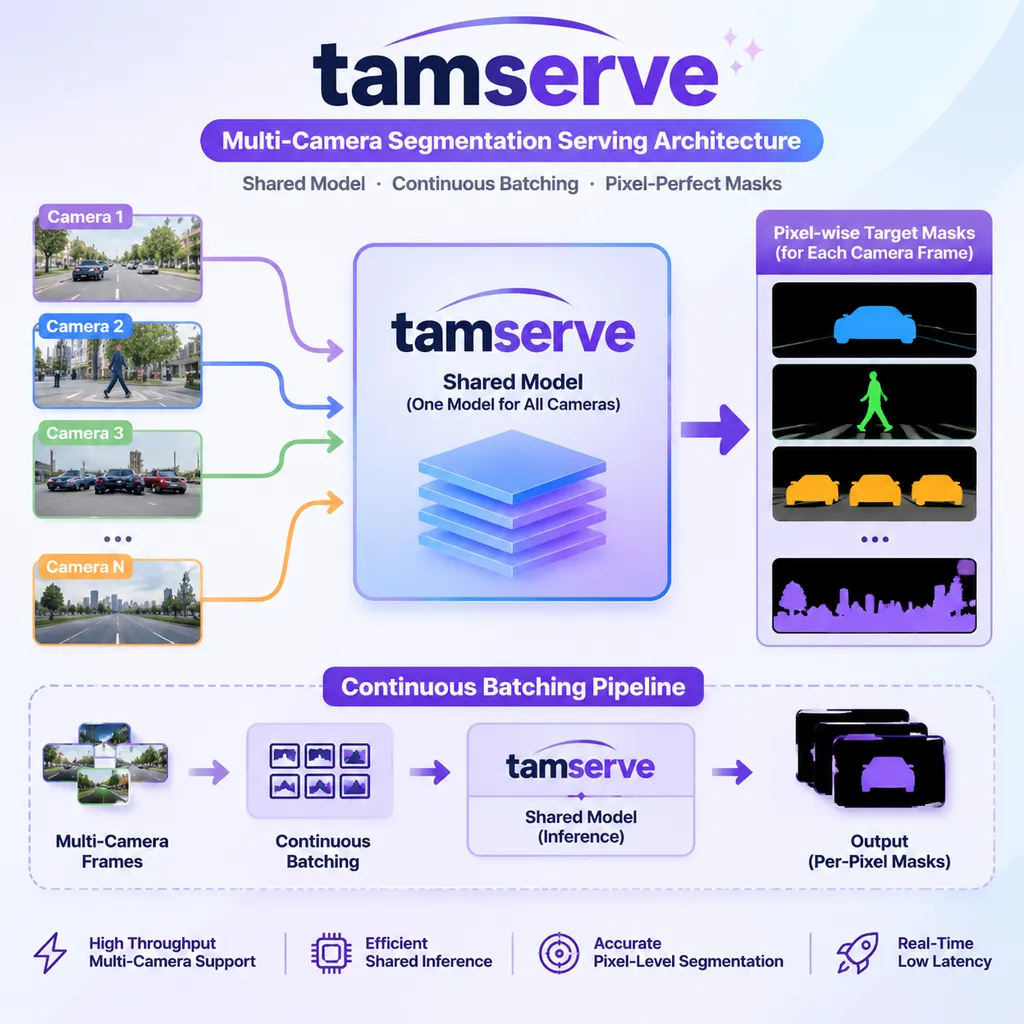
这不是一个新的视频分割模型,而是一层颇有价值的系统工程。用大模型开发者熟悉的说法,tamserve 想做的是视频追踪领域的 vLLM:模型本身不变,但多个请求不再各自占用一整套模型,而是共享权重、动态组批,并只保存推理真正需要的状态。
SAM 2很强,但原始代码并不适合监控流
**SAM 2 类追踪器的核心优势,是输出目标的逐像素轮廓,而不只是一个矩形框。**用户或检测器只需在某一帧中给出一个点、边界框或初始掩码,模型就能在后续帧中传播目标状态,生成连续的 Mask;即便目标形状变化、局部遮挡或发生旋转,结果通常也比传统框追踪器更细致。
这种能力适合视频编辑、机器人视觉、体育转播、仓储分析和实验室监测。例如,普通框追踪只能告诉系统“叉车大致在这个矩形区域”,SAM 2 类模型则能给出叉车在每一帧中的精确像素范围,后续可以直接计算面积、边缘、遮挡关系,或者叠加特效。
**SAM 2 的“实时”更多描述模型推理速度,而不等同于一套可直接运行数月的摄像头基础设施。**Meta 官方实现主要围绕已经存在的完整视频设计,初始化时通常需要提前加载帧,并保存视频帧、预测结果和对象状态;社区此前也多次提出如何接入未知长度直播流,以及长视频缓存持续增长的问题。(github.com)
问题在多路摄像头下会被进一步放大。最直接的部署方式,是为每个摄像头启动一个模型进程;8路画面就是8份模型和8套运行状态,GPU 显存、主机内存和进程调度开销都会近似线性增长。
项目测试显示,EdgeTAM 原始代码处理单个目标时,200帧占用约2.7GB GPU 显存,400帧升至5.1GB,800帧达到9.8GB。tamserve 在相同测试中的占用稳定在0.28GB,没有随着视频长度继续增加;按800帧计算,显存差距达到35倍。(github.com)
tamserve具体改了什么
**tamserve 的关键设计,是只保留模型下一步真正会读取的有限记忆。**项目实现中,每个目标保留提示帧、最近6帧和最近15份摘要,而不是缓存摄像头运行以来的所有帧与输出,因此运行10分钟和运行10天的状态规模不会因为视频长度本身而无限增长。(github.com)
**连续批处理是 tamserve 提升多路吞吐量的主要手段。**传统方式让每个摄像头分别执行图像编码、记忆注意力、Mask 解码和记忆编码;tamserve 则把不同摄像头、不同对象当前需要处理的任务合并成批次,让一次 GPU 前向过程同时服务多路画面。
这种调度逻辑与大语言模型服务非常相似。LLM 连续批处理会把不同对话的下一个 Token 放进同一批计算,tamserve 则把不同摄像头中等待新帧的对象放进同一批计算;每个对象仍读取自己的记忆,不会把仓库摄像头里的叉车和院子摄像头里的狗混在一起。
**tamserve 还针对 GPU 流水线清理了多项隐藏开销。**项目复用了无提示情况下的编码结果,减少 CPU 等待 GPU 队列清空的次数;把帧上传和缩放放在 GPU 上完成;避免为每一帧重复生成相同的位置编码;并针对不断变化的批次大小,提前编译若干个二次幂尺寸的计算图。
GPU 缩放看起来只是小优化,但数据差距并不小。在项目测试环境中,720p 帧在 GPU 上上传和缩放约需0.4毫秒,1080p 约需0.7毫秒;如果按照原始流程在 CPU 上缩放,则分别需要约16毫秒和24毫秒。对于8路甚至16路摄像头,这类数据搬运和同步成本足以成为真正的瓶颈。(github.com)
单路日均成本最低降至0.18美元
**tamserve 公布的成本结论,是根据一张 RTX 4090 能同时容纳多少路摄像头折算得出的容量成本。**这不是某家云平台的固定报价,也不是完整生产环境账单,因此更适合用来判断相对改善,而不是直接写入采购预算。
| 单路处理帧率 | tamserve 每路每天 | Meta/原始实现每路每天 | 成本降幅 | |---|---:|---:|---:| | 30 FPS | 1.07美元 | 2.40美元 | 55.4% | | 10 FPS | 0.36美元 | 0.74美元 | 51.4% | | 5 FPS | 0.18美元 | 0.44美元 | 59.1% |
这组数据基本支撑了“成本减半”的标题。在需要完整30 FPS的场景中,每路每天节省1.33美元;100路摄像头连续运行30天,按同一折算口径计算,月度差额约为3990美元。(reddit.com)
不过,这种测算对利用率非常敏感。如果企业只运行一路摄像头,无法把 GPU 剩余容量分配给其他任务,那么“每路成本”不会因为理论吞吐量提高就自动下降;tamserve 的经济价值主要出现在多路流、长时间运行以及 GPU 能够持续保持较高利用率的场景中。
性能提升没有标题看起来那么简单
**tamserve 宣称最高可比 Meta 原始代码快3.8倍,但公开主测试中的优势通常没有达到这个数字。**Reddit 发布帖使用了“最高3.8倍”的说法,而 GitHub README 中与 EdgeTAM 最快原始配置进行的正面对比显示:单摄像头吞吐量从177 FPS 提升至219 FPS,提升24%;8路摄像头总吞吐量从280 FPS 提升至323 FPS,提升15%。(reddit.com)
| EdgeTAM测试规模 | 原始实现总吞吐量 | tamserve总吞吐量 | tamserve GPU显存 | |---|---:|---:|---:| | 1路摄像头 | 177 FPS | 219 FPS | 1.1GB | | 2路摄像头 | 258 FPS | 286 FPS | 1.3GB | | 4路摄像头 | 294 FPS | 333 FPS | 1.6GB | | 8路摄像头 | 280 FPS | 323 FPS | 2.2GB | | 64路摄像头 | 原始实现未完成测试 | 321 FPS | 5.7GB |
“最高3.8倍”更可能来自特定未优化基线、单项优化阶段或不同运行条件,而不是所有配置下都能稳定复现的普遍结论。对于准备部署的团队,更值得关注的其实不是峰值提速,而是显存曲线从随时间增长变为近似恒定,以及一张卡能够稳定承载更多摄像头。
**SAM 2.1 上的结果进一步说明 tamserve 的强项是资源共享,而不是凭空提高模型计算速度。**在 SAM 2.1 tiny 的编译模式下,单摄像头速度为88 FPS,略低于 Meta 当前代码的91 FPS;8路总速度为91 FPS,与原始实现的89 FPS基本相当,但8路显存从10.0GB降至3.4GB,800帧显存从10.2GB降至0.32GB。(github.com)
这个结果符合系统常识。SAM 2.1 每帧保存的记忆 Token 比 EdgeTAM 更多,单路任务已经能较充分地使用 GPU,连续批处理很难再挤出数倍吞吐量;tamserve 能做的是减少重复模型和冗余缓存,让更多摄像头塞进同一张卡。
精度几乎没有变化
**tamserve 的优化没有以明显牺牲分割精度为代价。**在 DAVIS 2017 验证集上,EdgeTAM 原始实现的平均 IoU 为0.8686,tamserve 编译版本为0.8685;SAM 2.1 tiny 分别为0.8807和0.8806,测试中没有出现原始实现能追踪、tamserve 却丢失目标的帧。(github.com)
| 模型 | 原始实现IoU | tamserve IoU | 丢失目标数 | |---|---:|---:|---:| | EdgeTAM | 0.8686 | 0.8685 | 0 | | SAM 2.1 tiny | 0.8807 | 0.8806 | 0 | | SAM 2.1 small | 0.8850 | 0.8846 | 0 | | SAM 2.1 base+ | 0.8893 | 0.8893 | 0 | | SAM 2.1 large | 0.8919 | 0.8918 | 0 |
这类万分位差异通常来自不同批次尺寸下的浮点舍入,而不是模型能力下降。项目还提供了精确模式,在单摄像头条件下可以生成与原始实现逐比特一致的 Mask,但代价是采用与原始实现一致的 CPU 预处理路径。
它已经考虑了摄像头服务的脏活
**tamserve 不只提供一个推理循环,还补上了多 GPU 路由和摄像头故障恢复。**Router 会把摄像头分配到不同 GPU Worker,汇总各节点输出,并在摄像头断流后按1秒、2秒、4秒的间隔自动重连,最长退避到1分钟。
多机运行同样被纳入设计。项目测试中,两张 RTX 4090 处理32路720p视频时,总吞吐量达到476 FPS;在未达到 GPU 上限时,每路摄像头可以维持30 FPS,Mask 在帧解码后约20毫秒到达 Router。(github.com)
这些功能未必像模型跑分一样吸引眼球,却决定了项目能否离开 Notebook。真实摄像头会断线、卡帧、重连,GPU Worker 也可能崩溃;只展示一段 MP4 的分割结果,与维持数十路 RTSP 视频连续运行,是两种完全不同的工程难度。
tamserve仍然不是完整视觉分析系统
**tamserve 不负责发现或识别目标,它只负责在获得初始提示后持续追踪。**系统仍需要人工点击,或者由 YOLO、开放词汇检测器等上游模型提供边界框;如果需求是“自动找出画面里的所有叉车并分类”,tamserve 不能单独完成。
**tamserve 目前只支持向前追踪,也不支持保留历史状态的精细 Mask 修正。**当追踪发生漂移时,用户可以在当前帧重新指定目标,但旧历史会被丢弃并从当前帧重新开始;对于离线视频编辑,Meta 原始代码支持的双向传播和多帧修正仍然更灵活。(github.com)
**tamserve 的公开性能结果目前主要来自一张 RTX 4090。**测试环境使用24GB RTX 4090、受限至8.8个核心的 AMD EPYC 9354、BF16、PyTorch 2.15和CUDA 13.2;其他 GPU、驱动版本和视频解码方案可能得到明显不同的结果。(github.com)
编译启动时间也是部署成本。最高性能模式首次编译约需20分钟,后续在缓存仍然存在时约需95秒;较快的默认编译模式可在3分钟内完成,但在不同摄像头数量下会损失3%至50%的速度。容器频繁销毁、弹性扩缩容或冷启动敏感的场景,需要预热镜像并持久化 PyTorch 编译缓存。
真正值得关注的是“视觉模型服务层”
**tamserve 最重要的意义,是把视觉基础模型的竞争从模型精度推进到推理服务效率。**SAM 2、EdgeTAM 已经证明了提示式视频分割的能力,但模型能跑并不代表产品能用;如何调度多路视频、控制状态大小、隔离对象记忆、恢复故障和跨 GPU 扩展,正在成为新的基础设施问题。
过去两年,大语言模型生态已经形成 vLLM、SGLang 等专门的服务引擎,视觉模型却仍经常以 Demo 脚本、Notebook 和单视频推理代码交付。tamserve 的思路说明,视频分割也可以通过连续批处理、有限状态和编译图复用,获得类似 LLM Serving 的规模效应。
我们的判断是,tamserve 对单路摄像头用户不是必需品,但对拥有8路、32路甚至更多视频流的开发团队很有吸引力。它没有让 SAM 2 变得更聪明,却让这类模型更接近可计算成本、可持续运行、可跨 GPU 扩展的生产服务;相比“最高3.8倍”的宣传数字,这一点更有长期价值。
项目目前采用 Apache-2.0 许可证,支持 EdgeTAM 以及 SAM 2.1 tiny、small、base+、large,要求 Python 3.10及以上版本和 PyTorch 支持的 NVIDIA GPU。CPU 可以运行,但速度不适合实时视频。(github.com)
参考来源
- tamserve GitHub 仓库:项目说明、架构、性能测试、限制及复现脚本。
- Reddit 项目发布帖:作者公布的成本折算及最高提速数据。
- Meta SAM 2 GitHub 仓库:SAM 2模型、视频预测器和官方推理实现。
- SAM 2实时视频流讨论:社区关于未知长度直播流接入方式的讨论。
- SAM 2长视频内存讨论:长视频缓存、每帧状态增长和内存占用问题。
- Meta EdgeTAM GitHub 仓库:面向设备端和低计算成本场景的轻量级 Track Anything 模型。